Wir haben Cerebras Wafer Scale Engines zusammen mit GPUs eingesetzt, um blitzschnelle Tokens in großem Maßstab bereitzustellen
Die Welt hat Hunger nach ultraschnellen Tokens. Im Jahr 2026 verzeichnete Cerebras eine unstillbare Nachfrage nach schneller Inferenz – sowohl über unsere eigene Inferenz-Cloud als auch über unsere Partner. Um diese Nachfrage zu bedienen, begannen wir mit der Entwicklung einer disaggregierten Inferenz: GPUs übernehmen die Prompt-Verarbeitung (Prefill) und Cerebras-Systeme kümmern sich um die Ausgabeerzeugung (Decode).
Diese Lösung befindet sich nun im Produktivbetrieb und liefert bei gleicher ultraschneller Cerebras-Geschwindigkeit fünfmal mehr Tokens pro Megawatt.
Über die Cerebras Inference Cloud können wir jetzt noch mehr ultraschnelle Tokens bereitstellen, um die Marktnachfrage zu decken. Auch Infrastrukturpartner können die disaggregierte Lösung von Cerebras nutzen, um in ihren eigenen Rechenzentren mehr ultraschnelle Tokens zu erzielen.
Zusammen mit unserem kürzlich vorgestellten CS-4, unserer massiv ausgebauten Fertigungskapazität und den geplanten 700 MW an Rechenzentrumskapazität wird die disaggregierte Inferenz es Cerebras und seinen Partnern ermöglichen, ab 2027 und darüber hinaus deutlich mehr ultraschnelle Tokens bereitzustellen. In diesem Blogbeitrag behandeln wir:
- Den Bedarf an mehr ultraschneller Inferenzkapazität
- Warum Cerebras beim Decode einen Vorteil hat
- Ergebnisse der disaggregierten Cerebras-Inferenz im Produktivbetrieb
- Disaggregierte Cerebras-Inferenz für Infrastrukturpartner
Der Bedarf an mehr schneller Inferenzkapazität
Agentische Anwendungen wie Muse, Copilot und Codex wachsen rasant und erfordern eine hochgradig interaktive Inferenz, um Nutzer bei der Stange zu halten. Um die steigende Nachfrage dieser Anwendungen in einem Umfeld mit begrenzter Stromverfügbarkeit zu befriedigen, muss unsere Branche deutlich mehr Inferenzkapazität pro Megawatt liefern – und das bei Antwortgeschwindigkeiten, die solche Anwendungen erst wirklich nutzbar machen.

Quellen: Goldman Sachs Research, „AI Agents Forecast to Boost Tech Cash Flow as Usage Soars", 20. Mai 2026; Schätzungen zur Rechenzentrumskapazität von Goldman Sachs, wie von Investing.com berichtet
Deshalb hat Cerebras in Disaggregation investiert. Die Kombination eines Prefill-Beschleunigers für die Prompt-Verarbeitung mit dem Cerebras-System für die Antwortgenerierung erhöht den Token-Durchsatz pro Megawatt, während die ultraschnellen Generierungsgeschwindigkeiten von Cerebras erhalten bleiben. Für Inferenzanbieter bedeutet das: mehr Kapazität für die Kundenbetreuung und ein höheres Umsatzpotenzial bei gleichem Strombudget.
Warum Cerebras beim Decode im Vorteil ist
Eine Inferenzanfrage besteht aus zwei Hauptphasen. Die Prompt-Verarbeitung, auch Prefill genannt, verarbeitet die Eingabe und erzeugt einen Zwischenzustand des Modells. Die Antwortgenerierung, bekannt als Decode, nutzt diesen Zustand, um Ausgabe-Tokens zu erzeugen. Es gibt viele Möglichkeiten, die Inferenzlast aufzuteilen – darunter Draft–Target oder Attention–FFN –, doch die Trennung von Prefill und Decode bietet einzigartige Vorteile, wenn das Ziel eine hochgradig interaktive Inferenz ist.

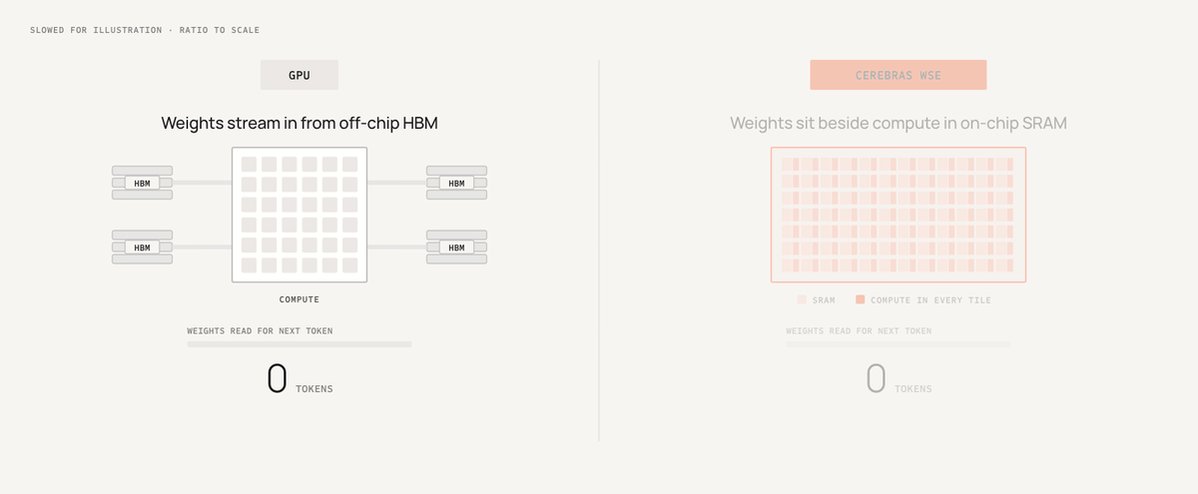
Decode ist autoregressiv. Das bedeutet, dass das Modell jeweils ein Token nach dem anderen generiert und jedes erzeugte Token als Eingabe für das nächste verwendet. Jeder Schritt erfordert ein erneutes Lesen der Modelldaten aus dem Speicher, weshalb die Speicherbandbreite eine entscheidende Rolle spielt. Im Bereich der ultraschnellen Inferenz sind SRAM-zentrierte Chips im Vorteil, da sie diese Daten direkt auf dem Chip halten und wesentlich schneller lesen können. Cerebras hebt dieses Prinzip auf Wafer-Ebene: mit mehreren Dutzend Gigabyte SRAM und zweistelligen Petabytes pro Sekunde an Speicherbandbreite auf einem einzigen Chip – das entspricht der 350-fachen SRAM-Kapazität und der 5.400-fachen Speicherbandbreite einer typischen GB300-GPU. Dadurch kann das Cerebras-System mehr gleichzeitige Anfragen und Modellschichten direkt auf dem Chip unterbringen, was es dem CS-3, CS-4 und CS-5 ermöglicht, ultraschnelle Geschwindigkeiten bei attraktivem Durchsatz zu erreichen.
GIF
Ergebnisse der disaggregierten Cerebras-Inferenz im Produktivbetrieb
Die Kombination von Cerebras-Systemen, die für ultraschnelles Decode optimiert sind, mit Beschleunigern, die sich ideal für die Rechenanforderungen des Prefill eignen – etwa AMD Instinct GPUs –, ermöglicht die Bereitstellung enormer Mengen an ultraschneller Inferenz in großem Maßstab. In einer Produktivumgebung auf der Cerebras Inference Cloud verarbeiten AMD Instinct GPUs die Prompts, während Cerebras CS-3-Systeme die Antworten generieren. Indem die Prompt-Verarbeitung auf GPUs verlagert wird, können Cerebras-Systeme ihre gesamte Serving-Kapazität für die Antwortgenerierung einsetzen. In unserer gemessenen Produktionsumgebung lieferte diese Kombination den fünffachen Durchsatz pro Megawatt im Vergleich zu einer reinen CS-3-Konfiguration – ohne jeglichen Verlust bei der Token-Generierungsgeschwindigkeit.

Quelle: Gemeinsamer GPT-OSS-120B-Endpunkt vom 14. November über die Cerebras Inference Cloud – Durchsatz pro Megawatt vor und nach der Aktivierung der disaggregierten Inferenz, normiert auf den Basiswert der aggregierten Inferenz (1×).
Wir planen, die disaggregierte Inferenz bis Ende 2027 breitflächig über mehrere Hundert Megawatt hinweg in der Cerebras Inference Cloud sowie in Partnerumgebungen einzusetzen. Unser Ziel ist es, die verfügbare ultraschnelle Inferenzkapazität für unsere Kunden weiter auszubauen.
Disaggregierte Cerebras-Inferenz für Infrastrukturpartner
Die disaggregierte Inferenzlösung von Cerebras wurde von Anfang an so konzipiert, dass auch unsere Partner sie übernehmen können. Infrastrukturpartner können Cluster für disaggregierte Inferenz auf Basis der von Cerebras bereitgestellten Referenzarchitektur implementieren und dabei ihre gewählten Prefill-Beschleuniger sowie Cerebras-Systeme in einem einheitlichen Netzwerk zusammenführen. Bei der Softwareintegration haben Partner die Wahl zwischen dem durchgängigen disaggregierten Software-Stack von Cerebras oder einem reinen Decode-SDK.
- Der durchgängige disaggregierte Software-Stack eignet sich am besten für Partner, die ihre Time-to-Market optimieren möchten. Er umfasst:
- Ein Framework für disaggregierte Inferenz, das Anfragen zwischen Prefill- und Decode-Pools routet sowie Replika-Kapazitäten und deren Status verwaltet.
- Eine Prefill-Engine zur Verarbeitung von Prompts mit Open-Source-Inferenz-Engines wie vLLM oder SGLang.
- Eine Cerebras Decode-Engine für die Antwortgenerierung auf Cerebras-Systemen.
- Die KV Portal-Software, eine Schnittstelle zur Übertragung von Zwischenzuständen des Modells – einschließlich Key-Value-Caches – zwischen Prefill- und Decode-Engines über RDMA.
Das reine Decode-SDK richtet sich vor allem an Partner, die maximale Kontrolle wünschen. Mit dem Decode-SDK können Partner ihr eigenes Inferenz-Framework und ihre eigene Prefill-Engine mit der Cerebras Decode-Engine und der KV Portal-Software kombinieren. Darüber hinaus bietet das Decode-SDK Entwicklungshilfen wie ein Mock-Cerebras-Decode-Replikat sowie eine Referenzintegration für ein Open-Source-Framework zur disaggregierten Inferenz und eine Prefill-Engine.

Early-Access-Partner wie Amazon Web Services, Fireworks AI, Gimlet Labs und General Compute haben bereits Zugriff auf die Disaggregation-Lösung von Cerebras für ihre Implementierungen. Nun erweitern wir den Zugang für weitere Partner, die ultraschnelle Inferenz in großem Maßstab zu ihren Kunden bringen möchten.
Wenn Sie die Ergebnisse, Lösungen oder Einsatzmöglichkeiten detaillierter besprechen möchten, kontaktieren Sie uns hier.


