لقد قمنا بنشر محركات Cerebras Wafer Scale Engines مع وحدات معالجة الرسومات (GPUs) لتقديم رموز (tokens) فائقة السرعة على نطاق واسع
العالم متعطش للرموز فائقة السرعة. في عام 2026، شهدت Cerebras طلبًا لا يُشبع على الاستدلال السريع، سواء على سحابة الاستدلال الخاصة بنا أو عبر شركائنا. ولتلبية هذا الطلب، بدأنا في تطوير الاستدلال المُفكَّك: حيث تتولى وحدات معالجة الرسومات (GPUs) معالجة الأوامر (prefill)، بينما تتولى أنظمة Cerebras توليد المخرجات (decode).
هذا الحل قيد الإنتاج الآن ويوفر خمسة أضعاف عدد الرموز لكل ميغاواط بنفس سرعات Cerebras الفائقة.
أصبح بإمكاننا الآن تقديم المزيد من الرموز فائقة السرعة عبر Cerebras Inference Cloud لتلبية طلب السوق. كما يمكن لشركاء البنية التحتية الاستفادة من حل Cerebras المُفكَّك لتحقيق المزيد من الرموز فائقة السرعة داخل مراكز البيانات الخاصة بهم.
إلى جانب نظام CS-4 الذي أعلنّا عنه مؤخرًا، والتوسع الهائل في عمليات التصنيع لدينا، وسعة مراكز البيانات المخطط لها والتي تبلغ 700 ميغاواط، فإن الاستدلال المُفكَّك سيمكّن Cerebras وشركاءها من تقديم عدد أكبر بكثير من الرموز فائقة السرعة في عام 2027 وما بعده. في هذه المدونة، نتناول ما يلي:
- الحاجة إلى مزيد من سعة الاستدلال فائق السرعة
- لماذا تتمتع Cerebras بأفضلية في مرحلة التوليد (decode)
- نتائج الإنتاج للاستدلال المُفكَّك من Cerebras
- الاستدلال المُفكَّك من Cerebras لشركاء البنية التحتية
الحاجة إلى مزيد من سعة الاستدلال السريع
تتوسع التطبيقات الوكيلة (Agentic applications) مثل Muse وCopilot وCodex بسرعة كبيرة، وتتطلب استدلالًا شديد التفاعلية للحفاظ على تفاعل المستخدمين. ولتلبية الطلب المتزايد لهذه التطبيقات في بيئة محدودة الطاقة، يجب على قطاعنا توفير سعة استدلال أكبر بكثير لكل ميغاواط، وبسرعات استجابة تجعل هذه التطبيقات مفيدة حقًا.

المصادر: أبحاث Goldman Sachs، "من المتوقع أن تعزز وكلاء الذكاء الاصطناعي التدفق النقدي لقطاع التكنولوجيا مع ارتفاع معدلات الاستخدام"، 20 مايو 2026؛ تقديرات سعة مراكز البيانات من Goldman Sachs، كما وردت في Investing.com
ولهذا السبب استثمرت Cerebras في التفكيك. إن دمج مُسرِّع prefill لمعالجة الأوامر مع نظام Cerebras لتوليد الاستجابات يزيد من إنتاجية الرموز لكل ميغاواط مع الحفاظ على سرعات التوليد الفائقة التي تتميز بها Cerebras. بالنسبة لمقدمي خدمات الاستدلال، يعني ذلك سعة أكبر لخدمة العملاء وإمكانية تحقيق إيرادات أعلى من نفس ميزانية الطاقة.
لماذا تتمتع Cerebras بأفضلية في مرحلة التوليد (decode)
يتكون طلب الاستدلال من مرحلتين رئيسيتين. معالجة الأوامر، المعروفة باسم prefill، تقوم بمعالجة المدخلات وإنتاج حالة وسيطة للنموذج. أما توليد الاستجابة، المعروف باسم decode، فيستخدم تلك الحالة لتوليد رموز المخرجات. هناك طرق عديدة لتقسيم عبء عمل الاستدلال، بما في ذلك draft–target وattention–FFN وغيرها، لكن فصل prefill عن decode يوفر ميزة فريدة عندما يكون الهدف هو استدلال شديد التفاعلية.

مرحلة decode هي ذاتية الانحدار (autoregressive). وهذا يعني أن النموذج يولد رمزًا واحدًا في كل مرة، مستخدمًا كل رمز تم توليده كمدخل لتوليد الرمز التالي. وكل خطوة تعني قراءة بيانات النموذج من الذاكرة مرة أخرى، لذا فإن عرض النطاق الترددي للذاكرة أمر بالغ الأهمية. في مجال الاستدلال فائق السرعة، تتمتع الشرائح المعتمدة على SRAM بميزة لأنها تستطيع الاحتفاظ بتلك البيانات على الشريحة نفسها وقراءتها بسرعة أكبر بكثير. تأخذ Cerebras هذا المفهوم إلى مستوى رقاقة الويفر (wafer scale)، مع عشرات الغيغابايتات من SRAM وعشرات البيتابايت في الثانية من عرض النطاق الترددي للذاكرة على شريحة واحدة — أي 350 ضعف سعة SRAM و5,400 ضعف عرض النطاق الترددي للذاكرة مقارنة بوحدة معالجة رسومات GB300 النموذجية. يتيح ذلك لنظام Cerebras استيعاب المزيد من الطلبات المتزامنة وطبقات النموذج مباشرة على الشريحة، مما يمكّن أنظمة CS-3 وCS-4 وCS-5 من تحقيق سرعات فائقة بإنتاجية جذابة.
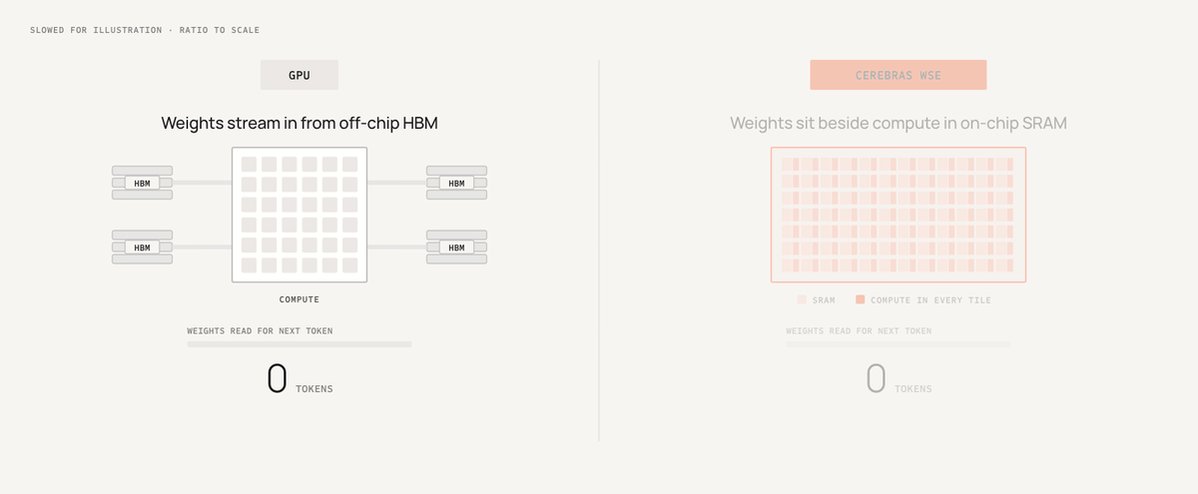
صورة متحركة (GIF)
نتائج الإنتاج للاستدلال المُفكَّك من Cerebras
إن دمج أنظمة Cerebras، المُحسَّنة لعملية decode فائقة السرعة، مع مُسرِّعات مناسبة تمامًا لاحتياجات الحوسبة في مرحلة prefill، مثل وحدات AMD Instinct GPUs، يسمح بتقديم كمية هائلة من الاستدلال فائق السرعة على نطاق واسع. في نشر إنتاجي على Cerebras Inference Cloud، تتولى وحدات AMD Instinct GPUs معالجة الأوامر، بينما تتولى أنظمة Cerebras CS-3 توليد الاستجابات. ونقل معالجة الأوامر إلى وحدات GPUs يسمح لأنظمة Cerebras بتكريس سعة الخدمة الخاصة بها لتوليد الاستجابات. وفي النشر الإنتاجي الذي قمنا بقياسه، حقق هذا المزيج إنتاجية تبلغ 5 أضعاف لكل ميغاواط مقارنة بتكوين يعتمد على CS-3 فقط، دون أي فقدان في سرعة توليد الرموز.

المصدر: نقطة نهاية GPT-OSS-120B المشتركة بتاريخ 14 نوفمبر عبر Cerebras Inference Cloud، وتوضح الإنتاجية لكل ميغاواط قبل وبعد تفعيل الاستدلال المُفكَّك، مع معايرتها بالنسبة لخط أساس الاستدلال المُجمَّع (1×).
نخطط لنشر الاستدلال المُفكَّك على نطاق واسع عبر مئات الميغاواط في Cerebras Inference Cloud وفي عمليات نشر الشركاء بحلول نهاية عام 2027. هدفنا هو زيادة سعة الاستدلال فائق السرعة المتاحة لعملائنا.
الاستدلال المُفكَّك من Cerebras لشركاء البنية التحتية
تم تصميم حل الاستدلال المُفكَّك من Cerebras ليكون جاهزًا لاعتماده من قِبل شركائنا أيضًا. يمكن لشركاء البنية التحتية نشر عناقيد (clusters) استدلال مُفكَّكة بناءً على البنية المرجعية التي توفرها Cerebras، مع وضع مُسرِّعات prefill التي يختارونها وأنظمة Cerebras جنبًا إلى جنب داخل شبكة موحدة. أما فيما يتعلق بالتكامل البرمجي، فيمكن للشركاء التكامل إما مع حزمة برامج Cerebras المُفكَّكة الشاملة أو مع حزمة تطوير برمجيات (SDK) مخصصة لمرحلة decode فقط.
- حزمة البرامج المُفكَّكة الشاملة هي الأنسب للشركاء الذين يسعون لتقليل وقت الوصول إلى السوق. وتتكون من:
- إطار عمل استدلال مُفكَّك لتوجيه الطلبات بين مجموعات prefill وdecode وإدارة سعة النسخ المكررة وحالتها الصحية.
- محرك prefill لمعالجة الأوامر باستخدام محركات استدلال مفتوحة المصدر مثل vLLM أو SGLang.
- محرك decode من Cerebras لتوليد الاستجابات على أنظمة Cerebras.
- برنامج KV Portal، وهو واجهة لنقل الحالة الوسيطة للنموذج، بما في ذلك ذاكرات التخزين المؤقت للمفتاح والقيمة (key-value caches)، بين محركات prefill وdecode عبر تقنية RDMA.
حزمة SDK المخصصة لـ decode فقط هي الأنسب للشركاء الذين يفضلون التحكم الكامل. باستخدام هذه الحزمة، يمكن للشركاء إحضار إطار عمل الاستدلال ومحرك prefill الخاصين بهم لدمجهما مع محرك decode من Cerebras وبرنامج KV Portal. بالإضافة إلى ذلك، توفر حزمة SDK هذه أدوات مساعدة للتطوير مثل نسخة محاكاة (mock) لنسخة Cerebras decode المكررة، وتكامل مرجعي مع إطار عمل استدلال مُفكَّك مفتوح المصدر ومحرك prefill.

الشركاء في مرحلة الوصول المبكر، بما في ذلك Amazon Web Services وFireworks AI وGimlet Labs وGeneral Compute، لديهم بالفعل إمكانية الوصول إلى حل التفكيك من Cerebras لعمليات النشر الخاصة بهم. ونحن نعمل الآن على توسيع نطاق الوصول ليشمل شركاء إضافيين يتطلعون إلى تقديم الاستدلال فائق السرعة لعملائهم على نطاق واسع.
لمناقشة النتائج أو الحلول أو فرص النشر بمزيد من التفصيل، تواصل معنا هنا.


