AI-Video-Storyboard
Texte in Shots für AI-Videos zerlegen
AI-Video-Storyboard
Texte in Shots für AI-Videos zerlegen
Einblicke
Beschreibung
AI-Videos scheitern meist auf zwei Arten: Entweder wird dem Modell nicht klar genug gesagt, was es tun soll (etwa bei „Eine energiegeladene Person begrüßt den neuen Tag“), oder die Person sieht im ersten und zweiten Shot nicht wie dieselbe aus. 【AI-Video-Storyboard】 zerlegt deinen Text in eine Tabelle, die du direkt kopieren und für die Generierung einzelner Shots verwenden kannst. Für jeden Shot werden fünf Punkte ausgearbeitet: Motiv (wer welche sichtbare Aktion ausführt), Umgebung (Inhalte im Vorder- und Hintergrund), Licht (Richtung, Härte und Farbtemperatur), Kamera (Einstellungsgröße, Höhe der Kameraposition und Bewegung) sowie ein Stilsatz (Materialien und Farbgebung). Besonders wichtig sind die „drei Tricks für Konsistenz“: Die Beschreibung der Hauptfigur wird als fester Textblock angelegt und bei jedem Shot unverändert übernommen, nur die Aktion wird angepasst; derselbe Licht- und Szenensatz wird in jedem Shot wiederholt; und zunächst wird das Bild des ersten Frames als visueller Anker festgelegt, bevor das Video-Tool damit gesteuert wird – das ist deutlich wirksamer, als Textprompts immer wieder zu ändern. Zusätzlich gibt es Vorschläge zur Zeitaufteilung und zu Übergängen sowie sechs besonders häufige Fehlerquellen (verzerrte Gesichter bei mehreren Personen im Bild, Verformungen bei schnellen Bewegungen, fehlerhafte Schrift im Bild, falsch dargestellte Hände in Nahaufnahmen, verwaschene reflektierende Materialien und wechselnde Kleidungsfarben zwischen Shots) mit Formulierungen zur Vermeidung. Klare Regeln: Es werden keine Videos erstellt, keine Porträts realer Personen und kein Face-Swapping verwendet, keine Figuren aus bestehenden Cartoons, Animes, Spielen oder Filmen eingebunden, keine lebenden Regisseure oder Künstler namentlich imitiert, keine Minderjährigen oder freizügigen Inhalte erzeugt und keine Anleitung gegeben, generierte Bilder als echte Nachrichtenaufnahmen zu veröffentlichen.
Geeignet für
Für Content Creator, Marketing- und Videofachleute, die Texte in AI-Video-Storyboards und Prompts für einzelne Shots umwandeln möchten.
So nutzt du diesen Skill
Eingabe bereitstellen
Stelle einen Sprechtext, eine Produktbeschreibung oder eine Geschichte bereit und nenne Zweck, Videolänge, Format, Stil, gleichbleibende Motive oder Szenen sowie das verwendete Tool.
Skill ausführen
Zerlegt den Text in eine Shot-für-Shot-Tabelle mit sichtbaren Aktionen, Umgebung, Licht, Einstellungsgröße, Kameraposition, Bewegung und Stil und vereinheitlicht Rollen- und Szenenbeschreibungen.
Ergebnis prüfen
Du erhältst kopierfertige Prompts für AI-Video-Tools, eine Beschreibung des ersten Frames, eine Zeitaufteilung, Übergangsvorschläge und Hinweise zur Vermeidung typischer Bildfehler.
Ähnliche Fähigkeiten
Alle anzeigen
KI-Video- & Storyboard-Prompts
Verwandle Handlungen, Figurenbeschreibungen oder vorhandene Video-Prompts in professionelle Storyboards für KI-generierte Kurzdramen und direkt nutzbare Shot-Prompts. Ob Urban-, Historien-, Mystery-, Romance- oder Rachedrama: Das Skill berücksichtigt Figurenbeziehungen, Erzähltempo und emotionale Hooks und definiert Einstellungsgröße, Kameraposition, Perspektive, Kamerabewegung, Bildkomposition, Licht, Umgebungsgeräusche und Dialoge. So erhält jeder Shot einen klaren visuellen Schwerpunkt und ausführbare Aktionen. Besonderes Augenmerk liegt auf der Konsistenz von Figuren und Szenen. Das hilft dabei, Aussehen, Kleidung, Identität und charakteristische Details festzulegen und Risiken wie Gesichtsveränderungen, Drift, räumliche Inkonsistenzen oder unklare Bewegungen bei der Generierung zu verringern. Auch Blick, Mimik, Atmung sowie Reaktionen von Händen und Körper werden in sichtbare schauspielerische Veränderungen übersetzt, um Konflikte, Druck, Wendungen und die emotionale Steigerung des Kurzdramas zu verstärken. Du kannst mit einer vollständigen Handlung beginnen oder vorhandene Figuren-Assets, Storyboards oder Prompts zur gezielten Optimierung bereitstellen. Bei bereits etablierten Figuren können diese direkt übernommen werden, sodass eine wiederholte Gestaltung entfällt. Anschließend lassen sich die vollständigen Shots in höchstens 15 Sekunden lange Abschnitte aufteilen, die sich für die schrittweise Generierung mit gängigen KI-Videomodellen eignen. Bild-, Ton- und Zeitinformationen bleiben erhalten – für einfaches Kopieren, Verwenden und anschließendes Schneiden.
 Video
Funke | Video-Diagramme
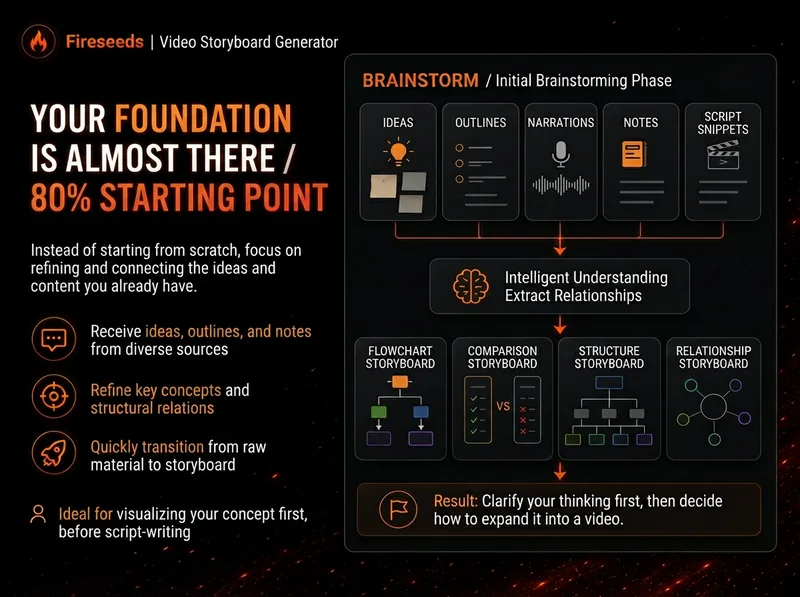
Viele Videos haben nicht zu wenig Inhalt, sondern sind zu abstrakt oder zu dicht. Das Publikum versteht den einen Satz – und hat den nächsten schon wieder vergessen. „Funke | Video-Diagramme“ verwandelt deine Ideen, Brainstormings, Gliederungen, Skripte, Transkripte oder Artikel zunächst in Konzepte, die sich wirklich visualisieren lassen. Anschließend wird entschieden, ob sie sich am besten als Ablauf, Vergleich, Architektur, Hierarchie, Kreislauf, Verzweigung, Entscheidungsbaum oder eine andere Diagrammstruktur darstellen lassen. Es werden weder Bilder erstellt, nur um eine bestimmte Anzahl zu erreichen, noch werden komplexe Inhalte in eine überladene Infografik gepresst. Mehrere Diagramme verwenden dieselbe visuelle Sprache, Namensgebung und semantische Farbgebung, sodass sie direkt als Gerüst für Erklärungen in Videos eingesetzt werden können. Besonders geeignet für: Komplexe Konzepte erklären Workflows aufschlüsseln Zwei Methoden vergleichen Systemstrukturen zeigen Ursache-Wirkungs-Zusammenhänge verständlich machen Lange Brainstormings in eine Reihe visueller Knotenpunkte für Videos verwandeln Die Standardausgabe sind statische Diagramme im Format 16:9. Wenn die Laufzeitumgebung keine bearbeitbare Excalidraw-Quelldatei bereitstellen kann, wird dies klar angegeben. Ein statisches Bild wird nicht als .excalidraw-Datei ausgegeben. Einsatzszenarien Szenario 1|Brainstorming in Diagramme verwandeln Du hast nur einen langen gesprochenen Gedankengang, aber noch kein vollständiges Skript. Das Skill findet die Aussagen, die sich am meisten lohnen zu visualisieren, und ordnet sie zu einer Reihe von Diagrammen mit sinnvoller Erzählreihenfolge. Szenario 2|Skripte in visuelle Knotenpunkte für Videos verwandeln Du hast bereits ein vollständiges Skript, weißt aber nicht, an welchen Stellen Bilder sinnvoll wären. Das Skill erkennt, welche Abschnitte sich für eine Visualisierung eignen, und wählt den passenden Diagrammtyp. Szenario 3|Komplexe Konzepte erklären Zum Beispiel: Wie ein AI Agent arbeitet, warum ein Workflow wichtiger ist als eine einmalige Demonstration, wie ein Geschäftsmodell funktioniert oder aus welchen Ebenen eine Produktarchitektur besteht. Szenario 4|Workflows und Abläufe aufschlüsseln Zum Beispiel: Themenpool → Recherche → Hook → Skript → Produktion → Nachbereitung. Szenario 5|Vergleiche erstellen Zum Beispiel: ohne Workflow vs. mit Workflow; traditionelle Methode vs. AI-Methode; einmaliger Erfolg vs. stabil und reproduzierbar.
MiniMax H3 Video-Prompt-Tool
Übergib ein vollständiges Referenzvideo an eine multimodale KI. Sie zerlegt automatisch reale Shots, die Timeline, Bildveränderungen und hörbare Geräusche und erstellt produktionsreife Prompts, die direkt für die Videoproduktion verwendet werden können. Das Tool ist nicht auf Personen, Werbung oder Filmmaterial beschränkt, sondern eignet sich auch für Produktpräsentationen, Architektur und Landschaften, Tiere, Essen, Sportbewegungen, Tanz, 2D-/3D-Animationen, UI-Demos, Bildschirmaufnahmen, Infografiken, visuelle Effekte und abstrakte Aufnahmen. Abhängig von der Informationsstruktur des Videos kann der Assistent vollständige Text-zu-Video-Prompts ausgeben oder für jeden Shot die benötigten Referenzbild- bzw. Startframe-Prompts, fortlaufende Bewegungsbeschreibungen, erforderliche Schlussframe-Prompts und shotbezogene Stabilitätsvorgaben erstellen. Wenn sowohl das statische Bild als auch die zeitliche Veränderung wichtig sind, kann er beide Versionen bereitstellen. Die erzeugten Inhalte bewahren tatsächlich bestätigbare Informationen zu Motiv, Bildkomposition, Kamerabewegung, Ursache und Wirkung von Aktionen, strukturellen Veränderungen, Text, Dialogen, Umgebungsgeräuschen und Musik und verfolgen jeden Shot bis zu seinem tatsächlichen Endzustand. Bei Texten, Geräuschen, Identitäten, Orten oder Aufnahmearten, die sich nicht eindeutig bestätigen lassen, vermeidet der Assistent eigenmächtige Ergänzungen. Außerdem unterscheidet er das gewünschte Bild von externen Elementen wie Player-Wasserzeichen und Steuerebenen, um Inhaltsabweichungen bei der Generierung zu verringern. Geeignet für Kreative und Produktionsteams, die aus Referenzvideos Text-zu-Video-Prompts oder I2V-Shot-Prompts ableiten oder Material für Videorekonstruktionen, Stilreproduktionen und generative Werbung aufbereiten möchten.
Informationen
- Version
- v2
- Zuletzt aktualisiert
- Credits pro Ausführung
- Nach Verbrauch
- Modelle
- Automatisch
- Anwendungsfälle
- Schreiben & InhalteVideo & AudioMarketing & Wachstum
- Deine Ergebnisse
- DokumentPromptPlan