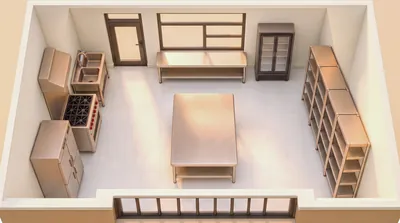
Sprach-3D-Szenenmodellierung
Mit YM Blender-Modellierung steuern
Sprach-3D-Szenenmodellierung
Mit YM Blender-Modellierung steuern
Einblicke
Beschreibung
Über das Blender MCP wird Blender direkt angesteuert, um Szenenräume zu modellieren und zu überprüfen, während KI-Bildprompts iterativ optimiert werden. Für Nutzer ohne 3D-Kenntnisse übernimmt die KI als vollwertiger Agent Modellierung, Render-Überprüfung, Lichtvalidierung und Prompt-Engineering. Das ultimative Ziel ist die Konsistenz der Szenen bei der Erstellung von 3D-Animationsvideos – Blender erstellt die Szene, steuert die Kamera und übergibt die Kameraposition als Referenz an das Video-Generierungsmodell.
Ähnliche Fähigkeiten
Alle anzeigen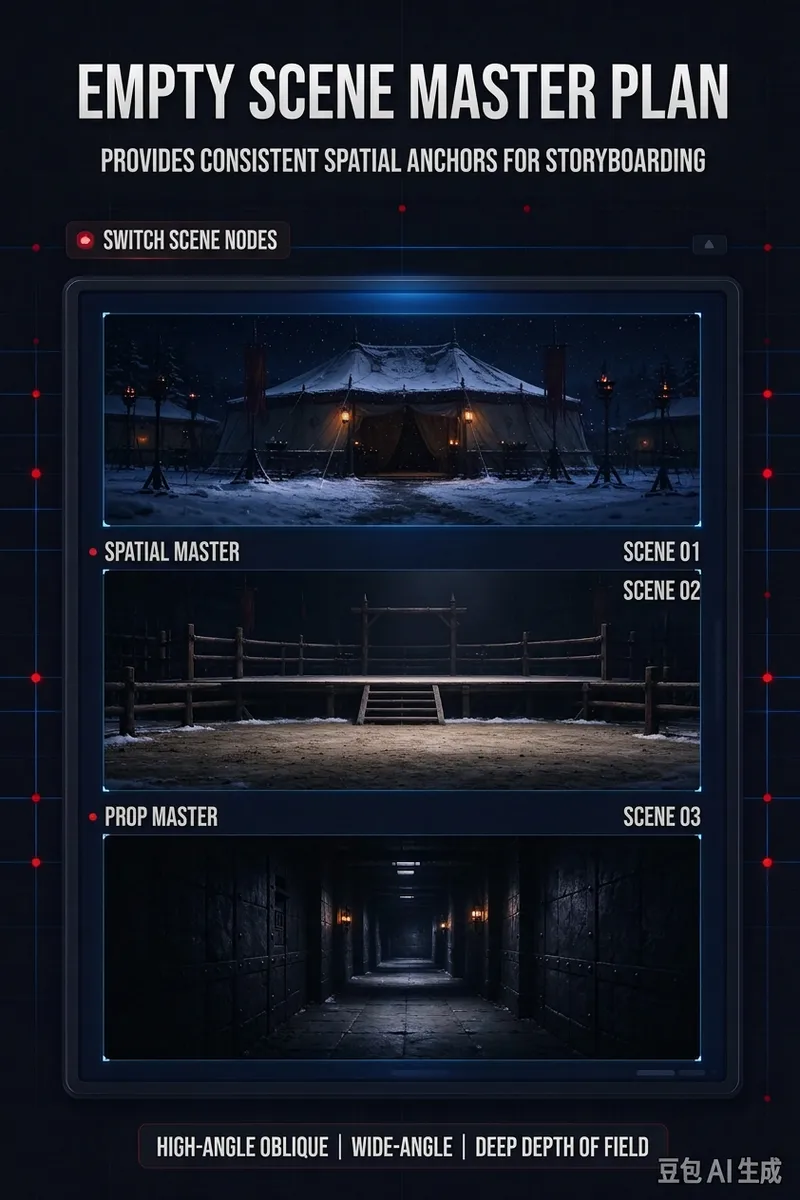
Szenen-Prompt-Extraktor
Extrahieren Sie Szenenwechsel einzeln aus Romanen, Drehbüchern oder Handlungsübersichten und wandeln Sie diese in chinesische Referenz-Prompts für leere Szenen um, die direkt für die KI-Bildgenerierung genutzt werden können. Ob Ortswechsel, Zeitsprünge, Wetterwechsel oder wiederkehrende Orte in verschiedenen Handlungsabschnitten – alles wird chronologisch geordnet, um Lücken oder falsche Zusammenführungen zu vermeiden und eine stabile räumliche Referenz für spätere Storyboards aufzubauen. Jede Szene wird funktional mit einem konkreten Artdesign versehen, das Raumstruktur, Ein- und Ausgänge, Wege, Vorder-, Mittel- und Hintergrund, Requisiten, visuellen Mittelpunkt, Lichtverhältnisse, Materialien, Farben und Handlungsspuren definiert, während Innen-, Außen- und Spezialräume unterschieden werden. Auch bei begrenzten Textbeschreibungen werden visuelle Szeneninformationen ergänzt. Das Endergebnis umfasst eine Szenenübersicht, den visuellen Gesamtton sowie Szenendesign, Bildgenerierungs-Prompts und negative Prompts für jede Szene. Der Fokus liegt auf filmischen Weitwinkeln, Tiefenschärfe und vollständigem Raumlayout, strikt ohne Personen oder Tiere, ideal für filmische Establishing Shots.
MiniMax H3 Video-Prompt-Tool
Übergib ein vollständiges Referenzvideo an eine multimodale KI. Sie zerlegt automatisch reale Shots, die Timeline, Bildveränderungen und hörbare Geräusche und erstellt produktionsreife Prompts, die direkt für die Videoproduktion verwendet werden können. Das Tool ist nicht auf Personen, Werbung oder Filmmaterial beschränkt, sondern eignet sich auch für Produktpräsentationen, Architektur und Landschaften, Tiere, Essen, Sportbewegungen, Tanz, 2D-/3D-Animationen, UI-Demos, Bildschirmaufnahmen, Infografiken, visuelle Effekte und abstrakte Aufnahmen. Abhängig von der Informationsstruktur des Videos kann der Assistent vollständige Text-zu-Video-Prompts ausgeben oder für jeden Shot die benötigten Referenzbild- bzw. Startframe-Prompts, fortlaufende Bewegungsbeschreibungen, erforderliche Schlussframe-Prompts und shotbezogene Stabilitätsvorgaben erstellen. Wenn sowohl das statische Bild als auch die zeitliche Veränderung wichtig sind, kann er beide Versionen bereitstellen. Die erzeugten Inhalte bewahren tatsächlich bestätigbare Informationen zu Motiv, Bildkomposition, Kamerabewegung, Ursache und Wirkung von Aktionen, strukturellen Veränderungen, Text, Dialogen, Umgebungsgeräuschen und Musik und verfolgen jeden Shot bis zu seinem tatsächlichen Endzustand. Bei Texten, Geräuschen, Identitäten, Orten oder Aufnahmearten, die sich nicht eindeutig bestätigen lassen, vermeidet der Assistent eigenmächtige Ergänzungen. Außerdem unterscheidet er das gewünschte Bild von externen Elementen wie Player-Wasserzeichen und Steuerebenen, um Inhaltsabweichungen bei der Generierung zu verringern. Geeignet für Kreative und Produktionsteams, die aus Referenzvideos Text-zu-Video-Prompts oder I2V-Shot-Prompts ableiten oder Material für Videorekonstruktionen, Stilreproduktionen und generative Werbung aufbereiten möchten.
KI-Video- & Storyboard-Prompts
Verwandle Handlungen, Figurenbeschreibungen oder vorhandene Video-Prompts in professionelle Storyboards für KI-generierte Kurzdramen und direkt nutzbare Shot-Prompts. Ob Urban-, Historien-, Mystery-, Romance- oder Rachedrama: Das Skill berücksichtigt Figurenbeziehungen, Erzähltempo und emotionale Hooks und definiert Einstellungsgröße, Kameraposition, Perspektive, Kamerabewegung, Bildkomposition, Licht, Umgebungsgeräusche und Dialoge. So erhält jeder Shot einen klaren visuellen Schwerpunkt und ausführbare Aktionen. Besonderes Augenmerk liegt auf der Konsistenz von Figuren und Szenen. Das hilft dabei, Aussehen, Kleidung, Identität und charakteristische Details festzulegen und Risiken wie Gesichtsveränderungen, Drift, räumliche Inkonsistenzen oder unklare Bewegungen bei der Generierung zu verringern. Auch Blick, Mimik, Atmung sowie Reaktionen von Händen und Körper werden in sichtbare schauspielerische Veränderungen übersetzt, um Konflikte, Druck, Wendungen und die emotionale Steigerung des Kurzdramas zu verstärken. Du kannst mit einer vollständigen Handlung beginnen oder vorhandene Figuren-Assets, Storyboards oder Prompts zur gezielten Optimierung bereitstellen. Bei bereits etablierten Figuren können diese direkt übernommen werden, sodass eine wiederholte Gestaltung entfällt. Anschließend lassen sich die vollständigen Shots in höchstens 15 Sekunden lange Abschnitte aufteilen, die sich für die schrittweise Generierung mit gängigen KI-Videomodellen eignen. Bild-, Ton- und Zeitinformationen bleiben erhalten – für einfaches Kopieren, Verwenden und anschließendes Schneiden.
Informationen
- Version
- v6
- Zuletzt aktualisiert
- Credits pro Ausführung
- Nach Verbrauch
- Modelle
- Automatisch
