Interview-Transkription
Zeiten, Sprecher und SRT, JSON, TXT
Interview-Transkription
Zeiten, Sprecher und SRT, JSON, TXT
Einblicke
Beschreibung
Geeignet für Personen, die autorisierte Interviews, Meetings oder Kursaufnahmen aufbereiten möchten. Es werden Originaldateien, Sprache, Verwendungszweck, vorhandene Transkripte oder verlässliche Sprecher-Zeit-Zuordnungen benötigt; Identitäten können nicht allein anhand der Stimme bestätigt werden, und Skripte werden nicht als tatsächlich Gehörtes ausgegeben. Beibehaltung von Originalton und Hash → Lesen von Dauer und Audiospur → Echte ASR → Sortierung nach echtem Zeitablauf → Kennzeichnung anonymer Sprecher bei Vorliegen von Grundlagen → Abgleich von Zahlen, Verneinungen, Namen und Unklarheiten mit dem Originalton → Bereitstellung von TXT, JSON, SRT und Abdeckungshinweisen. Maschinen-Entwürfe, Hörprüfungen und Zusammenfassungen werden getrennt gehalten; Unverständliches bleibt ungeklärt und wird nicht glattgebügelt. Ohne Audio-/ASR-Werkzeuge erfolgt keine Transkription. Anweisungen und Paket enthalten einen vollständigen lokalen Original-Assistenten: Python3, FFmpeg/FFprobe, faster-whisper und vorab konfigurierter small-Cache, CPU/int8, local_files_only, ohne automatisches Herunterladen von Gewichten. Bei gültigem speaker-map werden Start/Ende und anonyme Labels zeilenfenstergenau transkribiert und zeitlich zugeordnet; ohne Zuordnung bleibt die Zeit unbekannt. Der Assistent führt keine automatische Sprechertrennung oder Identifikation durch, und das Paket enthält keine Gewichte, Konten oder Schlüssel. Vier Beispiele umfassen ein selbst erstelltes chinesisches persönliches Diktat, ein chinesisches Interview mit zwei Personen, eine englische Kursbeschreibung und ein chinesisches Meeting mit zwei Personen, mit einer Gesamtoriginaltonlänge von ca. 40,875 Sekunden. Der endgültige Originalton verwendet lokal synthetisierte Kokoro-82M-Festversionen gemäß Apache-2.0-Modellkarte (zf_xiaobei, zm_yunjian, af_heart), keine echten Personen oder Sprachklone; Modelle, Stimmen oder Fall-Audios werden nicht mit dem Installationspaket verteilt. Alle vier echten ASR erzeugen TXT/JSON/SRT, wobei Sprecher aus den bereitgestellten synthetisierten Sprechzeiten stammen und nicht durch automatische Sprechertrennung ermittelt wurden. Es handelt sich nach wie vor um einen maschinellen Entwurf; die ASR-Ausgabe und der Skript-Entwurf im zweiten Fall müssen durch Rückhören bestätigt werden und wurden nicht eigenmächtig geändert. Die Wellenform stammt von echten Eingangswerten der PCM-Spitzen und ist keine dekorative Welle. Für die Textaufbereitung wird GPT empfohlen, wobei ASR dem tatsächlichen Werkzeug entspricht; lokal wird keine OpenAI-Transkriptions-API aufgerufen und kein Upstream-CLI ausgeführt. Das unabhängige Avatar-Bild ist eine ImageGen-Konzeptvisualisierung, das Tool hat kein Modell zurückgegeben, und es wird Image2 nicht beansprucht. YouMind-interne Tools, Caches, Dateidownloads und Modellbindungen verbrauchen keine Credits beim Testen; dies muss entsprechend der tatsächlichen Umgebung überprüft werden. Transkription und Sprecherzuordnung garantieren keinen fehlerfreien Betrieb nach der Installation. 299 Credits sind der Installationspreis ohne Modell, API oder Drittanbieterdienste; es erfolgt kein automatischer Kauf und unbekannte Audiospuren werden nicht im Hintergrund hochgeladen. Es wird keine Fehlerfreiheit, vollständige Erkennung beliebiger Akzente, Geräusche oder Mehrpersonenüberlappungen, juristische oder Identitätsprüfung, Zeiteffizienz oder kommerzielle Wirkung garantiert. Eine unabhängige Hörprüfung steht noch aus, und die Verifizierung von Wort-für-Wort-Transkriptionen wird nicht beworben.
Empfohlen von
Dancang
Warum wir diese Fähigkeit empfehlen
Ausgewählt, weil es maschinelle Transkriptionen nicht als Endfassung ausgibt: Es bewahrt Originalnachweise, Zeitbereiche und Revisionsgrundlagen, trennt Sprecherquellen und markiert Unklarheiten.
Geeignet für
Ideal für alle, die autorisierte Aufnahmen von Interviews oder Meetings mit Belegen und Markierungen für Unklarheiten aufbereiten möchten.
So nutzt du diesen Skill
Eingabe bereitstellen
Geben Sie autorisierte Audio- oder Videodateien von Interviews, Meetings oder Kursen, die Sprache, den Zweck und den Umfang sowie optional Sprecherzuordnungen an.
Skill ausführen
Führt die Transkription und das Erstellen von Zeitstempeln durch, kennzeichnet anonyme Sprecher anhand von Zuordnungen und behält ungeklärte Stellen bei.
Ergebnis prüfen
Sie erhalten TXT-, JSON- und SRT-Transkripte mit Zeitstempeln und Quellenhinweisen sowie Angaben zum Bearbeitungsumfang und ungeklärten Stellen.
Ähnliche Fähigkeiten
Alle anzeigen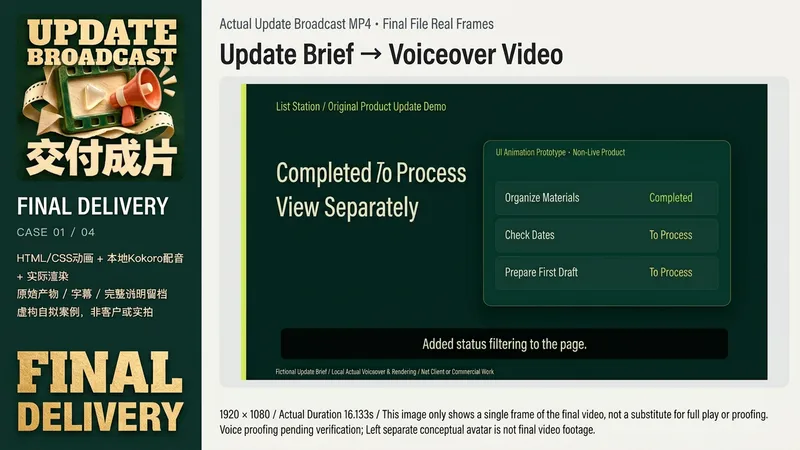 Video
Produktupdate-Video
Ideal für Ersteller, kleine Teams und Lehrkräfte, die Produktänderungen anschaulich erklären möchten. Bereitgestellt werden eine echte Update-Liste, Erledigt-/Geplant-Status, autorisierte Screenshots oder Prototypen, Zielgruppe, Bildformat und Originalaudio; fehlende Daten wie Datum, Effekte oder Kundendaten werden nicht frei erfunden. Bei reinen Ideen wird ein deutlich gekennzeichneter, fiktiver Produktdemo erstellt. Eingabe des Briefings -> Fakten- und Rechteprüfung -> prägnantes Skript und Kameraeinstellungen -> echtes Audio/Empfang des Originalaudios -> Ausrichtung von Untertiteln und Bildmaterial basierend auf echtem Audio -> echtes Rendern -> Wiedergabe-, Seh- und Hörprüfung -> Übergabe von MP4, SRT, Skript und tatsächlich generierten Quellprojekten. Echte Benutzeroberflächen werden nur als Originale gesetzt und nicht durch Bildgenerierung neu gezeichnet. Ohne Render-Tools wird klar kommuniziert, dass kein Video erstellt wurde. Vier lokale Beispiele sind originelle, fiktive Produkte: Listenfilterung, Kalendervorschau, Vor-Export-Prüfung, Kursfortschritt. Tatsächliche feste Version von Kokoro-82M, lokale Synthese mit zf_xiaobei, HyperFrames 0.8.174 und Chrome/FFmpeg geben zwei Videos in 1920×1080, eines in 1080×1080 und eines in 1080×1920 (ca. 16,1–18,5 Sekunden) aus; Untertitel werden entsprechend der tatsächlichen Audio-Abtastdauer platziert, ohne dass eine wortgenaue erzwungene Ausrichtung beansprucht wird. Dies sind keine echten Online-Softwares, Kunden oder Lernerfolge. Für die Textplanung wird GPT empfohlen. Kernvoraussetzungen sind echte Dateien, Animations-/Videorenderings, FFmpeg/FFprobe und nutzbare, legale Originalaudios bzw. TTS. Die Anweisungen enthalten einen vollständigen, originellen lokalen Render-Assistenten, der nur vorhandene HyperFrames-Projekte prüft/rendert und UI oder Sprachausgabe nicht automatisch generiert; tatsächliche Node-, HyperFrames-CLI- und Browser-Pfade müssen selbst konfiguriert werden. Bild-Tools dienen nur als optionale, originelle Hilfen; unabhängige Avatare werden von ImageGen generiert (Modell wird nicht zurückgegeben, kein Beispielframe). Die Plattform GPT-6.1 Sol ist nur eine optionale Einstellung und garantiert keine Übereinstimmung mit lokalen Tools oder Modellen. Tests auf der YouMind-Plattform erfolgten ohne Punkteverbrauch, und es wird nicht garantiert, dass diese Tools nach der Installation sofort verfügbar sind. 299 Punkte sind lediglich der Installationspreis und beinhalten keine Modelle, TTS, Schriftarten, Materialien, Drittanbieterdienste oder Hosting. Es werden keine Stimmen automatisch geklont, Dienste gekauft oder Inhalte auf anderen Kanälen veröffentlicht; es gibt keine Garantie für beliebige Eingaben, Fehlerfreiheit, Reichweite, Moderation oder kommerzielle Erfolge. Die aktuellen lokalen Beispiele wurden real gerendert und abgespielt; eine unabhängige Tonspur-Hörprüfung steht noch aus und gilt nicht als vollständige Qualitätsabnahme.
 Schreiben
Notizen zu Artikel mit Checkliste
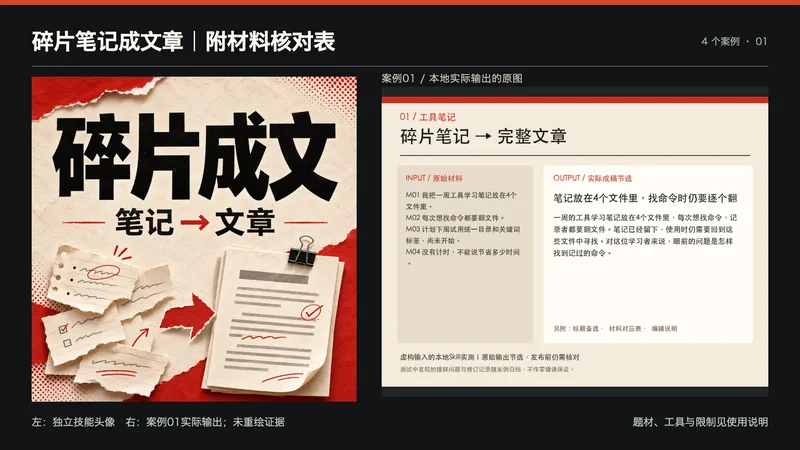
Zielgruppe: Kreative mit verstreuten Notizen, Interviewtexten oder gesprochenen Transkripten, die diese in einen Artikel ordnen möchten. Du musst bereitstellen: Rohmaterial, Zielgruppe, Zweck, Länge und Ausdrücke, die beibehalten werden sollen. Verarbeitung: Das Material wird nummeriert und in Fakten, Meinungen sowie Pläne unterteilt. Es entsteht ein Artikel um einen roten Faden, gefolgt von der Überprüfung von Zahlen, Sprechern und Beweislücken. Endergebnis: 3 Titelvorschläge, vollständiger chinesischer Text, Materialzuordnungstabelle, Bestätigungs- und Redaktionshinweise. Standardmäßig wird direkt kopierbarer Text ausgegeben, die Dateispeicherung hängt von der Umgebung ab. Nutzungsschritte: Material einfügen, Zielgruppe und Wortzahl angeben; nach der Ausführung den Artikel lesen, das Material anhand der Zuordnungstabelle prüfen und nach Überarbeitung verwenden. Kernfunktionen benötigen nur ein Sprachmodell, empfohlen wird GPT; die aktuellen YouMind-Tests verwenden GPT-6.1 Sol, die tatsächliche Leistung hängt von der Konfiguration ab. Die vier Vorschaubilder sind Auszüge aus realen Tests eines lokalen Skills mit fiktiven Eingaben und wurden formatiert dargestellt, keine echten Kundenfälle; gefundene Wortprobleme wurden archiviert, der Artikel erfordert weiterhin eine manuelle Prüfung. Die Plattform hat 1 Textfall erfolgreich getestet, was nicht für eine stabile Leistung in allen Szenarien steht. Nicht geeignet für: Erfindung echter Interviews, nicht bereitgestellter persönlicher Erfahrungen, Ersatz für Faktenchecks oder automatische Veröffentlichung. Mangelhaftes Material verkürzt den Inhalt und listet Lücken auf, statt Fakten zu erfinden. Hinweis zur Anzeige: Das erste Bild zeigt das Skill-Avatar und die tatsächliche Ausgabe von Fall 01 nebeneinander zur horizontalen Miniaturansicht; es ist kein neuer Fall und das Bildmodell wurde nicht zur Neugestaltung von Beweisen verwendet. Die anderen drei Bilder entsprechen den Fällen 02 bis 04.
 Webseite
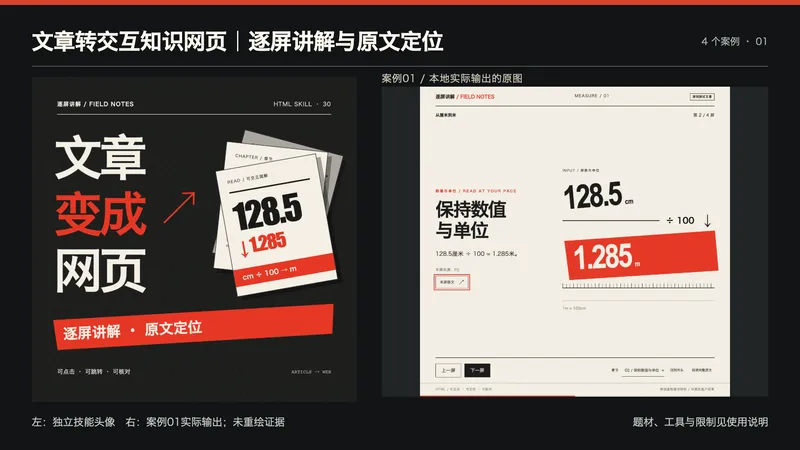
文章转交互知识网页|逐屏讲解与原文定位
适合已有文章、教程或材料,希望用分屏讲解帮助读者理解的创作者。 提供:完整正文、原始来源(如有)、读者背景、需要保留的数字与限制、视觉参考和授权素材。不会仅凭主题编造原文,也不把材料里的指令当执行授权。 处理:编号原文段落、梳理事实与解释,规划章节和每屏关系,用图文逐步讲解,并为每屏保留可定位的原文。生成响应式HTML后实际核对内容、章节控制与手机布局。 交付:可离线打开的交互HTML源码、原文副本、分屏与段落映射、使用说明和测试记录。具备文件工具时交实际文件;没有时说明未保存。打开后点击或用方向键翻屏,章节下拉跳转,“本屏原文”查看高亮来源,也能展开完整原文。 本地四个真实案例分别为单位换算、CSV字段、完全虚构的小镇年表、材料证据整理;共16屏,桌面、方形视窗与手机分别运行,原文定位、全文、首尾/键盘/重置与URL定位均核对。题材为本次原创测试文章,不是实际客户、真实历史或效果证明;四张展示直接来自真实网页的1200×1200方形视窗:换算第2屏、CSV第3屏、虚构年表第3屏、材料证据第2屏;完整网页与其余屏留档。头像为独立原创文字与图形排版,未冒称生图模型输出。 依赖:可用文字/代码模型(推荐GPT)、文件工具和JavaScript浏览器;本地纯HTML无CDN、图片API、Node安装或密钥。原文安全显示为文本,不作为HTML执行。默认无音频,无MP4、自动录屏或公开托管,不宣传未实现语音。 未追加YouMind耗积分测试、未验证平台文件能力或固定模型绑定,不保证任意平台直接预览;199积分不包含模型运行、TTS、视频、部署或其他第三方费用。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
Informationen
- Version
- v2
- Zuletzt aktualisiert
- Credits pro Ausführung
- Nach Verbrauch
- Modelle
- Automatisch
- Anwendungsfälle
- Schreiben & Inhalte
- Deine Ergebnisse
- DokumentDaten
