Token-Optimierungsassistent
Token-Optimierungsassistent
Einblicke
Beschreibung
Diagnostiziere die Token-Nutzung der aktuellen Sitzung, biete sofort umsetzbare Optimierungsvorschläge, um die Effizienz und Reaktionsgeschwindigkeit des Dialogs zu verbessern.
Empfohlen von
nene@YouMind
Warum wir diese Fähigkeit empfehlen
Dieser Assistent diagnostiziert Token-Verbrauchsprobleme und bietet 3-5 priorisierte Optimierungsvorschläge, von sofortigen Bereinigungen bis zu langfristigen Gewohnheiten, um die KI-Effizienz zu steigern und Ressourcen zu sparen.
Ähnliche Fähigkeiten
Alle anzeigen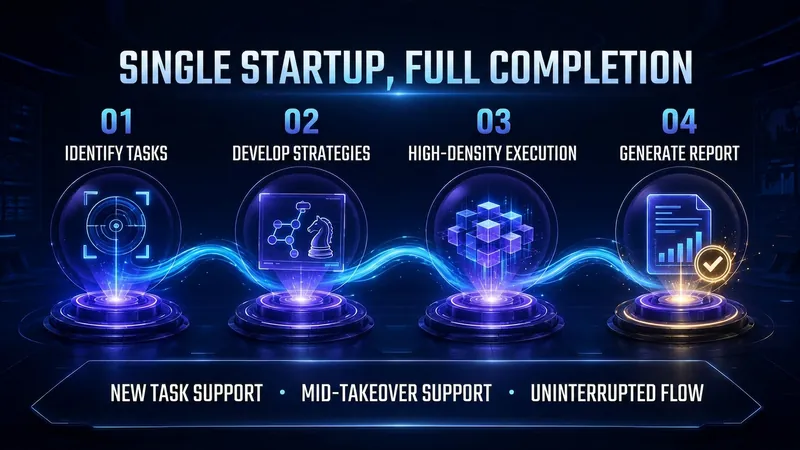
Token-Spar-Experte
Hast du schon einmal berechnet, wie viel du jeden Monat für das 'Geschwafel' der KI bezahlst? "Okay, lass mich dir helfen..." "Lass uns zunächst deine Frage zusammenfassen..." "Zusammenfassend ist das oben Genannte..." Diese Sätze liest du nicht einmal, aber jedes Wort kostet dich Token. 💸 Ich habe einen Skill namens 'Token-Spar-Experte' entwickelt, der genau dagegen vorgeht: ✅ Automatische Erkennung des Aufgabentyps und Anwendung der Token-sparenden Strategie ✅ Entfernt Redundanz, nicht Tiefe – Qualität ohne Abstriche ✅ Nach der Aufgabe automatisch eine Abrechnung: Diesmal 40%+ gespart – klar und deutlich Wenn du KI regelmäßig nutzt, installiere ihn und spare ein paar Euro für den nächsten Kaffee. Eine Tatsache, die die meisten übersehen: Ein erheblicher Teil des Geldes, das du für KI ausgibst, fließt nicht in die 'Antworten', sondern in die 'Prozesssprache' – Begrüßungen, Wiederholungen der Frage, Überleitungen, Zusammenfassungen. Diese Inhalte erzeugen keinen Mehrwert, aber jeder Token wird abgerechnet. Ich habe die gesamte Methodik zur Optimierung der Informationsdichte in einen Skill verpackt: 'Token-Spar-Experte'. Seine Arbeitsweise ist direkt – er erkennt den Aufgabentyp, wendet automatisch die Token-sparende Strategie an, führt Aufgaben mit höchster Informationsdichte aus, entfernt alle redundanten Ausdrücke, während harte Vorgaben die Qualität sichern; nach Abschluss der Aufgabe erstellt er automatisch einen detaillierten Token-Bericht, der dir zeigt, wie viel jede Phase verbraucht hat, wie viel im Vergleich zum Standardmodus gespart wurde und wie du in Zukunft noch optimieren kannst. Unterstützt werden zwei Modi: Start von Anfang oder Übernahme während der Aufgabe – keine Konfiguration erforderlich. Wenn du ein intensiver KI-Nutzer bist – Autor, Forscher, Ersteller von Masseninhalten, API-Nutzer mit nutzungsabhängiger Abrechnung – ist dieser Skill im Wesentlichen eine 'Geldsparmaschine': Einmal installiert, reduziert er bei jedem Gespräch deine Kosten. Jetzt im YouMind Skill-Markt verfügbar – suche nach 'Token-Spar-Experte', um ihn zu installieren.
Token-Optimierungs-Meister
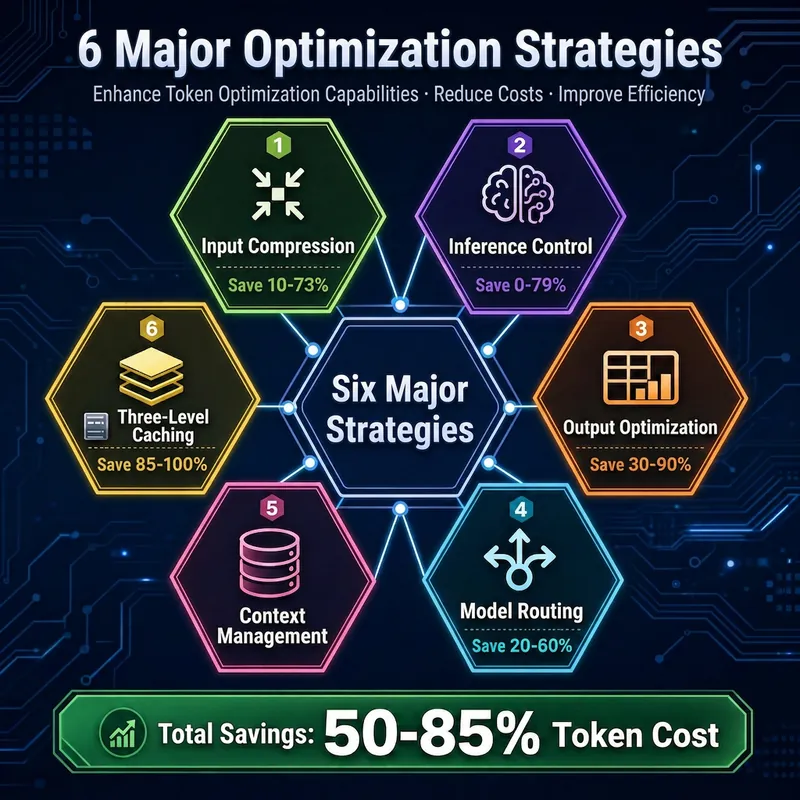
Intelligente Erkennung · Automatische Optimierung im Hintergrund · YouMind-weite Abdeckung. Erkennt automatisch Optimierungsmöglichkeiten, wendet Strategien im Hintergrund an und unterstützt drei Entity-Typen: Board, Chaos und Geister. Basierend auf den tatsächlichen Modellkosten von YouMind wählt es intelligent das optimale Modell aus und erzielt so 50-85% Token-Kosteneinsparungen. Nach der Installation durch Integration mit Board Memory nahezu automatische Optimierung, beim ersten Start automatische Konfigurationsanleitung.
Modellwahl für Code & Content
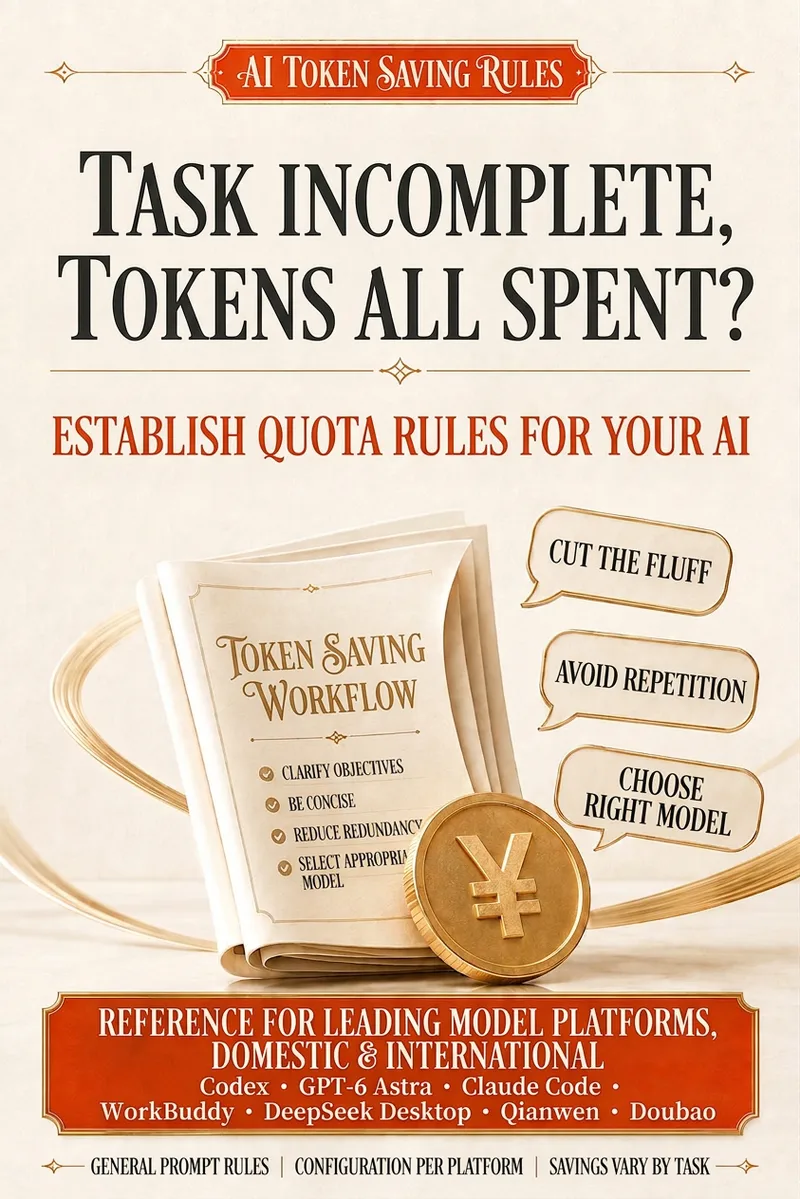
Je nach Aufgabenschwierigkeit, Inhaltstyp und Projektphase hilft dir dieser Skill, ein passenderes KI-Modell auszuwählen und ein Regelwerk für einen sparsameren Einsatz von Kontingent und Token anzuwenden. So erledigst du Programmier-, Kreativ-, Planungs-, Design- und Informationsanalyseaufgaben bei kontrolliertem Kontingentverbrauch. Ob Seitenkomponenten, API-Anbindungen, einfache Fehlerbehebungen oder Architekturdesign, komplexe Logik, Code-Reviews und Refactorings – du erhältst klare Modellempfehlungen und direkt die benötigten Ergebnisse. Der Skill eignet sich ebenso für alltägliche Texte, Titel und Hooks, Story-Inhalte, Markenkonzepte, Marketingpläne, PPT-Strukturen, visuelle Ideen, Markttrends, Wettbewerbsanalysen und Datenauswertungen. Einfache, umfangreiche und formatierte Aufgaben werden bevorzugt mit kontingentschonenden Methoden bearbeitet. Bei wichtigen Entscheidungen, komplexen Schlussfolgerungen oder der finalen Fassung wirst du daran erinnert, für bessere Qualität ein geeigneteres Modell einzusetzen. Bei der fortlaufenden Nutzung passt der Skill seine Empfehlungen anhand deiner Modellpräferenzen, Ausgabegewohnheiten, des technischen Stacks deines Projekts, wichtiger Entscheidungen, anstehender Aufgaben und bekannter Probleme an und reduziert so wiederholte Abstimmungen. Bei Codeaufgaben liegt der Fokus standardmäßig auf den zentralen Änderungen, ergänzt durch eine Zusammenfassung. Bei Texten und Konzepten wird zunächst die Gesamtstruktur geklärt und anschließend nach Bedarf ausgearbeitet. So passt sich jedes Gespräch besser an dein aktuelles Projekt und deinen Arbeitsrhythmus an.
Informationen
- Version
- v1
- Zuletzt aktualisiert
- Credits pro Ausführung
- Nach Verbrauch
- Modelle
- Automatisch
