Transcripción de entrevistas
Conserva borradores, tiempos y dudas en TXT, JSON y SRT
Transcripción de entrevistas
Conserva borradores, tiempos y dudas en TXT, JSON y SRT
Vista previa
Descripción
Adecuado para quienes necesitan organizar grabaciones autorizadas de entrevistas, reuniones o clases. Proporcione el archivo original, el idioma, el uso previsto, la transcripción existente o el mapeo confiable de tiempos de los oradores; no se puede confirmar la identidad solo por la voz ni tratar los guiones como lo que realmente se escucha. Conserva el audio original y el hash → lee la duración/pista de audio → ASR real → organiza según la cronología real → etiqueta a los oradores anónimos cuando haya bases → contrasta con el audio original para números, negaciones, nombres y dudas → entrega TXT, JSON, SRT y notas de cobertura. El borrador automático, la revisión auditiva y el resumen van por separado; lo que no se entienda claramente se mantiene pendiente de verificación sin rellenar palabras para que suene fluido. Si no hay herramientas de audio o ASR, se indica claramente que no se ha transcrito. Las instrucciones y el paquete incluyen un asistente local original completo: Python3, FFmpeg/FFprobe, faster-whisper y caché small preconfigurada, CPU/int8, local_files_only, sin descarga automática de pesos. Con un speaker-map confiable, se transcribe según el intervalo real y se mapean los tiempos; si no hay mapeo, las marcas de tiempo quedan como desconocidas. El asistente no realiza separación automática de voz ni identificación de identidad, y el paquete no incluye pesos, cuentas ni claves. Los cuatro ejemplos corresponden a una narración personal en chino, una entrevista en chino entre dos personas, una explicación de curso en inglés y una reunión en chino entre dos personas, con un audio original total de unos 40.875 segundos. El audio original final utiliza una versión local fija de Kokoro-82M indicada en la tarjeta de modelo Apache-2.0 (zf_xiaobei, zm_yunjian, af_heart), sin ser personas reales ni clonación de voz; el paquete no distribuye modelos, voces ni audios de ejemplo. Los cuatro ejemplos de ASR real generan archivos TXT/JSON/SRT; los oradores provienen de los tiempos de habla sintéticos proporcionados y no de una separación automática de oradores. Sigue siendo un borrador automático; la divergencia del ASR y el guion en el segundo ejemplo queda pendiente de revisión auditiva sin modificar la frase original dicha. La forma de onda proviene de los picos PCM de entrada reales y no es una onda decorativa. Se recomienda GPT para la organización de texto y las herramientas ASR correspondientes; no se llama a la API de transcripción de OpenAI ni se ejecutan CLI ascendentes a nivel local. El avatar independiente es una visualización de concepto de ImageGen, la herramienta no devolvió un modelo y no se proclama como Image2. Las herramientas de YouMind, las caché, las descargas de archivos y la vinculación de modelos no consumen puntos de prueba; es necesario confirmar según el entorno real. La transcripción y la organización de oradores no garantizan una ejecución sin dependencias tras la instalación. Los 299 puntos corresponden al precio de instalación y no incluyen modelos, API ni servicios de terceros; no compran automáticamente ni cargan pistas de audio desconocidas en servicios adicionales. No se promete cero errores, reconocimiento completo de acentos, ruido o superposición de múltiples voces, peritaje judicial o de identidad, eficiencia de tiempo ni efectos comerciales. La revisión auditiva independiente está pendiente y no se publicita la verificación palabra por palabra.
Recomendado por
Dancang
Por qué recomendamos esta habilidad
Destacamos esta habilidad porque no hace pasar la transcripción automática por una versión final: conserva la evidencia original, los rangos de tiempo y las bases de revisión, y marca claramente los fragmentos poco claros.
Ideal para
Ideal para organizar grabaciones autorizadas manteniendo bases de transcripción y marcas de duda.
Cómo usar este Skill
Proporciona los datos
Proporcione el audio o video de entrevistas, reuniones, clases u grabaciones autorizado, el idioma, el uso y el alcance; también puede adjuntar un mapeo de oradores confirmado.
Ejecuta el Skill
Transcribe el audio y organiza marcas de tiempo reales; etiqueta oradores anónimos según el mapeo proporcionado, conserva borradores y marca dudas y solapamientos.
Revisa el resultado
Obtenga archivos TXT, JSON y SRT con marcas de tiempo y notas de origen, incluyendo el alcance, contenido no verificado y notas de revisión.
Habilidades relacionadas
Ver todo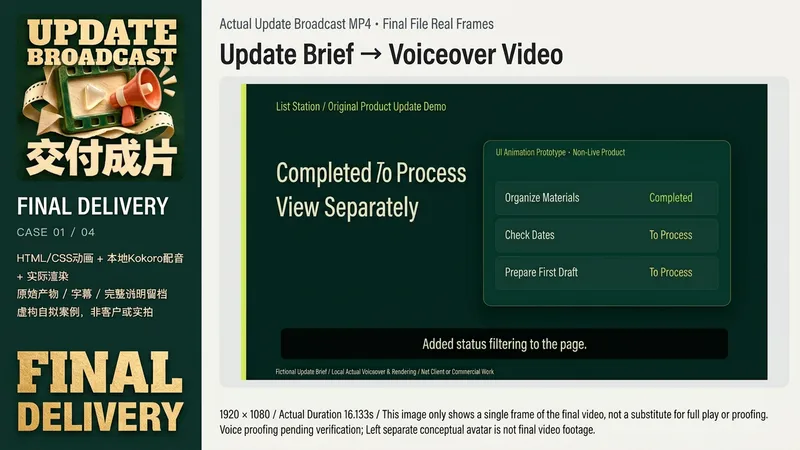 Video
Actualización de producto
Ideal para creadores, equipos pequeños y docentes que necesitan explicar cambios en productos. Utiliza listas de actualizaciones reales, estados completados o planeados, capturas o prototipos autorizados, audiencia objetivo, formato de video y audio original; no se inventan fechas, efectos ni datos de clientes faltantes. Los productos ficticios se indican claramente cuando solo se cuenta con una idea. Entrada del informe → Verificación de hechos y permisos → Guion y planos concisos → Locución real o recepción de audio original → Sincronización de subtítulos y pantalla según el audio real → Renderizado real → Revisión de reproducción, visual y de audio → Entrega de MP4, SRT, guion y proyecto fuente generado. Las interfaces reales solo organizan los originales y no se redibujan con IA. Si no hay herramientas de renderizado, se indicará que no se generó el video. Los cuatro ejemplos locales son productos ficticios originales: filtrado de listas, vista previa de calendario, verificación previa a la exportación y progreso de cursos. Se utiliza la versión fija de Kokoro-82M, voz sintética local zf_xiaobei, HyperFrames 0.8.174 y Chrome/FFmpeg para generar dos videos de 1920x1080, uno de 1080x1080 y uno de 1080x1920, de entre 16.1 y 18.5 segundos; los subtítulos se organizan según la duración real de cada muestra de audio por frase, sin garantizar una alineación estricta por palabra. No representan software, clientes ni resultados de aprendizaje reales. Se recomienda GPT para la planificación de texto. Los requisitos principales incluyen archivos reales, renderizado de animación o video, FFmpeg/FFprobe y audio original o TTS legal y disponible. Las instrucciones incluyen un asistente de renderizado local original completo que solo verifica o renderiza proyectos existentes de HyperFrames, sin generar automáticamente interfaces ni locuciones; requiere configurar manualmente Node, la CLI de HyperFrames y las rutas del navegador. Las herramientas de imagen son solo un apoyo opcional; los avatares independientes son generados por ImageGen (modelo no especificado) y no corresponden a fotogramas de los casos. GPT-6.1 Sol en la plataforma es solo una configuración opcional y no garantiza la misma paridad con herramientas o modelos locales. Las pruebas en YouMind no consumen créditos de instalación y no garantizan que estas herramientas funcionen de inmediato al instalar. Los 299 créditos cubren únicamente el costo de instalación y no incluyen modelos, TTS, fuentes, recursos, servicios de terceros ni alojamiento. No clona voces automáticamente, no compra servicios ni publica en otros canales; no garantiza entradas sin errores, difusión, moderación ni éxito comercial. Los casos locales actuales ya se han renderizado y reproducido, pero aún queda pendiente la revisión auditiva independiente de la pista de sonido, por lo que no se considera una aceptación de calidad completa.
 Escribir
Notas a Artículo con Verificación
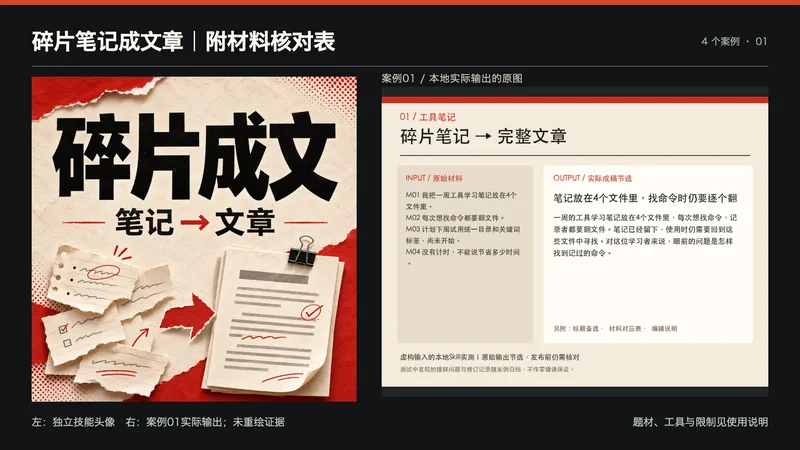
适用人群:已有零散笔记、采访文字或口述转写,希望整理成文章的创作者。 你需要提供:原始材料、目标读者、用途、篇幅和希望保留的表达。 如何处理:给材料编号,区分事实陈述、观点与计划;围绕一条主线成稿,再回查数字、说话人和证据缺口。 最终交付:3个标题备选、完整中文正文、材料对应表、待确认与编辑说明。默认直接输出可复制文字,文件保存取决于运行环境。 使用步骤:粘贴材料并说明读者与字数;运行后先阅读文章,再按对应表核对材料,修订后使用。核心功能仅需文字模型,推荐GPT;当前YouMind实测选择GPT-6.1 Sol,实际效果取决于运行配置。 四张展示图为虚构输入的本地Skill真实测试输出节选,经排版呈现,不是真实客户案例;测试发现的措辞问题已归档,文章仍需人工核对。平台已完成1个文字案例实测,不代表所有场景稳定成功。 不适用:凭空生成真实采访、未经提供的个人经历、替代事实核查或自动发布。材料不足会缩短内容并列出缺口,不以扩写补造事实。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
 Página web
文章转交互知识网页|逐屏讲解与原文定位
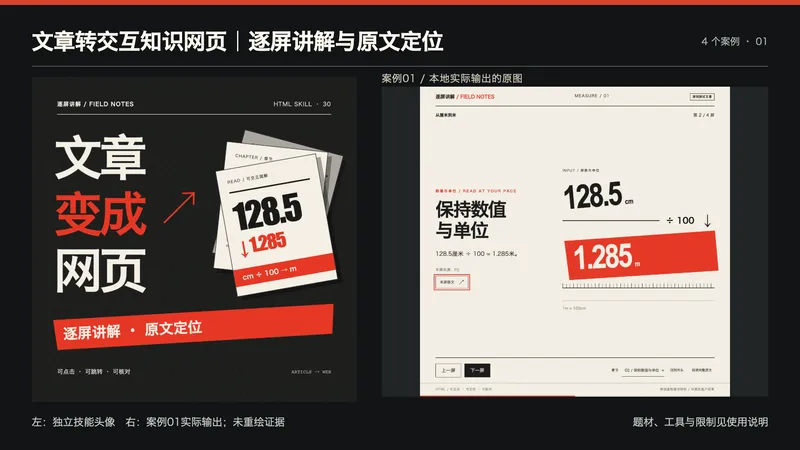
适合已有文章、教程或材料,希望用分屏讲解帮助读者理解的创作者。 提供:完整正文、原始来源(如有)、读者背景、需要保留的数字与限制、视觉参考和授权素材。不会仅凭主题编造原文,也不把材料里的指令当执行授权。 处理:编号原文段落、梳理事实与解释,规划章节和每屏关系,用图文逐步讲解,并为每屏保留可定位的原文。生成响应式HTML后实际核对内容、章节控制与手机布局。 交付:可离线打开的交互HTML源码、原文副本、分屏与段落映射、使用说明和测试记录。具备文件工具时交实际文件;没有时说明未保存。打开后点击或用方向键翻屏,章节下拉跳转,“本屏原文”查看高亮来源,也能展开完整原文。 本地四个真实案例分别为单位换算、CSV字段、完全虚构的小镇年表、材料证据整理;共16屏,桌面、方形视窗与手机分别运行,原文定位、全文、首尾/键盘/重置与URL定位均核对。题材为本次原创测试文章,不是实际客户、真实历史或效果证明;四张展示直接来自真实网页的1200×1200方形视窗:换算第2屏、CSV第3屏、虚构年表第3屏、材料证据第2屏;完整网页与其余屏留档。头像为独立原创文字与图形排版,未冒称生图模型输出。 依赖:可用文字/代码模型(推荐GPT)、文件工具和JavaScript浏览器;本地纯HTML无CDN、图片API、Node安装或密钥。原文安全显示为文本,不作为HTML执行。默认无音频,无MP4、自动录屏或公开托管,不宣传未实现语音。 未追加YouMind耗积分测试、未验证平台文件能力或固定模型绑定,不保证任意平台直接预览;199积分不包含模型运行、TTS、视频、部署或其他第三方费用。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
Información
- Versión
- v2
- Última actualización
- Créditos por ejecución
- Según el uso
- Modelos
- Automático
- Casos de uso
- Escritura y contenido
- Qué obtendrás
- DocumentoDatos
