“El mundo es todo lo que es el caso.” — Ludwig Wittgenstein,
Tractatus Logico-Philosophicus
, 1921
El mundo no está hecho de palabras.
En un ensayo anterior, argumentamos que la inteligencia espacial es la próxima frontera de la IA y que los modelos del mundo son el camino para alcanzarla. Aquí, el equipo de World Labs y yo queremos profundizar un nivel más: de las muchas cosas que se están construyendo y llamando 'modelos del mundo', ¿qué piezas funcionales componen realmente esa capacidad — y para qué sirve cada una?
Los modelos de lenguaje han dado a las máquinas un dominio extraordinario de conceptos, vocabulario y razonamiento, pero el mundo físico, virtual o real, funciona sobre un sustrato diferente. Mientras que los modelos de lenguaje aprenden la estructura estadística del texto, los modelos del mundo aprenden la estructura estadística del espacio y el tiempo: cómo cae la luz sobre una superficie, cómo se ve un jardín desde un ángulo que ninguna cámara ha capturado, cómo los objetos responden a la fuerza y siguen las leyes de la física.
Eso convierte a "modelo del mundo" en uno de los términos más importantes y más sobrecargados de la IA actual. La visión por computadora, la robótica, el aprendizaje por refuerzo y la IA generativa afirman estar construyendo modelos del mundo, y cada una entiende algo bastante diferente. Un modelo de video que produce llamas hermosas pero físicamente imposibles, un modelo de lenguaje improvisando un juego jugable, y un motor de física que simula fielmente la combustión, todos reciben el mismo nombre.
Los antiguos griegos nunca pudieron ponerse de acuerdo sobre de qué estaba hecho el mundo, si de fuego, agua o átomos indivisibles, porque "mundo" nunca fue una sola cosa. Siempre fue un sustituto de cualquier totalidad que un pensador necesitara para razonar. La IA ha heredado el mismo problema, justo en el momento en que el campo necesita precisión.
El bucle debajo de la taxonomía
Superar esa confusión comienza con un diagrama más antiguo que cualquier tecnología en cuestión. Los libros de texto de aprendizaje por refuerzo, incluido el canónico Sutton y Barto, han usado una versión de la misma imagen durante décadas para describir cómo un agente interactúa con un mundo. El nombre formal de esta imagen es el proceso de decisión de Markov parcialmente observable, o POMDP, y la definición original del término "modelo del mundo" pertenece a esa tradición.
Un agente, que puede ser una persona, un robot o un sistema de software, realiza acciones. Esas acciones afectan el estado del mundo. El agente nunca ve el estado directamente. Lo que llega al agente son observaciones: los fotones que caen en una retina, las lecturas de un sensor y los píxeles en un fotograma de video. Nuevas observaciones informan nuevas acciones, y el bucle continúa.
La palabra "estado" necesita ser desglosada, porque el significado cambia de un campo a otro. Este no es el estado del químico, la diferencia entre sólido, líquido y gaseoso. Este es el estado del físico y del robótico: una descripción completa de lo que está sucediendo en el mundo en un momento dado, incluyendo cada objeto, cada posición, cada velocidad, cada propiedad. El estado es la realidad subyacente del mundo; completo en principio, pero nunca directamente visible para ningún agente dentro de él. Las observaciones son la visión parcial de esa realidad que tiene un agente. Las acciones son lo que el agente hace en respuesta.
Este bucle — del agente a la acción, al estado, a la observación y de vuelta — es la estructura que le dio al término moderno "modelo del mundo" su significado técnico. La frase en sí es más antigua, se remonta a la propuesta de Kenneth Craik en 1943 de que las mentes razonan ejecutando "modelos a pequeña escala" de la realidad, y fue incorporada a las redes neuronales a finales de los años 80 y principios de los 90. Y el bucle también explica lo que la gente quiere decir con el término hoy en día. Las diferentes cosas que ahora se llaman modelos del mundo son, de hecho, diferentes proyecciones de este mismo bucle. Cada una produce una parte diferente del mismo.
Tres funciones de un modelo del mundo
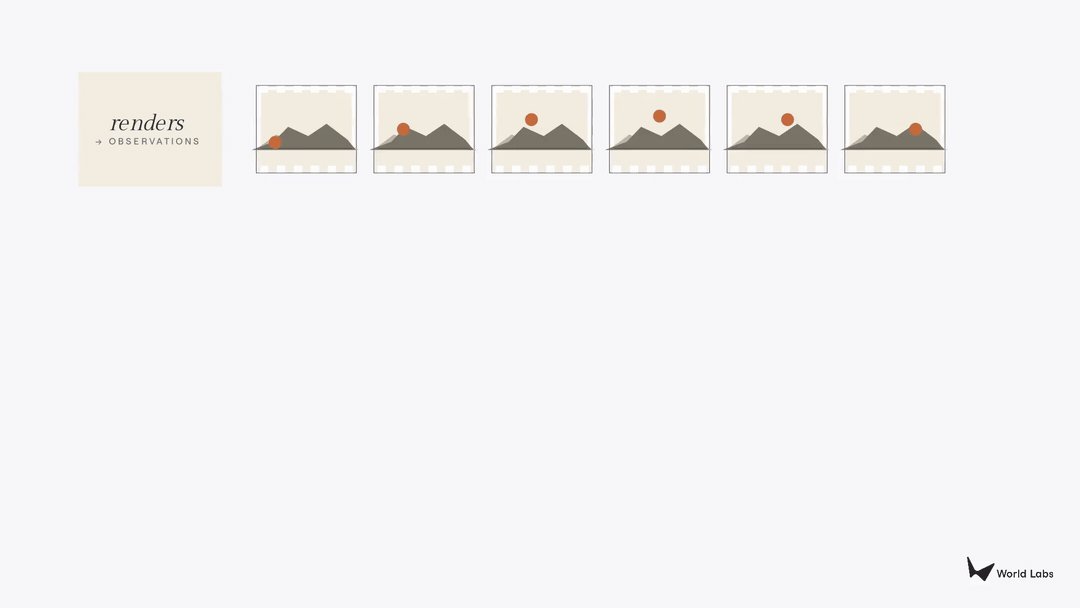
El primer tipo de modelo del mundo es un renderizador. Un renderizador produce observaciones en forma de píxeles destinados a ojos humanos, y la calidad que más importa es la fidelidad visual. Un modelo de video que convierte una instrucción de texto en una toma cinematográfica con dron es un renderizador. También lo es un sistema interactivo como Google's Genie 3, o el propio RTFM de World Labs, donde el modelo genera fotogramas en tiempo real condicionados por la entrada del usuario. El modelo no tiene una comprensión explícita de la estructura tridimensional. Produce lo que un espectador vería, no lo que es. Los edificios en la toma del dron pueden verse impecables desde arriba, pero intenta conducir por la ciudad de abajo y se desmoronan.
El segundo tipo es un simulador. Un simulador produce estado: una representación geométrica, física o dinámicamente fiel del mundo sobre la que tanto humanos como programas informáticos pueden calcular e interactuar. Mientras que el contrato del renderizador es puramente visual, el contrato del simulador es estructural, exigiendo geometría que resista la inspección, física que respete las leyes de Newton y dinámicas que se comporten como el mundo necesita comportarse dadas las leyes de la física. Un simulador sirve a dos consumidores a la vez. Los profesionales humanos, como arquitectos, diseñadores, cineastas y desarrolladores de juegos, necesitan precisión más allá de la plausibilidad visual. Los programas informáticos, como los agentes de aprendizaje por refuerzo, los controladores de robots y los vehículos autónomos, utilizan los simuladores como campos de entrenamiento donde pueden interactuar con el mundo a escala, probando escenarios que serían peligrosos, costosos o imposibles de ejecutar en la realidad.
El tercer tipo es un planificador. Un planificador produce acciones. Dada una observación y un objetivo, un planificador responde a la pregunta de qué debería hacer el agente a continuación. Esto es, en muchos sentidos, la inversa del renderizador. Mientras que un renderizador toma acciones como entrada y produce observaciones, un planificador toma observaciones como entrada y produce acciones, cerrando el bucle percepción-acción. Los modelos Visión-Lenguaje-Acción, los sistemas basados en modelos y la nueva ola de Modelos de Acción Mundial son todos intentos de planificadores: sistemas que pueden decidir lo que un robot debería hacer en un mundo no estructurado.
Estas tres categorías describen la mayor parte de lo que realmente se está lanzando hoy en día, y la distinción entre ellas es útil en la práctica. Las categorías, sin embargo, no están fundamentalmente separadas. El mismo conocimiento subyacente de cómo funciona el mundo — geometría, física, dinámica — se encuentra debajo de todas ellas. Un modelo que puede renderizar una taza desde cualquier ángulo debería, en principio, ser capaz de simular lo que sucede cuando se empuja la taza y planificar una mano para recogerla. Cada vez más, las investigaciones más interesantes difuminan deliberadamente los límites entre las tres.
GIF
Por qué la simulación es la pieza clave
De las tres categorías, el simulador recibe la menor atención pública y es la más trascendental de las tres. Este ensayo aborda esta asimetría.
El renderizador es, con diferencia, el más maduro comercialmente. Varios productos de imagen a video o de texto a video se están expandiendo rápidamente en los mercados de consumo o empresariales. El modelo Nano Banana de Google ha puesto la generación de imágenes de calidad de renderizador en manos de potencialmente cientos de millones de usuarios. La tecnología es real y los mercados son reales. Sin embargo, los renderizadores optimizan para la plausibilidad visual en lugar de la precisión física, y ese techo importa. Sus resultados son hermosos, pero no se puede confiar en ellos para diseñar un edificio o entrenar un robot.
El planificador es el más intrigante y el más incipiente, estrechamente relacionado con el campo en rápida evolución del aprendizaje robótico.** El campo ha producido demostraciones robóticas en los últimos dos años que se ven impresionantes en videos, pero se necesita franqueza sobre lo que realmente muestran esas demostraciones. Casi todas se han limitado a configuraciones de laboratorio fuertemente restringidas, con conjuntos de objetos limitados y horizontes de tareas cortos. Ninguna ha sido validada con la complejidad, variabilidad o duración que exige el despliegue en el mundo real. La brecha entre una demostración convincente y un robot que funcione de manera fiable en una cocina, un almacén o un quirófano sigue siendo enorme. Las apuestas comerciales no obstante son sustanciales. Una ola de startups bien financiadas compite por lanzar sistemas de planificación de propósito general, mientras que los actores de infraestructura más grandes están posicionando la planificación sobre pilas de simulación más amplias. Un robot que puede planificar es un robot que puede trabajar, y toda la industria corre por ser la primera en lograrlo.
La simulación es el puente entre ambos. Si el lenguaje es una abstracción del mundo y los píxeles son una proyección del mismo, entonces la geometría, la física y la dinámica son el mundo mismo. Un simulador debe funcionar a ese nivel: la columna vertebral estructural a partir de la cual se pueden derivar tanto la apariencia visual (para los renderizadores) como las consecuencias de las acciones (para los planificadores).
Un modelo que domina la simulación puede proyectar su comprensión en píxeles para el consumo humano y en predicciones de acciones para agentes incorporados. Un modelo que domina solo el renderizado, o solo la planificación, no puede hacer ninguna de las dos cosas. La superficie comercial es enorme. Solo NVIDIA Omniverse apunta a lo que la empresa estima como más de un billón de dólares de mercado direccionable en fábricas, almacenes, cadenas de suministro y gemelos digitales. El entrenamiento de robótica, las pruebas de vehículos autónomos, la visualización arquitectónica, la ingeniería y el descubrimiento de fármacos dependen de algo con forma de simulación.
Los problemas abiertos más difíciles del campo también viven allí. Los datos tridimensionales con geometría explícita, propiedades de materiales y anotaciones físicas son órdenes de magnitud más escasos que el video de internet con el que se entrenan los renderizadores. La brecha sim-real, que es la diferencia entre cómo se comportan las cosas en la simulación y cómo se comportan en la realidad, persiste. Los simuladores generativos introducen un nuevo riesgo además de eso: la geometría generada por IA puede verse correcta mientras contiene auto-intersecciones o escalas incorrectas que producen una física sin sentido. La simulación multifísica a escala, donde cuerpos rígidos, objetos deformables, fluidos y telas interactúan, sigue siendo órdenes de magnitud más costosa que la simulación de un solo dominio.
En World Labs, Marble es nuestro primer movimiento en este territorio.** Toma instrucciones multimodales (texto, imagen, video o boceto espacial) y genera entornos 3D explorables, produciendo splats gaussianos para la exploración visual junto con mallas de colisión sobre las que un motor de física puede operar. Pero Marble es solo el primer capítulo de un arco mucho más largo que se está escribiendo en todo el campo a medida que las líneas entre el renderizado, la simulación y la planificación comienzan a colapsar.
Dónde se están derrumbando los límites y qué viene después
Pero queda más por venir. El patrón más importante en el campo en este momento es que las tres categorías están empezando a fusionarse entre sí. La idea compartida es que el conocimiento necesario para renderizar un mundo, simularlo y actuar en él es en gran medida el mismo. Continuando con el ejemplo anterior, un modelo que realmente entiende cómo una taza se asienta sobre una mesa (su geometría, propiedades del material, respuesta a la fuerza, etc.) debería poder renderizar esa taza desde cualquier ángulo, simular lo que sucede cuando se empuja la taza y planificar para que una mano la recoja. Las tres categorías son tres proyecciones de una única comprensión subyacente.
Por ejemplo: un número pequeño pero creciente de trabajos recientes de varios laboratorios de robótica han demostrado que — al menos conceptualmente — un renderizador de video preentrenado puede usarse como columna vertebral para la predicción conjunta de mundo y acción, lo que sugiere un puente entre el renderizador y el planificador al permitir que un solo modelo imagine lo que sucederá y qué hacer. Marble de World Labs ya produce splats gaussianos y mallas de colisión a partir de un solo modelo, disolviendo el límite entre el renderizador y el simulador. Cada nivel está pasando de ser una salida pasiva a un sistema interactivo, con renderizadores condicionados por acciones, simuladores que generan mundos más controlables y editables, y planificadores que deliberan en lugar de solo reaccionar.
El punto final lógico es un modelo del mundo unificado: un modelo fundacional que pueda renderizar vistas fotorrealistas, producir estructura físicamente precisa y planificar secuencias de acciones, cambiando entre modalidades de salida según lo que necesite el consumidor downstream. Todavía nos enfrentaremos a una serie de desafíos desalentadores. El panorama de datos es desigual, con renderizadores inundados de video de internet mientras que los simuladores y planificadores se enfrentan a una escasez aguda de activos 3D y demostraciones robóticas. Optimizar para la belleza visual puede sacrificar la precisión que un robot o una simulación de alta fidelidad necesita. Conciliar estas tensiones dentro de una sola arquitectura es el problema abierto definitorio en la investigación de modelos del mundo hoy en día, y esto es lo que World Labs se propone hacer a medida que continuamos evolucionando Marble.
GIF
La dirección, sin embargo, es clara. La misma apuesta que el campo ha estado haciendo desde finales de los años 80 — que un modelo del mundo suficientemente rico es todo lo que cualquier agente necesita para ver mundos, construirlos y actuar en ellos — es la apuesta que ahora impulsa a toda una generación de investigación. Lo que le da peso a esa "gran apuesta" es la convergencia ya en marcha: tres hilos, cada uno impulsando y moldeando industrias multimillonarias por sí solo, que comenzaron como programas de investigación separados están empezando a comportarse como uno solo. En conjunto, a medida que los límites entre ellos colapsan, remodelarán algo más grande: la relación entre la inteligencia de las máquinas y el mundo físico que habita — el largo arco de la inteligencia espacial.
El lenguaje les dio a las máquinas una forma de hablar sobre ese mundo. Los modelos del mundo son cómo las máquinas finalmente llegarán a entenderlo, imaginarlo, razonar e interactuar con él.


