เราได้ติดตั้ง Cerebras Wafer Scale Engines ร่วมกับ GPU เพื่อส่งมอบโทเคนที่รวดเร็วปานสายฟ้าในระดับสเกลใหญ่
โลกกำลังหิวกระหายโทเคนที่เร็วสุดขีด ในปี 2026 Cerebras พบกับความต้องการที่ไม่อาจอิ่มตัวได้สำหรับการทำ inference ที่รวดเร็ว ทั้งบนคลาวด์ inference ของเราและผ่านพาร์ทเนอร์ของเรา เพื่อตอบสนองความต้องการนี้ เราจึงเริ่มพัฒนา disaggregated inference (การแยกส่วนการประมวลผล inference): โดยให้ GPU รับหน้าที่ประมวลผลพรอมต์ (prefill) และระบบของ Cerebras รับหน้าที่สร้างผลลัพธ์ (decode)
โซลูชันนี้เปิดใช้งานจริงแล้วในสภาพแวดล้อมการผลิต และสามารถส่งมอบโทเคนได้มากกว่าเดิมถึงห้าเท่าต่อเมกะวัตต์ ด้วยความเร็วระดับอัลตราฟาสต์แบบเดียวกับที่ Cerebras ทำได้เสมอมา
ตอนนี้เราสามารถให้บริการโทเคนที่เร็วสุดขีดได้มากขึ้นผ่าน Cerebras Inference Cloud เพื่อตอบสนองความต้องการของตลาด นอกจากนี้ พาร์ทเนอร์ด้านโครงสร้างพื้นฐานยังสามารถใช้ประโยชน์จากโซลูชัน disaggregated ของ Cerebras เพื่อเพิ่มจำนวนโทเคนที่เร็วสุดขีดในดาต้าเซ็นเตอร์ของตนเองได้ด้วย
ควบคู่ไปกับ CS-4 ที่เราเพิ่งประกาศเปิดตัว การขยายกำลังการผลิตอย่างก้าวกระโดด และแผนรองรับกำลังไฟดาต้าเซ็นเตอร์ 700MW โซลูชัน disaggregated inference จะช่วยให้ Cerebras และพาร์ทเนอร์สามารถให้บริการโทเคนที่เร็วสุดขีดได้มากขึ้นอีกมากในปี 2027 และปีต่อ ๆ ไป ในบล็อกนี้เราจะพูดถึง:
- ความจำเป็นในการเพิ่มศักยภาพการทำ inference แบบอัลตราฟาสต์
- เหตุใด Cerebras จึงมีความได้เปรียบในการทำ decode
- ผลลัพธ์การใช้งานจริงของ Cerebras disaggregated inference
- Cerebras disaggregated inference สำหรับพาร์ทเนอร์ด้านโครงสร้างพื้นฐาน
ความจำเป็นในการเพิ่มศักยภาพการทำ inference ที่รวดเร็ว
แอปพลิเคชันแบบ Agentic อย่าง Muse, Copilot และ Codex กำลังเติบโตอย่างรวดเร็ว และต้องการ inference ที่มีปฏิสัมพันธ์สูงเพื่อดึงดูดให้ผู้ใช้มีส่วนร่วมต่อไป เพื่อตอบสนองความต้องการที่เพิ่มขึ้นของแอปพลิเคชันเหล่านี้ในสภาพแวดล้อมที่มีข้อจำกัดด้านพลังงาน อุตสาหกรรมของเราจำเป็นต้องส่งมอบศักยภาพการทำ inference ต่อเมกะวัตต์ให้มากขึ้นอย่างมีนัยสำคัญ พร้อมกับความเร็วในการตอบสนองที่ทำให้แอปพลิเคชันเหล่านี้ใช้งานได้จริง

แหล่งข้อมูล: Goldman Sachs Research, “AI Agents Forecast to Boost Tech Cash Flow as Usage Soars,” 20 พฤษภาคม 2026; ข้อมูลประมาณการศักยภาพดาต้าเซ็นเตอร์ของ Goldman Sachs ตามรายงานของ Investing.com
นั่นคือเหตุผลที่ Cerebras ลงทุนใน disaggregation การจับคู่ prefill accelerator สำหรับประมวลผลพรอมต์เข้ากับ Cerebras System สำหรับสร้างคำตอบ ช่วยเพิ่มปริมาณงาน (throughput) ของโทเคนต่อเมกะวัตต์ ในขณะที่ยังคงรักษาความเร็วในการสร้างผลลัพธ์ระดับอัลตราฟาสต์ของ Cerebras ไว้ได้ สำหรับผู้ให้บริการ inference นั่นหมายถึงศักยภาพที่มากขึ้นในการให้บริการลูกค้า และโอกาสในการสร้างรายได้ที่สูงขึ้นจากงบประมาณด้านพลังงานเท่าเดิม
เหตุใด Cerebras จึงมีความได้เปรียบในการทำ decode
คำขอ inference มีสองขั้นตอนหลัก ขั้นตอนแรกคือการประมวลผลพรอมต์ หรือที่เรียกว่า prefill ซึ่งจะประมวลผลข้อมูลนำเข้าและสร้างสถานะกลางของโมเดล ขั้นตอนที่สองคือการสร้างคำตอบ หรือที่เรียกว่า decode ซึ่งจะนำสถานะนั้นมาใช้สร้างโทเคนผลลัพธ์ มีหลายวิธีในการแบ่งภาระงาน inference เช่น draft–target และ attention–FFN เป็นต้น แต่การแยก prefill ออกจาก decode นั้นให้ความได้เปรียบเป็นพิเศษเมื่อเป้าหมายคือการทำ inference ที่มีปฏิสัมพันธ์สูง

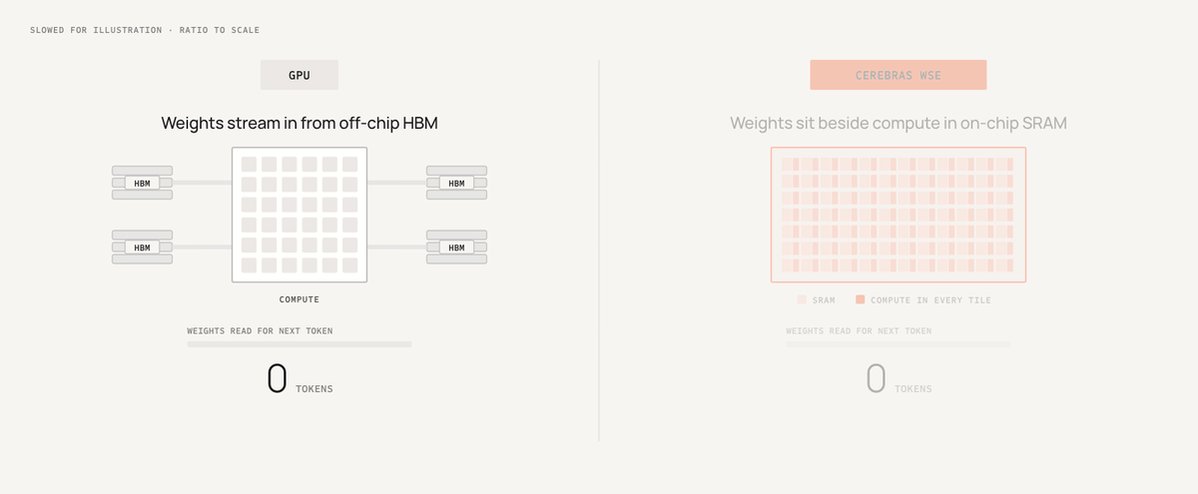
Decode เป็นกระบวนการแบบ autoregressive ซึ่งหมายความว่าโมเดลจะสร้างโทเคนทีละตัว โดยใช้โทเคนที่สร้างขึ้นแต่ละตัวเป็นอินพุตเพื่อสร้างโทเคนถัดไป แต่ละขั้นตอนหมายถึงการอ่านข้อมูลโมเดลจากหน่วยความจำอีกครั้ง แบนด์วิดท์ของหน่วยความจำจึงมีความสำคัญอย่างมาก ในวงการ inference ระดับอัลตราฟาสต์ ชิปที่ใช้ SRAM เป็นหลักจะมีความได้เปรียบเพราะสามารถเก็บข้อมูลนั้นไว้บนชิปและอ่านได้เร็วกว่ามาก Cerebras ยกระดับสิ่งนี้ไปสู่ระดับเวเฟอร์ (wafer scale) ด้วย SRAM ขนาดหลายสิบギกะไบต์และแบนด์วิดท์หน่วยความจำหลายสิบเพตะไบต์ต่อวินาทีบนชิปเดียว ซึ่งคิดเป็นความจุ SRAM มากกว่า 350 เท่า และแบนด์วิดท์หน่วยความจำมากกว่า 5,400 เท่าเมื่อเทียบกับ GPU GB300 ทั่วไป สิ่งนี้ทำให้ระบบ Cerebras สามารถรองรับคำขอพร้อมกันและเลเยอร์ของโมเดลได้มากขึ้นโดยตรงบนชิป ช่วยให้ CS-3, CS-4 และ CS-5 บรรลุความเร็วระดับอัลตราฟาสต์พร้อมกับปริมาณงานที่น่าสนใจ
GIF
ผลลัพธ์การใช้งานจริงของ Cerebras disaggregated inference
การจับคู่ระบบ Cerebras ซึ่งปรับแต่งมาเพื่อการ decode แบบอัลตราฟาสต์ เข้ากับ accelerator ที่เหมาะกับความต้องการด้านการคำนวณของ prefill เช่น AMD Instinct GPUs ทำให้สามารถส่งมอบ inference ระดับอัลตราฟาสต์ปริมาณมหาศาลในระดับสเกลใหญ่ได้ ในการใช้งานจริงบน Cerebras Inference Cloud นั้น AMD Instinct GPUs จะทำหน้าที่ประมวลผลพรอมต์ และระบบ Cerebras CS-3 จะทำหน้าที่สร้างคำตอบ การย้ายการประมวลผลพรอมต์ไปให้ GPU ทำให้ระบบ Cerebras สามารถทุ่มศักยภาพทั้งหมดไปกับการสร้างคำตอบได้ ในการใช้งานจริงที่เราวัดผล การผสมผสานนี้ให้ปริมาณงานต่อเมกะวัตต์สูงกว่าการตั้งค่าแบบใช้ CS-3 เพียงอย่างเดียวถึง 5 เท่า โดยไม่สูญเสียความเร็วในการสร้างโทเคนเลย

แหล่งข้อมูล: เอนด์พอยต์ GPT-OSS-120B ที่แชร์ร่วมกันเมื่อวันที่ 14 พฤศจิกายน ผ่าน Cerebras Inference Cloud แสดงปริมาณงานต่อเมกะวัตต์ก่อนและหลังเปิดใช้งาน disaggregated inference โดยปรับค่ามาตรฐานเทียบกับฐานอ้างอิงของ aggregated inference (1×)
เราวางแผนที่จะปรับใช้ disaggregated inference อย่างกว้างขวางครอบคลุมกำลังไฟหลายร้อยเมกะวัตต์ทั้งใน Cerebras Inference Cloud และการติดตั้งของพาร์ทเนอร์ภายในสิ้นปี 2027 เป้าหมายของเราคือการเพิ่มศักยภาพการทำ inference ระดับอัลตราฟาสต์ที่พร้อมให้บริการแก่ลูกค้าของเรา
Cerebras disaggregated inference สำหรับพาร์ทเนอร์ด้านโครงสร้างพื้นฐาน
โซลูชัน Cerebras disaggregated inference ยังถูกออกแบบมาให้พาร์ทเนอร์ของเราสามารถนำไปใช้ได้ด้วย พาร์ทเนอร์ด้านโครงสร้างพื้นฐานสามารถติดตั้งคลัสเตอร์ disaggregated inference โดยอิงตาม reference architecture ที่ Cerebras จัดเตรียมไว้ให้ ซึ่งเป็นการจัดวาง prefill accelerator ที่พวกเขาเลือกไว้ร่วมกับระบบ Cerebras ภายในเครือข่ายเดียวกัน สำหรับการผสานรวมซอฟต์แวร์ พาร์ทเนอร์สามารถเลือกใช้ชุดซอฟต์แวร์ disaggregated แบบ end-to-end ของ Cerebras หรือ SDK สำหรับ decode เท่านั้นก็ได้
- ชุดซอฟต์แวร์ disaggregated แบบ end-to-end เหมาะที่สุดสำหรับพาร์ทเนอร์ที่ต้องการลดเวลาในการออกสู่ตลาด ประกอบด้วย:
- เฟรมเวิร์ก disaggregated inference สำหรับกำหนดเส้นทางคำขอร้องระหว่างกลุ่ม prefill และ decode รวมถึงจัดการศักยภาพและสถานะการทำงานของ replica
- เอนจิน prefill สำหรับประมวลผลพรอมต์โดยใช้เอนจิน inference แบบโอเพนซอร์ส เช่น vLLM หรือ SGLang
- เอนจิน decode ของ Cerebras สำหรับสร้างคำตอบบนระบบ Cerebras
- ซอฟต์แวร์ KV Portal ซึ่งเป็นอินเทอร์เฟซสำหรับถ่ายโอนสถานะกลางของโมเดล รวมถึง key-value caches ระหว่างเอนจิน prefill และ decode ผ่าน RDMA
SDK สำหรับ decode เท่านั้นเหมาะที่สุดสำหรับพาร์ทเนอร์ที่ต้องการควบคุมระบบด้วยตนเอง ด้วย SDK นี้ พาร์ทเนอร์สามารถนำเฟรมเวิร์ก inference และเอนจิน prefill ของตนเองมาใช้ร่วมกับเอนจิน decode ของ Cerebras และซอฟต์แวร์ KV Portal ได้ นอกจากนี้ SDK สำหรับ decode เท่านั้นยังมีเครื่องมือช่วยพัฒนา เช่น mock Cerebras decode replica และการผสานรวมอ้างอิงไปยังเฟรมเวิร์ก disaggregated inference และเอนจิน prefill แบบโอเพนซอร์ส

พาร์ทเนอร์ในกลุ่ม early-access ซึ่งรวมถึง Amazon Web Services, Fireworks AI, Gimlet Labs และ General Compute สามารถเข้าถึงโซลูชัน disaggregation ของ Cerebras สำหรับการติดตั้งของพวกเขาได้แล้ว ขณะนี้เรากำลังขยายสิทธิ์การเข้าถึงไปยังพาร์ทเนอร์รายอื่น ๆ ที่ต้องการนำเสนอ inference ระดับอัลตราฟาสต์ให้แก่ลูกค้าของตนในระดับสเกลใหญ่
หากต้องการพูดคุยเกี่ยวกับผลลัพธ์ โซลูชัน หรือโอกาสในการติดตั้งโดยละเอียดเพิ่มเติม ติดต่อเราได้ที่ที่นี่


