Cerebras Wafer Scale Engine'leri, ölçeklenebilir şekilde ışık hızında token üretmek için GPU'larla birlikte devreye aldık
Dünya ultra hızlı token'lara aç. 2026'da Cerebras olarak hem kendi çıkarım bulutumuzda hem de iş ortaklarımız aracılığıyla hızlı çıkarıma yönelik doyumsuz bir talep gördük. Bu talebi karşılamak için ayrıştırılmış çıkarım (disaggregated inference) geliştirmeye başladık: GPU'lar prompt işleme (prefill), Cerebras sistemleri ise çıktı üretimi (decode) aşamasını üstleniyor.
Bu çözüm artık üretim ortamında ve aynı ultra hızlı Cerebras hızlarında megawatt başına beş kat daha fazla token sunuyor.
Artık pazar talebini karşılamak üzere Cerebras Inference Cloud üzerinden daha fazla ultra hızlı token sunabiliyoruz. Altyapı iş ortakları da kendi veri merkezlerinde daha fazla ultra hızlı token elde etmek için Cerebras ayrıştırılmış çıkarım çözümünden yararlanabilir.
Yakın zamanda duyurduğumuz CS-4, büyük ölçüde artırdığımız üretim kapasitemiz ve planladığımız 700 MW'lık veri merkezi kapasitesiyle birlikte ayrıştırılmış çıkarım; Cerebras'ın ve iş ortaklarının 2027 ve sonrasında çok daha fazla ultra hızlı token sunmasını sağlayacak. Bu blog yazısında şu konuları ele alıyoruz:
- Daha fazla ultra hızlı çıkarım kapasitesine duyulan ihtiyaç
- Decode aşamasında Cerebras'ın neden avantajlı olduğu
- Cerebras ayrıştırılmış çıkarımının üretim ortamındaki sonuçları
- Altyapı iş ortakları için Cerebras ayrıştırılmış çıkarımı
Daha fazla hızlı çıkarım kapasitesine duyulan ihtiyaç
Muse, Copilot ve Codex gibi ajan tabanlı uygulamalar hızla büyüyor ve kullanıcıların ilgisini canlı tutmak için son derece etkileşimli bir çıkarım süreci gerektiriyor. Enerji kaynaklarının kısıtlı olduğu bir ortamda bu uygulamaların artan talebini karşılamak için sektörümüzün, bu uygulamaları kullanışlı kılacak yanıt hızlarında megawatt başına çok daha fazla çıkarım kapasitesi sunması gerekiyor.

Kaynaklar: Goldman Sachs Research, “AI Agents Forecast to Boost Tech Cash Flow as Usage Soars” (Kullanım Arttıkça Yapay Zeka Ajanlarının Teknoloji Nakit Akışını Güçlendirmesi Bekleniyor), 20 Mayıs 2026; Investing.com tarafından aktarılan Goldman Sachs veri merkezi kapasitesi tahminleri
Cerebras'ın ayrıştırmaya yatırım yapmasının nedeni tam da budur. Prompt işleme için bir prefill hızlandırıcısını, yanıt üretimi için Cerebras Sistemi ile eşleştirmek; Cerebras'ın ultra hızlı üretim hızlarını korurken megawatt başına token verimini artırır. Çıkarım hizmeti sağlayıcıları için bu, aynı enerji bütçesiyle müşterilere hizmet verecek daha fazla kapasite ve daha yüksek gelir potansiyeli anlamına gelir.
Decode aşamasında Cerebras neden avantajlı?
Bir çıkarım isteğinin iki ana aşaması vardır. Prefill olarak bilinen prompt işleme aşaması girdiyi işler ve ara model durumunu oluşturur. Decode olarak bilinen yanıt üretimi aşaması ise çıktı token'larını oluşturmak için bu durumu kullanır. Taslak-hedef (draft–target) ve dikkat-FFN (attention–FFN) gibi çıkarım iş yükünü bölmenin birçok yolu vardır; ancak amaç son derece etkileşimli bir çıkarım olduğunda prefill'i decode'dan ayırmak benzersiz bir avantaj sağlar.

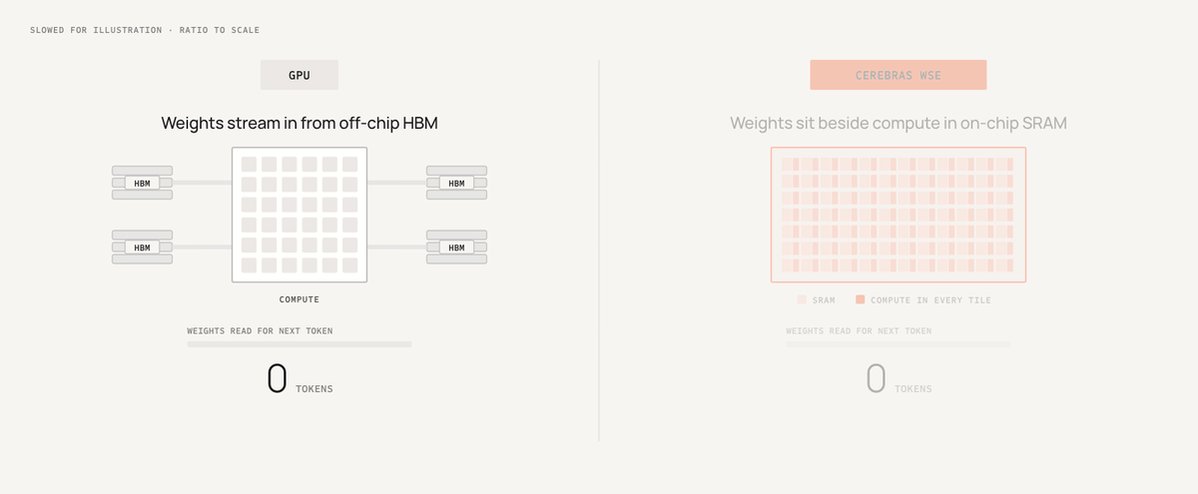
Decode otoregresiftir. Yani model, ürettiği her token'ı bir sonrakini üretmek için girdi olarak kullanarak tek seferde bir token üretir. Her adım, model verilerinin bellekten yeniden okunması anlamına geldiğinden bellek bant genişliği büyük önem taşır. Ultra hızlı çıkarım alanında SRAM odaklı çipler, bu verileri çip üzerinde tutabildikleri ve çok daha hızlı okuyabildikleri için avantajlıdır. Cerebras bunu wafer ölçeğine taşıyor: tek bir çip üzerinde onlarca gigabayt SRAM ve saniyede onlarca petabayt bellek bant genişliği sunuyor. Bu, tipik bir GB300 GPU'nun 350 katı SRAM kapasitesi ve 5.400 katı bellek bant genişliği demek. Böylece Cerebras sistemi, daha fazla eşzamanlı isteği ve model katmanını doğrudan çip üzerinde barındırabiliyor; bu da CS-3, CS-4 ve CS-5'in cazip bir verimlilikle ultra hızlı hızlara ulaşmasını sağlıyor.
GIF
Cerebras ayrıştırılmış çıkarımının üretim ortamındaki sonuçları
Ultra hızlı decode için optimize edilmiş Cerebras sistemlerini, AMD Instinct GPU'lar gibi prefill'in hesaplama ihtiyaçlarına uygun hızlandırıcılarla eşleştirmek, ölçeklenebilir düzeyde muazzam miktarda ultra hızlı çıkarım sunulmasını mümkün kılıyor. Cerebras Inference Cloud üzerindeki bir üretim dağıtımında AMD Instinct GPU'lar prompt'ları işlerken, Cerebras CS-3 sistemleri yanıtları üretiyor. Prompt işlemenin GPU'lara taşınması, Cerebras sistemlerinin hizmet kapasitesini tamamen yanıt üretimine ayırmasına olanak tanıyor. Ölçümlediğimiz üretim dağıtımında bu kombinasyon, token üretim hızında hiçbir kayıp olmadan yalnızca CS-3 kullanılan bir yapılandırmaya kıyasla megawatt başına 5 kat daha fazla verim sağladı.

Kaynak: 14 Kasım'da Cerebras Inference Cloud üzerinden paylaşılan GPT-OSS-120B uç noktasının, ayrıştırılmış çıkarım etkinleştirilmeden önceki ve sonraki megawatt başına verimi; toplu çıkarım (aggregated inference) temel değerine (1×) göre normalize edilmiştir.
2027'nin sonuna kadar Cerebras Inference Cloud'da ve iş ortağı dağıtımlarında yüzlerce megawattlık bir alanda ayrıştırılmış çıkarımı yaygın şekilde devreye almayı planlıyoruz. Amacımız, müşterilerimizin kullanımına sunulan ultra hızlı çıkarım kapasitesini artırmak.
Altyapı iş ortakları için Cerebras ayrıştırılmış çıkarımı
Cerebras ayrıştırılmış çıkarım çözümü, iş ortaklarımızın da benimsemesi için tasarlandı. Altyapı iş ortakları, Cerebras tarafından sağlanan referans mimariye dayalı ayrıştırılmış çıkarım kümeleri kurarak seçtikleri prefill hızlandırıcılarını ve Cerebras sistemlerini tek bir ağ altında bir araya getirebilir. Yazılım entegrasyonu için iş ortakları, Cerebras'ın uçtan uca ayrıştırılmış yazılım yığınını veya yalnızca decode'a yönelik SDK'yı tercih edebilir.
- Uçtan uca ayrıştırılmış yazılım yığını, pazara çıkış süresini optimize etmek isteyen iş ortakları için en uygun seçenektir. Şunlardan oluşur:
- İstekleri prefill ve decode havuzları arasında yönlendiren, replika kapasitesini ve sağlığını yöneten bir ayrıştırılmış çıkarım çerçevesi.
- vLLM veya SGLang gibi açık kaynaklı çıkarım motorlarını kullanarak prompt'ları işleyen bir prefill motoru.
- Cerebras sistemlerinde yanıt üretimi sağlayan bir Cerebras decode motoru.
- Anahtar-değer önbellekleri dahil olmak üzere ara model durumunu RDMA üzerinden prefill ve decode motorları arasında aktarmaya yarayan bir arayüz olan KV Portal yazılımı.
Yalnızca decode'a yönelik SDK, kontrolü optimize etmek isteyen iş ortakları için en uygun seçenektir. Bu SDK ile iş ortakları, kendi çıkarım çerçevelerini ve prefill motorlarını Cerebras decode motoru ve KV Portal yazılımıyla birlikte kullanabilir. Ayrıca yalnızca decode'a yönelik SDK; bir simüle edilmiş Cerebras decode replikası ile açık kaynaklı bir ayrıştırılmış çıkarım çerçevesi ve prefill motoruna yönelik referans entegrasyon gibi geliştirme yardımcıları da sunar.

Amazon Web Services, Fireworks AI, Gimlet Labs ve General Compute'un da aralarında bulunduğu erken erişim iş ortakları, dağıtımları için Cerebras ayrıştırma çözümüne zaten erişebiliyor. Şimdi ise ultra hızlı çıkarımı müşterilerine ölçekli olarak sunmak isteyen diğer iş ortaklarına da erişim imkanı sağlıyoruz.
Sonuçları, çözümleri veya dağıtım fırsatlarını daha ayrıntılı görüşmek için buradan bizimle iletişime geçebilirsiniz.


