تفريغ الفيديو
تفريغ الفيديو
معاينة المحتوى
الوصف
تحويل مقاطع الفيديو أو الصوت المحلية إلى ملفات ترجمة SRT مزودة طوابع زمنية ونصوص عادية، مع تفضيل المعالجة المحلية ودعم خدمات التعرف على الكلام البعيدة المُكوّنة بموافقتك.
مهارات ذات صلة
عرض الكل كتابة
تحويل الصوت إلى مسودة
حوّل ملفًا صوتيًا أو مذكرة صوتية أو فيديو يحتوي على كلام أو نصًا إلى مسودة واحدة متماسكة قابلة للتحرير. تُفرَّغ المقاطع التي لا تحتوي على نص كلام تلقائيًا، مع مواصلة العمل في الخلفية عند الحاجة، لذلك لا يضطر المستخدم إلى العودة لاستئناف سير العمل.
 بحث
من الصوت إلى المهام والقرارات
حوّل ملفًا صوتيًا أو نصًا مفرغًا إلى سجل موجز وقابل للتحرير للقرارات والمهام والمسؤولين والتواريخ والعوائق والأسئلة المفتوحة. تُفرَّغ الأجزاء الصوتية غير المتاحة تلقائيًا، مع مواصلة العمل في الخلفية عند الحاجة، قبل اقتراح أي إجراءات اختيارية للوكيل.
 بحث
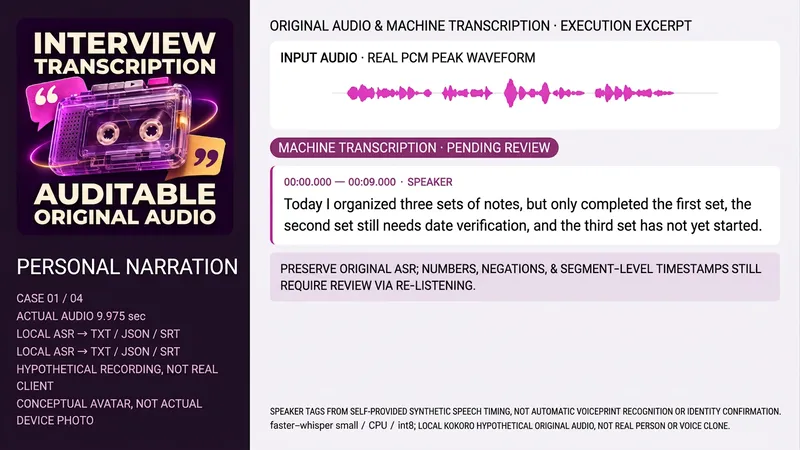
تفريغ المقابلات وتنظيم المتحدثين
مناسب لمن يحتاجون إلى تنظيم مقابلات أو اجتماعات أو تسجيلات دورات تدريبية مصرح بها. يقدم الملف الأصلي، اللغة، الغرض، النصوص الحرفية المتوفرة أو تعيينات أوقات المتحدثين الموثوقة؛ لا يمكن تأكيد الهيئات بناءً على الصوت وحده، ولا يتم تحويل النصوص إلى كلمات مسموعة فعلياً. الاحتفاظ بالصوت الأصلي وقيمة التجزئة -> قراءة المدة والمسار -> النسخ الآلي الفعلي -> التنظيم وفقاً للترسيم الزمني الحقيقي -> تسمية المتحدثين المجهولين بوجود أدلة توقيت -> مراجعة الاستماع للأرقام والنفي والأسماء والشكوك مقابل الصوت الأصلي -> تسليم ملفات TXT وJSON وSRT وملاحظات التغطية. فصل المسودة الآلية ومراجعة الاستماع والملخصات؛ الحفاظ على المقاطع غير الواضحة قيد الانتظار وعدم إكمال الكلمات لضمان السلاسة. عدم وجود أدوات صوتية أو نسخ آلي يعني عدم التفريغ. تتضمن الحزمة مساعداً محلياً أصلياً متكاملاً: Python3 وFFmpeg/FFprobe وfaster-whisper وذاكرة التخزين المؤقت small المعدة مسبقاً، بوضع CPU/int8 والوضع local_files_only، دون تنزيل الأوزان تلقائياً. عند توفير خريطة متحدثين موثوقة تحدد نقاط البداية والنهاية والتسميات المجهولة، يتم النسخ الفعلي وتعيين الوقت حسب النوافذ؛ وفي حال عدم توفر الخريطة تكون الأوقات مجهولة. لا يقوم المساعد بفصل البصمات الصوتية أو التعرف على الهوية تلقائياً، ولا تتضمن الحزمة أوزان أو حسابات أو مفاتيح. الأمثلة الأربعة مخصصة لإملاء شخصي صيني مقترح، ومقابلة صينية لشخصين، ووصف دورة إنجليزية، واجتماع صيني لشخصين، بمدة إجمالية تبلغ حوالي 40.875 ثانية. تم توليد الصوت الأصلي النهائي محلياً باستخدام إصدار ثابث من Kokoro-82M مصنف في بطاقة نموذج Apache-2.0، وهي zf_xiaobei وzm_yunjian وaf_heart، وليست أصواتاً بشرية أو مستنسخة؛ ولا يتم توزيع النماذج أو الأصوات أو الصوت التجريبي مع حزمة التثبيت. أنشأت حالات النسخ الآلي الحقيقية الأربع ملفات TXT وJSON وSRT، وجاء المتحدثون من توقيتات الكلام المُولدة، وليس من الفصل التلقائي للمتحدثين. لا تزال الحالة الحالية مسودة آلية؛ وتخضع "النسخة" للنسخ الآلي للحالة الثانية و"المسودة الأولية" للنص للمراجعة بالاستماع، دون تعديل اعتباطي للكلمات المنطوقة الفعلية. تأتي الأشكال الموجية من قمم إشارات المدخلات الفعلية وليست أشكالاً موجية زخرفية. يُوصى باستخدام GPT لتنظيم النصوص، وتخضع أدوات النسخ الآلي للأدوات الفعلية؛ ولا يتم استدعاء واجهة برمجة تطبيقات OpenAI للنسخ محلياً أو تشغيل واجهة الأوامر الأساسية. الصورة الرمزية المستقلة هي رؤية مفاهيمية من ImageGen، ولم ترجع الأداة أي طراز، ولا تُعلن عن Image2. لم تستهلك أدوات منصة YouMind وذاكرة التخزين المؤقت وتنزيل الملفات وارتباطات النماذج نقاط الاختبار؛ ويجب التأكد منها حسب البيئة الفعلي. لا يضمن النسخ وتنظيم المتحدثين التشغيل دون تبعيات بعد التثبيت. نقاط 299 هي سعر التثبيت ولا تشمل النماذج أو واجهات برمجة التطبيقات أو الخدمات الخارجية، ولا تقوم بالشراء التلقائي أو رفع المسارات الصوتية غير المعروفة سراً إلى خدمات إضافية. لا توجد وعود بصفر أخطاء، أو التعرف التام على اللهجات أو الضوضاء أو التداخل بين عدة أشخاص، أو تحديد الهوية أو الشؤون القانونية، أو الكفاءة الزمنية أو التأثير التجاري. مراجعة الاستماع المستقلة قيد الانتظار، ولا يُروج للتحقق من النصوص الحرفية.
المعلومات
- الإصدار
- v2
- آخر تحديث
- أرصدة التشغيل
- حسب الاستخدام
- النماذج
- تلقائي
