Präzise KI-Figurenbilder
Figuren wählen, Prompts und Bilder erzeugen
Präzise KI-Figurenbilder
Figuren wählen, Prompts und Bilder erzeugen
Einblicke
Beschreibung
Verwandle deine Vorstellung einer Figur in direkt nutzbare Prompts und fertige Bilder. Starte mit einer kurzen Ausgangsbeschreibung oder einer thematischen Richtung und lege nach und nach wichtige Details wie Frisur, Haarschmuck, Kleidung, Gesichtsausdruck, Pose, Kamera, Licht und Szene fest. Ob historische chinesische Dame, Cyberpunk-Mädchen, japanische Figur, realistisches Porträt oder individuelle Charakterbeschreibung – aus der gewünschten Gesamtstimmung entsteht ein stimmiges, einheitliches visuelles Konzept. Du kannst die schnelle Bildgenerierung wählen und die KI die Figurenbeschreibung automatisch vervollständigen lassen. Oder du entscheidest dich für die präzise Steuerung und passt die einzelnen Elemente per Auswahl oder individuell an. Das Ergebnis enthält strukturierte Prompts auf Deutsch und Englisch sowie einen zum Stil passenden Negative Prompt. So lassen sie sich leicht verstehen, wiederverwenden und mit gängigen Modellen wie FLUX, Midjourney und SDXL nutzen. Zusätzlich wird durch KI-Bildgenerierung ein fertiges Figurenbild erstellt. Nach der Bildgenerierung kannst du einzelne Aspekte weiter verfeinern, zum Beispiel Frisur, Gesichtsausdruck, Pose, Kameraposition, Licht, Szene oder Stil. Die übrigen Einstellungen bleiben dabei erhalten, und die vorgenommenen Änderungen werden klar gekennzeichnet. Geeignet für Charakterdesign, Figurenkonzepte, Avatar-Erstellung, Illustrationsideen und die Entwicklung visueller Gestaltungskonzepte.
Empfohlen von
Dancang
Warum wir diese Fähigkeit empfehlen
Acht strukturierte Auswahlbereiche machen aus vagen Ideen steuerbare Figurenkonzepte – mit zweisprachigen Prompts, passendem Negative Prompt, Bildgenerierung und nachvollziehbarer Feinabstimmung.
Ähnliche Fähigkeiten
Alle anzeigen Bild
Asiatische Porträt-Prompts
Dieses Skill wurde speziell für Nutzer entwickelt, die hochwertige Porträt-Prompts für KI-Bildgenerierungsplattformen erstellen möchten. Es eignet sich besonders für Kreative und Designer, die eine asiatische Ästhetik sowie reife und natürlich wirkende Frauenporträts anstreben. Das Skill verwandelt Ihre kreativen Vorstellungen in konkrete, umsetzbare Prompts und sorgt dafür, dass die generierten Bilder ansprechend und mit der jeweiligen Plattform kompatibel sind. Zu den Kernfunktionen gehören die Erstellung von Prompts auf Basis Ihrer Beschreibung für zahlreiche gängige KI-Bildmodelle wie Midjourney, SDXL, Flux, GPT Image, 豆包, 即梦 und ComfyUI. Das Skill erkennt und überarbeitet automatisch potenziell riskante Begriffe, damit die Prompt-Inhalte den Sicherheitsrichtlinien der Plattformen entsprechen und keine kindlich wirkenden, vulgären oder übermäßig auf einzelne Körperpartien fokussierten Formulierungen enthalten. Über Schnellbefehle können Sie außerdem rasch zwischen verschiedenen Bildstilen wechseln, etwa realistische Selfies, Aufnahmen im Stil kommerzieller Magazine, hochwertiges Cosplay, Cyberpunk oder klassische chinesische Ästhetik. Auch die Reparatur von Prompts auf Grundlage von Rückmeldungen zu fehlgeschlagenen Generierungen wird unterstützt. Ganz gleich, ob Sie ein Modemagazin-Cover, ein filmisches Porträt oder das Design einer 3D-CG-Figur erstellen möchten: Dieses Tool liefert präzise sprachliche Beschreibungen und Parametervorschläge. Die fertigen Prompts werden für die ausgewählte Plattform optimiert – etwa als natürliche, flüssige englische Langsätze für Midjourney, als klare Gruppen positiver und negativer Schlüsselwörter für SDXL/Flux oder als detaillierte, modulare Parameterfelder für ComfyUI. So können Sie effizient KI-Porträts erstellen, die Ihren Vorstellungen entsprechen.
 Bild
Urbane Modefiguren in Aquarell
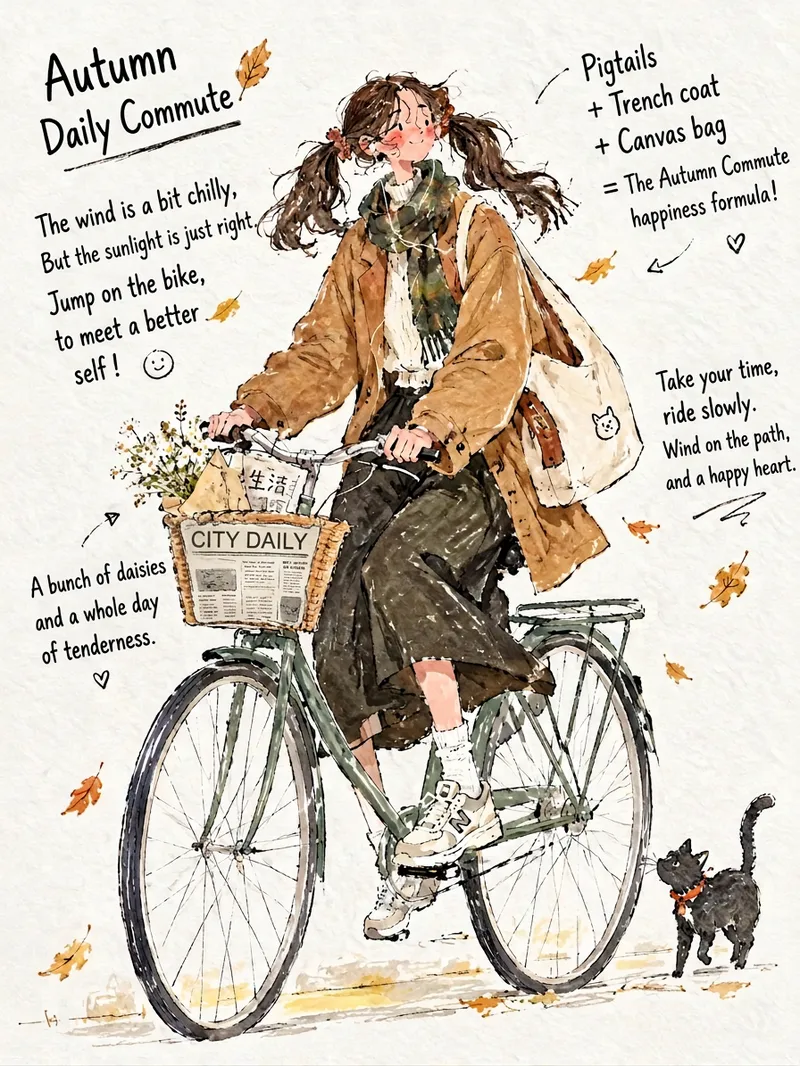
Verwandle eine Person, ein Outfit, eine urbane Szene oder ein kreatives Thema in ein direkt für die Bildgenerierung nutzbares Konzept für eine handgemalte Aquarell-Modeillustration. Der Fokus liegt auf einer entspannten, selbstbewussten und kunstvollen Ästhetik urbaner Figuren – mit lang gezogenen, leicht übertriebenen Modeillustrationsproportionen, abwechslungsreichen lässigen Outfits, hellen und warmen Farben sowie alltagsnahen Requisiten wie Kaffeetassen, Blumensträußen, Büchern, Haustieren und Einkaufstaschen. So entsteht eine leichte, natürliche Geschichte zwischen Figur und Umgebung. Du erhältst klare Angaben zu Figur und Bild, vollständige chinesische Prompts für die Bildgenerierung, Negativ-Prompts und Kompositionsvorschläge für verschiedene Zwecke. Das Bild betont Aquarell- oder Gouacheflächen, Tuschelinien, die Haptik von Buntstiften oder Markern, natürliche Farbverläufe, Papierstruktur und die Wärme handgemachter Gestaltung. Gleichzeitig wird auf eine großzügige Komposition mit Freiflächen wie auf einer Journalseite oder Illustrationskarte geachtet. Von dir vorgegebene chinesische Texte können natürlich in das Bild integriert werden; ohne Vorgabe lassen sich passend zum Thema kurze Texte mit handschriftlichem Charakter ergänzen. Ob urbane Frauen, Männer, nichtbinäre Figuren oder erwachsene Modefiguren ohne festgelegtes Geschlecht – alle lassen sich nach deinen Vorgaben gestalten. Geeignet ist das Skill für Modeillustrationen, Social-Media-Bilder, Handy- oder Computerhintergründe, Illustrationskarten und visuelle Konzepte rund um den Lifestyle. Gewöhnliche Porträts, fotorealistische Personenbilder oder komplexe Filmszenen gehören dagegen nicht zu den Hauptanwendungen.
 Bild
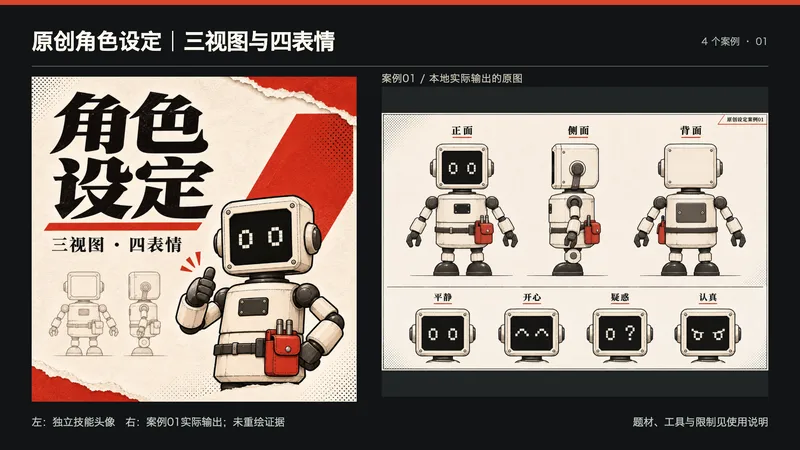
原创角色设定|三视图与四表情
适合为插画、分镜、吉祥物设计准备角色参考的创作者。 提供:角色用途、年龄或物种、体型、服装、配饰、画风与避用项;有授权参考图可以同时提供。 处理:先建立比例、颜色、角色自身左右和背部结构锚点,再调用当前图像工具生成正面、侧面、背面及四种表情,逐项检查服装与配饰。 交付:实际二维设定图、角色锚点、提示词及一致性检查记录。图像可用于后续插画与建模沟通,不包含3D模型、绑定动画、可编辑分层或工业结构。 使用:发送简报或参考图,确认角色描述与新增设定,生成后核对左右、背面及遮挡细节。有明显偏差时进行针对性修订,不能保证跨轮次绝对一致。 依赖:文字模型及支持生成/参考图编辑的图像工具。偏好GPT与GPT Image 2时须以平台实际可选模型为准;本地使用内置image_gen完成四个虚构原创案例,工具未返回图像模型编号,不能宣称已指定Image 2。YouMind端未追加运行测试、未验证持久模型绑定。运行时平台模型消耗或第三方API费用不包含在199积分售价内。无图像工具/额度时会明确未出图,不以提示词冒充成图。 四张展示图为本地实际输出,未重绘证据。仍可能有衣褶、细小配饰和文字偏差,发布或精细制作前请人工核对。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
Informationen
- Version
- v2
- Zuletzt aktualisiert
- Credits pro Ausführung
- Nach Verbrauch
- Modelle
- Automatisch
