Bio/Med Tiefenrecherche
Bio/Med Tiefenrecherche
Einblicke
Beschreibung
Anwendungsszenario: Führen Sie eine Runde der wissenschaftlichen Literatursuche in den Bereichen Biologie/Biomedizin durch und liefern Sie dem Benutzer detaillierte und zuverlässige Ergebnisse. 1. Nach der Suchanfrage des Benutzers zerlegt das System die Frage und die Schlüsselwörter. 2. Verwendung öffentlicher, reproduzierbarer Datenquellen für die Literatursuche. 3. Entfernen von Duplikaten, Schichtung, Evidenzklassifizierung und Sortierung der Suchergebnisse. 4. Verwendung anklickbarer In-Text-Zitate in der Antwort. 5. Am Ende werden die vollständigen Literaturangaben einzeln aufgelistet und die IF mit öffentlich nachvollziehbaren Quellen angegeben; falls keine hohe Vertrauenswürdigkeit bestätigt werden kann, muss „Zu prüfen“ oder „Nicht nachgewiesen“ angegeben werden.
Empfohlen von
Nico@YouMind
Warum wir diese Fähigkeit empfehlen
Diese Fähigkeit ist ein zuverlässiger Leitfaden für die biomedizinische Forschung. Durch strukturierte Abfragen, mehrstufige Literaturfilterung und eine strenge IF-Überprüfung wird sichergestellt, dass hochgenaue und überprüfbare wissenschaftliche Informationen bereitgestellt werden.
Anweisungen
Der Kern dieses Prozesses besteht darin: Zunächst werden mithilfe mehrerer Abfragen reproduzierbare erste Screenings in PubMed/NCBI E-Utilities durchgeführt. Anschließend wird PMID zur Deduplizierung und Bewertung der Evidenz in den Abstracts verwendet. Nur eine kleine Anzahl wichtiger Dokumente wird in die PMC/BioC-Volltextprüfung aufgenommen. Zitate im Text müssen anklickbar sein. Vollständige bibliografische Angaben müssen am Ende des Artikels aufgeführt sein. Der Impact Factor (IF) kann nur konservativ anhand öffentlich zugänglicher Quellen überprüft werden und es kann nicht davon ausgegangen werden, dass JCR oder lokale Datenbanken vorhanden sind. Treffer mit geringer Konfidenz dürfen nicht als endgültige Ergebnisse betrachtet werden.
1. Vorverarbeitung nach dem Start einer Suche durch einen Benutzer
1.1 Analysieren Sie zunächst die Frage des Benutzers.
Nach Eingang der Frage eines Nutzers wird die natürlichsprachliche Frage zunächst in strukturierte Elemente zerlegt.
Muss identifiziert werden:
• Forschungsthemen: Gene, Proteine, Medikamente, Kanäle, Zelltypen, Gewebe, Krankheiten und Modelle.
• Biologische Systeme: Menschen, Mäuse, Ratten, Zebrafische, Organoide, Netzhaut, Gehirnregionen, Zelllinien usw.
• Beziehungstypen: Expression, Regulation, Funktion, Mechanismus, Phänotyp, Tod, Überleben, Behandlung, Toxizität, Entwicklung, Degeneration usw.
• Anforderungen an die Nachweise: Ob direkte Nachweise, mechanistische Nachweise, Volltextnachweise, Diagramme, Dosierungsparameter und experimentelle Methoden erforderlich sind.
• Zeitlicher Rahmen: unbegrenzte Zeit, die letzten 5 Jahre, das letzte Jahr, die neuesten Entwicklungen und klassische Literatur.
• Ausgabetypen: Kurzantwort, repräsentative Literatur, Zusammenfassung der Übersicht, Vorschläge für die Versuchsplanung, Evidenztabelle, Mechanismusdiagramm.
Beispiel:
Benutzerproblem:
"Bitte helfen Sie mir, Literatur zum Thema Absterben von retinalen Organoiden zu finden."
Strukturierte Zerlegung (Beispiel):
• Kernmodelle: Retina-Organoid, Retina-Organoid, aus hPSCs gewonnenes Retina-Organoid, Optikusbecher-Organoid.
• Phänotyp: Zelltod, Apoptose, Degeneration, Überlebensverlust, Stress, Nekrose.
• Verwandte Zellen: Photorezeptor, Zapfen, Stäbchen, retinale Ganglienzelle, Müller-Glia.
• Mögliche Mechanismen: oxidativer Stress, ER-Stress, mitochondriale Dysfunktion, Hypoxie, Entzündung, Ferroptose, Nekroptose.
• Evidenzziele: Priorisieren Sie Originalstudien, die Zelltod/Apoptose/Degeneration in humanen oder tierischen retinalen Organoiden direkt beobachten; suchen Sie anschließend nach Literatur zu indirekten Mechanismen.
1.2 Prinzipien der Keyword-Segmentierung (Beispiel)
Schreiben Sie nicht nur eine Suchanfrage. Bereiten Sie mindestens drei Kategorien von Begriffen für jedes Konzept vor.
Kategorie 1: Präzise Wörter.
• retinales Organoid
• Retina-Organoid
• menschliches retinales Organoid
• Von hPSC abgeleitetes Netzhautorganoid
• iPSC-abgeleitetes retinales Organoid
Die zweite Kategorie: Synonyme und Hyperonyme.
• Augenbecher-Organoid
• 3D-Retinakultur
• aus Stammzellen gewonnene Netzhaut
• Netzhautdifferenzierung
• Netzhautgewebemodell
Die dritte Kategorie: Mechanismus- und phänotypische Begriffe.
• Apoptose
• Zelltod
• Degeneration
• Überleben
• Stress
• oxidativer Stress
• ER-Stress
• mitochondriale Dysfunktion
• Hypoxie
• Nekroptose
• Ferroptose
Wenn der Benutzer den Zelltyp angibt, fügen Sie Folgendes hinzu:
• Fotorezeptor
• Kegel
• Stab
• retinale Ganglienzelle
• Müller-Glia
• Bipolarzelle
• Amakrinzelle
Wenn der Benutzer die Art oder den Ursprung angibt, fügen Sie Folgendes hinzu:
• menschlich
• Maus
• Ratte
• Zebrafisch
• hESC
• iPSC
• pluripotente Stammzelle
1.3 Generieren hierarchischer Suchanfragen
Generieren Sie mindestens 3–6 Suchanfragen. Jede Suchanfrage entspricht einem Suchziel.
Erste Ebene: Direkte Beweisbeschaffung.
Dient dazu, Literatur zu finden, die direkt zum Zielmodell und Zielphänotyp passt.
```Text
("Retina-Organoid" ODER "Retina-Organoid" ODER "menschliches Retina-Organoid") UND (Apoptose ODER "Zelltod" ODER Degeneration)
```
Zweite Ebene: Erweiterter Modellabruf.
Dient dazu, Literatur zu erfassen, in der der Autor zwar nicht den präzisen Begriff „retinales Organoid“ verwendet, dieser aber tatsächlich relevant ist.
```Text
("optisches Cup-Organoid" ODER "3D-Retinakultur" ODER "aus Stammzellen gewonnene Retina") UND (Überleben ODER Apoptose ODER Stress)
```
Die dritte Ebene: mechanismenspezifische Suche.
Wird verwendet, um spezifische Signalwege oder Mechanismen zu überprüfen.
```Text
("Retina-Organoid" ODER "Retina-Organoid") UND ("Oxidativer Stress" ODER "ER-Stress" ODER Hypoxie ODER Mitochondrien")
```
Vierte Ebene: Zelltypspezifische Suche.
```Text
("Retina-Organoid" ODER "Retina-Organoid") UND (Photorezeptor ODER Zapfen ODER Stäbchen ODER "Retina-Ganglienzelle") UND (Tod ODER Apoptose ODER Degeneration)
```
Fünfte Ebene: Abruf des Krankheitsmodells.
```Text
("Retina-Organoid" ODER "Retina-Organoid") UND (Krankheit ODER Degeneration ODER Dystrophie ODER Retinitis ODER Glaukom)
```
Sechste Ebene: Überprüfung/Hintergrundsuche.
```Text
("Retina-Organoid" ODER "Retina-Organoid") UND (Überprüfung ODER Protokoll ODER Modell)
```
2. Welche Methoden und Websites wurden für die Suche verwendet?
2.1 Bevorzugt: PubMed / NCBI E-Utilities
PubMed ist das bevorzugte Tool zur Suche in biomedizinischer Literatur. Verwenden Sie nicht standardmäßig das Scraping von PubMed-Seiten, sondern die NCBI E-Utilities API.
2.1.1 ESearch: Abrufen der PMID mithilfe einer Abfrage
Schnittstelle:
```Text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi
```
Parameter:
```Text
db=pubmed
Suchbegriff=
retmode=json
retmax=20
sort=relevanz
```
Sie können auch nach Zeit sortieren:
```Text
sort=pub+date
```
Beispiel:
```Text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=pubmed&term=(%22retinal%20organoid%22%20OR%20%22retina%20organoid%22)%20AND%20(apoptosis%20OR%20%22cell%20death%22)&retmode=json&retmax=20&sort=relevance
```
Lesen Sie aus der Rückgabe:
```Text
esearchresult.idlist
```
Dies ist die PMID-Liste.
2.1.2 Zusammenfassung: Beschaffung von Literaturmetadaten
Schnittstelle:
```Text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi
```
Parameter:
```Text
db=pubmed
id=PMID1,PMID2,PMID3
retmode=json
```
Extrahierte Felder:
• PMID
• Titel
• vollständiger Zeitschriftenname
• Abkürzung der Quelle/Zeitschrift
• Veröffentlichungsdatum
• Autoren
• DOI und PMCID in Artikel-IDs
• Band, Ausgabe, Seiten
2.1.3 EFetch: Abrufen von Zusammenfassungs- und XML-Details
Schnittstelle:
```Text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/efetch.fcgi
```
Parameter:
```Text
db=pubmed
id=PMID1,PMID2
retmode=xml
rettype=abstract
```
Extrahierte Felder:
• Artikeltitel
• AbstractText
• Zeitschriftentitel
• ISO-Abkürzung
• ISSN / eISSN
• Veröffentlichungsdatum
• DOI
• PMCID
• MeSH-Begriffe
2.1.4 Strategie für den Batch-Abruf
Empfohlene Vorgehensweise:
1. Rufen Sie ESearch für jede Abfrage auf.
2. Wählen Sie für jede Suchanfrage die ersten 5 bis 20 Ergebnisse aus.
3. Alle PMIDs zusammenführen.
4. Verwenden Sie PMID, um Duplikate zu entfernen.
5. Verwenden Sie ESummary / EFetch, um Metadaten und abstrakte Daten in Batches abzurufen.
6. Lesen Sie in der ersten Sichtungsphase nur die Metadaten und die Zusammenfassung; beginnen Sie nicht mit dem Lesen des Volltextes.
────────────────
2.2 Zweite Phase: Vollständige Überprüfung der PMC/BioC-Dokumente
Der vollständige Text wird nur in folgenden Fällen aufgenommen:
• Die Nutzer bitten darum, den vollständigen Text sorgfältig zu lesen.
• Der Abstract reicht nicht aus, um den Mechanismus zu bestimmen.
• Erfordert Diagramme, experimentelle Methoden, Konzentrationen, Dosierungen, IC50, EC50, Kd und Ki.
• Eine kleine Anzahl wichtiger PMIDs wurde identifiziert und muss von Fall zu Fall überprüft werden.
2.2.1 PMID zu PMCID
Schnittstelle:
```Text
https://www.ncbi.nlm.nih.gov/pmc/utils/idconv/v1.0/?ids=
```
Wird PMCID zurückgegeben, bedeutet dies, dass PMC möglicherweise über einen offenen Volltext verfügt.
2.2.2 BioC-JSON priorisieren
Schnittstelle:
```Text
https://www.ncbi.nlm.nih.gov/research/bionlp/RESTful/pmcoa.cgi/BioC_json/
```
Vorteile: Hochstrukturiert, geeignet zum Extrahieren von Haupttextabschnitten.
2.2.3 Versuchen Sie PMC XML, wenn BioC nicht verfügbar ist.
Schnittstelle:
```Text
https://www.ncbi.nlm.nih.gov/pmc/articles/
```
Beim Extrahieren des Haupttextes überspringen:
• Referenzen
• Bibliographie
• Danksagungen
• Autorenbeiträge
• konkurrierende Interessen
Die vollständige Textprüfung muss ein Abbruchkriterium enthalten:
• Jedes Dokument wird nur einmal gescannt.
• Standardmäßig werden nur Absätze extrahiert, die sich auf die Frage beziehen.
• Wenn das Zielfeld nicht übereinstimmt, markieren Sie es als „Keine direkten Beweise gefunden“.
• Vermeiden Sie das wiederholte Auslesen von Schlüsselwörtern.
────────────────
2.3 bioRxiv / medRxiv
Dient als Ergänzung zu den neuesten Preprints.
Sie können die offizielle API verwenden:
```Text
https://api.biorxiv.org/details/biorxiv/YYYY-MM-DD/YYYY-MM-DD
https://api.biorxiv.org/details/medrxiv/YYYY-MM-DD/YYYY-MM-DD
```
Sie können ergänzend auch eine normale Suche verwenden:
```Text
site:biorxiv.org retinal organoid apoptosis
Website:medrxiv.org Retina-Organoid-Degeneration
```
Vorabdrucke müssen gekennzeichnet werden:
```Text
Dies ist ein Preprint und wurde noch nicht von Fachkollegen begutachtet.
```
────────────────
2.4 Crossref/OpenAlex/Unpaywall
Wird verwendet, um DOI, Adresse für den offenen Volltext und Publikationsinformationen zu vervollständigen.
Crossref:
```Text
https://api.crossref.org/works?query.title=<title>
```
OpenAlex:
```Text
https://api.openalex.org/works?search=
```
Bezahlschranke aufheben:
```Text
https://api.unpaywall.org/v2/
```
verwenden:
• DOI-Abschluss.
• OA PDF-Linksuche.
• Überprüfung des Zeitschriftennamens.
• Überprüfung des Veröffentlichungsjahres.
────────────────
2.5 Verlagsseite
Rufen Sie die Seite des Herausgebers nur dann auf, wenn die API-Informationen nicht ausreichen.
Zugriffsregeln:
• Jede Publisher-URL wird nur einmal ausprobiert.
• Sollten Sie auf CAPTCHAs, Anmeldebarrieren, Cloudflare-Meldungen, Zugriff verweigerte Meldungen oder institutionelle Zugriffsbarrieren stoßen, brechen Sie den Vorgang sofort ab.
• Vermeiden Sie wiederholtes Aktualisieren, Ändern des Pfades innerhalb derselben Website oder Warten in einer Schleife.
• Verwenden Sie PubMed, PMC, Crossref, OpenAlex, Unpaywall und DOI-Metadaten als Fallback.
3. Wie man Informationen nach dem Abruf organisiert
3.1 Eine einheitliche Datensatzstruktur einrichten
Alle Dokumente werden zu einem einheitlichen Datensatz zusammengefasst.
Felder:
```Text
pmid
doi
pmcid
Titel
Autoren
Zeitschrift
Journalabkürzung
issn
eissn
Jahr
Abstrakt
Abfragequelle
Evidenzniveau
Beweis-Tags
Papiertyp
URL
```
3.2 Duplikatsentfernung
Priorität:
1. PMID-Deduplizierung.
2. Verwenden Sie DOI, um Duplikate zu entfernen, falls PMID nicht verfügbar ist.
3. Falls kein DOI vorhanden ist, verwenden Sie lower(title) + year + first_author, um Duplikate zu entfernen.
Behalte die query_source bei, die beim ersten Mal aufgerufen wurde, und protokolliere, welche Abfragen das Dokument getroffen haben.
3.3 Klassifizierung von Beweismitteln
Es ist notwendig zu unterscheiden:
Direkte Beweise:
Die Zielspezies, das Gewebe, der Zelltyp, das Modell und die Behandlungsbedingungen sind direkt aufeinander abgestimmt.
Indirekte Beweise:
Angrenzende Systeme, ähnliche Modelle und ähnliche Mechanismen werden unterstützt, es handelt sich dabei jedoch nicht um direkte Systeme zur Lösung von Benutzerproblemen.
Es wurden keine direkten Beweise gefunden:
Lediglich Hintergrundinformationen, Spekulationen, Rezensionen oder verwandte Modelle sind zu finden; direkte experimentelle Ergebnisse liegen nicht vor.
3.4 Dokumententypkennzeichnung
Zumindest Folgendes sollte beachtet werden:
• Originalforschung
• Rezension
• Protokoll
• Vorabdruck
• Datensatz/Ressource
• klinische Studie
• Methodenpapier
3.5 Sortierregeln
Empfohlene Sortierung:
1. Originalforschung mit direkten Beweisen.
2. Forschung zu Schlüsselmechanismen.
3. Neueste wichtige Forschungsergebnisse.
4. Klassische Grundlagenstudien.
5. Hochwertige Rezension.
6. Indirekte Beweise.
Sortieren Sie nicht allein nach dem Impact-Faktor (IF). Der IF ist ein Indikator auf Zeitschriftenebene und sagt nichts über die Qualität eines einzelnen Artikels aus.
4. Wie man Zitate in einer Antwort strukturiert
4.1 Format für Textzitate
Alle Textzitate müssen anklickbar sein.
Format:
```Markdown
[[1. **Zeitschrift**, Jahr]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
```
Beispiel:
```Markdown
Frühere Studien haben in humanen retinalen Organoiden entwicklungsstadienbedingten Photorezeptorstress und Degeneration beobachtet [[1. **Cell Stem Cell**, 2019]](https://pubmed.ncbi.nlm.nih.gov/xxxxxxx/).
```
Schreiben Sie es nicht so:
```Text
[1]
(PMID: xxxxx)
Siehe Referenz 1
```
4.2 Empfohlene Antwortstruktur
Erster Absatz: Direkte Schlussfolgerung.
```Text
Fazit: Es liegen zwar einschlägige Berichte vor, die direkten Beweise konzentrieren sich jedoch hauptsächlich auf...; direkte Beweise bezüglich... fehlen noch.
```
Zweiter Absatz: Klassifizierung der Beweismittel.
```Text
Direkte Beweise:
- Referenz A: ...
Indirekte Beweise:
- Referenz B: ...
Es wurden keine direkten Beweise gefunden:
- In dieser Runde nicht gefunden...
```
Dritter Absatz: Zusammenfassung des Mechanismus.
Nach Themen gruppieren, zum Beispiel:
• Apoptose-/Caspase-Signalweg
• oxidativer Stress
• mitochondriale Dysfunktion
• ER-Stress
• Hypoxie/metabolischer Stress
• Entzündung
• Entwicklungsdiskrepanz
Vierter Absatz: Forschungslücke.
Geben Sie klar an, bei welchen Punkten es an direkten Beweisen mangelt.
Fünfter Absatz: Inspiration aus dem Experiment.
Falls der Benutzer ein Versuchsdesign benötigt, geben Sie bitte den Marker, den Test, den Zeitpunkt und die Kontrollgruppe an.
5. Vollständiges Literaturverzeichnis am Ende des Artikels
Wird im Text eine bestimmte Quelle zitiert, muss am Ende des Artikels eine vollständige Liste beigefügt werden.
Format:
```Markdown
## Vollständige Liste der Referenzinformationen
1. Smith J et al., **Journal Name** (2021), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Qn}*
2. Wang X et al., **Zeitschriftenname** (2022), [DOI: 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=Wird noch geprüft}*
```
Autorenformat:
• 1–3 Autoren: Alle auflisten.
• Mehr als 3 Autoren: Erstautor et al.
Die PMID / DOI / URL muss anklickbar sein.
6. IF-Verifizierung und -Kennzeichnung
6.1 Zunächst wollen wir die praktischen Grenzen von IF-Abfragen erläutern.
Normalerweise stammt der offizielle Journal Impact Factor aus den Clarivate Journal Citation Reports (JCR). Da externe Dienstleister in der Regel jedoch weder über ein Clarivate/JCR-Konto noch über eine lokale JCR-Tabelle verfügen, sollten Sie ihn nicht auf diesem Weg überprüfen.
```
6.2 Praktische Methoden zur Anwendung der IF-Fertigkeit
Hauptroute:
1. Falls es sich bei der Eingabe um eine PMID handelt, verwenden Sie zunächst die NCBI E-Utilities, um PubMed-Metadaten zu erhalten.
- Vollständigen Zeitschriftennamen abrufen. - Quell-/ISO-Abkürzung abrufen. - ISSN/eISSN abrufen. - Zusatzfelder wie Titel, Jahr und DOI abrufen.
2. Verwenden Sie die öffentlich verfügbare mobile JSON-Schnittstelle iikx/iscience, um Zeitschriften abzufragen.
Such-API:
```Text
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=
```
Details zur API:
```Text
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=
```
3. Führen Sie eine konservative Suche in den Suchergebnissen durch.
- Priorisiert exakte Übereinstimmungen mit normalisierten Zeitschriftentiteln. - Priorisiert außerdem exakte Übereinstimmungen mit Abkürzungen. - Geht bei kurzen und allgemeinen Begriffen besonders vorsichtig vor. - Akzeptiert keine offensichtlichen Teilstring-Abweichungen, wie z. B. die Verwechslung von „Nature“ mit der Reihe „Nature Reviews“. - Gibt bei instabilen Übereinstimmungen mehrdeutige oder nicht gefundene Ergebnisse zurück, anstatt zu raten.
4. Falls PubMed eine Abkürzung angibt, versuchen Sie, diese mithilfe des NLM-Katalogs in den vollständigen Namen oder einen alternativen Titel umzuwandeln.
Die Suchoberfläche des NLM-Katalogs bleibt NCBI E-Utilities:
```Text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=[Titelabkürzung]&retmode=xml&retmax=1
```
Verwenden Sie anschließend ESummary, um den Titel / alternativen Titel zu erhalten.
5. Lesen Sie die detaillierten Ergebnisse von iikx:
- Impact-Faktor. - IF-Jahr. - JCR-Quartil. - CAS/CAS-Quartil (falls zutreffend). - Quell-URL. - Konfidenzintervall der Übereinstimmung.
6. Geben Sie das IF-Jahr nicht im Haupttext an; verwenden Sie stattdessen kompakte Anmerkungen.
Die abschließende Anmerkung sollte lediglich Folgendes lauten:
```Text
*{IF=X,Qn}*
```
Falls es fehlschlägt:
```Text
*{IF=Überprüfung ausstehend}*
```
oder:
```Text
*{IF=Nicht erkannt}*
```
6.3 Spezifische Schritte
Führen Sie für jedes Dokument die folgende Vorgehensweise durch.
Schritt 1: Den Namen der Zeitschrift für die Suche vorbereiten.
Priorisieren Sie den Abruf von Metadaten aus PubMed:
```Text
Vollständiger Zeitschriftenname
ISO-Abkürzung / Quelle
ISSN
eISSN
```
Falls nur eine DOI verfügbar ist, verwenden Sie zunächst Crossref oder OpenAlex, um den Namen der Zeitschrift zu ermitteln.
Crossref:
```Text
https://api.crossref.org/works/
```
OpenAlex:
```Text
https://api.openalex.org/works/https://doi.org/
```
Schritt 2: Standardisierung der Zeitschriftennamen.
Standardisierungsregeln:
• Alles kleingeschrieben.
• HTML-Entschlüsselung.
• Ersetzen Sie & durch und.
• Entfernen Sie die Interpunktion.
• Mehrere Leerzeichen kombinieren.
• Beim Vergleichen kann man auch die Kurzform verwenden, bei der alle Leerzeichen entfernt werden.
Beispiel-Pseudocode:
Python
import re, html
def norm(s):
s = html.unescape(s or '').lower()
s = re.sub(r'&', ' and ', s)
s = re.sub(r'[^a-z0-9]+', ' ', s)
return re.sub(r'\s+', ' ', s).strip()
def compact(s):
return norm(s).replace(' ', '')
```
Schritt 3: Abfrage der iikx-Suchschnittstelle.
```Text
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=
```
Es wird empfohlen, einen User-Agent festzulegen, zum Beispiel:
```Text
Mozilla/5.0
```
Wenn auf der ersten Seite keine exakte Übereinstimmung gefunden wird, können Sie eine begrenzte Anzahl von Seiten durchblättern, zum Beispiel bis zu 8 Seiten.
Die Parameter für das Umblättern sind üblicherweise:
```Text
Seite=2
Seite=3
```
Schritt 4: Wählen Sie Kandidaten aus den Suchergebnissen aus.
Kandidatenfelder umfassen typischerweise:
```Text
Ausweis
Klassen-ID
Titel
Kleiner Titel
IF oder IF2024
zky2020
URL
```
Matching-Regeln:
• Wenn compact(query) == compact(candidate.title), akzeptiere.
• Wenn norm(query) == norm(candidate.title), akzeptiere.
• Wenn compact(query) == compact(candidate.smalltitle), akzeptiere.
• Wenn norm(query) == norm(candidate.smalltitle), akzeptiere.
• Eine Teilzeichenkette wird nur akzeptiert, wenn die Abfrage lang genug und eindeutig ist.
• Seien Sie besonders vorsichtig mit kurzen Wörtern wie Natur, Wissenschaft, Zelle, Gehirn, Sehen und Netzhaut.
Schritt 5: Falls keine Übereinstimmung gefunden wird, verwenden Sie die erweiterte Abkürzung aus dem NLM-Katalog.
In PubMed ist die Quelle beispielsweise:
```Text
Freie Radikale Biol Med
```
Sie können Folgendes überprüfen:
```Text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=Free%20Radic%20Biol%20Med%5BTitle%20Abbreviation%5D&retmode=xml&retmax=1
```
Nachdem Sie die NLM-Katalog-ID erhalten haben, verwenden Sie sie wie folgt:
```Text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi?db=nlmcatalog&id=
```
Lesen:
```Text
Titel
Alternativer Titel
```
Verwenden Sie dann diese vollständigen Namen, um nach iikx zu suchen.
Schritt 6: Überprüfen Sie die Details der IIKX-Oberfläche.
Wenn die Suchergebnisse Folgendes enthalten:
```Text
id=
classid=
```
Anruf:
```Text
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=
```
Aus dem Detail lesen:
```Text
IF2024, IF2023, IF2022 ...
WENN
zky2020 oder andere JCR-Quartilsfelder
jcr22 / jcr12 oder Partitionsfeld
issn
eissn
Titel
Kleiner Titel
Kategorie
```
Schritt 7: Wählen Sie die neueste IF-Anweisung aus.
Durchsuchen Sie die zurückgegebenen Felder nach allen Vorkommen des folgenden Formulars:
```Text
IF20xx
```
Zum Beispiel:
```Text
IF2024
IF2023
IF2022
```
Wählen Sie das Jahr mit der größten signifikanten Ziffer.
Falls IF20xx nicht vorhanden ist, versuchen Sie Folgendes zu lesen:
```Text
WENN
if_value
```
Wird kein gültiger Wert gefunden, wird er als nicht erkannt markiert.
Schritt 8: Konfidenzniveau und Bezeichnung ausgeben.
Wenn der genaue Titel/die Abkürzung übereinstimmt und die Detailabfrage ein gültiges Ergebnis liefert:
```Text
*{IF=X,Qn}*
```
Wenn der Ausgang des Spiels ungewiss ist:
```Text
*{IF=Überprüfung ausstehend}*
```
Wenn die öffentliche API keine Ergebnisse liefert:
```Text
*{IF=Nicht erkannt}*
```
6.4 IF-Anmerkungsformat
Festes Format:
```Text
*{IF=X,Qn}*
```
Beispiel:
```Markdown
Smith J et al., **Neuron** (2020), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=15.0, Q1}*
```
Beachten:
• Das JCR-Jahr wird nicht innerhalb der IF-Anmerkung angegeben.
• Schreiben Sie nicht "2024 JCR IF".
• Schreiben Sie nicht "JCR 2024".
• Lediglich das Erscheinungsjahr wird beibehalten.
• Wenn die IF-Funktion 0,0 oder null ist, eine instabile Quelle oder eine instabile Übereinstimmung aufweist, wird die Zahl nicht angezeigt.
6.5 Standardbehandlung für IF-Prüffehler
Nicht raten.
Verwenden Sie nicht den Namen der Zeitschrift, um die Nummern einzutragen.
Verwenden Sie keine großen Modelle, um IF-Anweisungen auswendig zu lernen und auszufüllen.
Im Fehlerfall sind nur drei Zustände zulässig:
```Text
*{IF=Überprüfung ausstehend}*
```
Verwendungszweck:
• Die Suchergebnisse sind ungenau.
Es gibt mehrere ähnliche Zeitschriften.
• Es wurde lediglich die Abkürzung gefunden, der vollständige Name konnte nicht bestätigt werden.
• Die von öffentlich zugänglichen Quellen zurückgegebenen IF-Werte sind fragwürdig.
```Text
*{IF=Nicht erkannt}*
```
Verwendungszweck:
• Die öffentliche Schnittstelle lieferte keine Ergebnisse.
• Die Zeitschrift ist nicht im SCI/JCR gelistet.
• Die neue Ausgabe enthält noch kein IF.
```Text
*{IF=Nicht öffentlich überprüfbar}*
```
Verwendungszweck:
• Der Benutzer benötigt einen offiziellen JCR, aber der aktuelle Agent verfügt nicht über Clarivate/JCR-Berechtigungen.
7. Abschließende Selbstcheckliste
Muss vor dem Versand geprüft werden:
• Sollten die Kernfragen des Nutzers zuerst beantwortet werden?
• Ob zwischen direkten Beweisen, indirekten Beweisen und dem Fehlen direkter Beweise unterschieden werden soll.
• Sind alle Textzitate anklickbar?
• Gibt es am Ende des Artikels eine vollständige Liste der verwendeten Quellen?
• Enthält jedes Dokument eine IF-Kennzeichnung (Eingabe/Ausgabe) oder eine Kennzeichnung, die auf eine ausstehende Überprüfung/Nichterkennung hinweist?
• Ob die PMID/DOI/URL anklickbar ist.
• Wird dabei vermieden, Gesamtergebnisse über das Gewebe durch Schlussfolgerungen über spezifische Zelltypen zu ersetzen?
• Wird dadurch vermieden, dass die Aktivierung/Phosphorylierung durch eine Erhöhung der Gesamtexpression ersetzt wird?
• Ob ein Preprint angegeben werden soll.
• Werden die Suchgrenzen festgelegt?
• WENN es nicht auf Erinnerung oder Vermutungen beruhte.
8. Reproduzierbarer Pseudocode
Python
queries = build_queries(user_question)
all_pmids = []
für Abfrage in Abfragen:
pmids = ncbi_esearch(query, retmax=20, sort='relevance')
all_pmids.extend(pmids)
pmids = deduplicate_keep_order(all_pmids)
metadata = ncbi_esummary(pmids)
abstracts = ncbi_efetch_abstract(pmids)
records = merge_metadata_and_abstracts(metadata, abstracts)
records = tag_evidence(records, user_question)
Datensätze = rank_records(Datensätze)
ausgewählt = select_top_records(records)
falls Volltext benötigt wird:
für Datensatz in selected_key_records:
pmcid = idconv_pmid_to_pmcid(record.pmid)
if pmcid:
record.fulltext = fetch_bioc_or_pmc_xml(pmcid)
Für Datensätze in der Auswahl:
journal_query = record.full_journal_name or record.journal_abbrev
if_result = lookup_if_public_iikx(journal_query)
if_result.confident:
record.if_annotation = f'*{IF={if_result.if_value},{if_result.quartile}}*'
elif if_result.ambiguous:
record.if_annotation = '*{IF=Pending Verification}*'
anders:
record.if_annotation = '*{IF=Nicht erkannt}*'
Antwort = zusammengesetzte_Antwort(
Abschluss
Evidenzgruppen,
klickbare_Zitate im Fließtext,
vollständige Referenzliste mit Wenn
)
```
9. Empfohlene Vorlage für die endgültige Lieferung
```Markdown
abschließend:
...
Evidenzgrad:
Direkte Beweise:
- ……[[1. **Zeitschrift**, Jahr]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
Indirekte Beweise:
- …[[2. **Zeitschrift**, Jahr]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
Es wurden keine direkten Beweise gefunden:
- ……
Mechanismusübersicht:
1. ……
2. ……
Suchgrenzen:
Diese Suchrunde umfasste hauptsächlich PubMed, PMC, BioC und bioRxiv. Die erste Sichtung erfolgte anhand von Metadaten und Abstracts, wobei nur die wichtigsten Dokumente einer Volltextprüfung unterzogen wurden. Die IF-Annotationen basierten auf öffentlich zugänglichen Quellen; Dokumente, die nicht mit hoher Sicherheit zugeordnet werden konnten, wurden als „Verifizierung ausstehend“ oder „Nicht gefunden“ gekennzeichnet.
Vollständige Liste der Literaturinformationen:
1. Smith J et al., **Journal Name** (2021), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Q1}*
2. Wang X et al., **Zeitschriftenname** (2022), [DOI: 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=Wird noch geprüft}*
```
Ähnliche Fähigkeiten
Alle anzeigen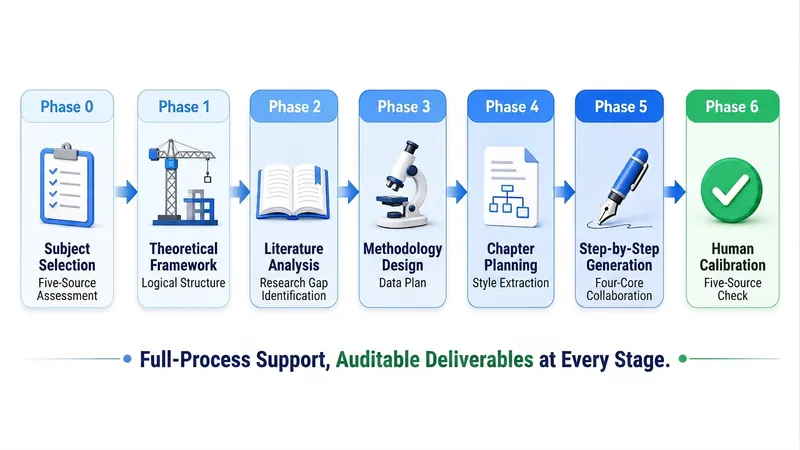
Exposé-Check: 5 Quellen
Bevor du Dutzende Stunden in deine Abschlussarbeit investierst, nimm dir zehn Minuten für einen strukturierten Check. 【Dieser Skill tut genau eine Sache】 Diagnose, kein Ghostwriting. Er zeigt dir, ob dein Thema trägt, ob deine Materialien reichen, was fehlt, wo du ergänzen kannst und in welcher Reihenfolge – und liefert dir eine umsetzbare Ergänzungsliste mit Suchstrategien. Er schreibt dir keine Einleitung, keinen Literaturüberblick, keine Methodik und keine Diskussion. 【Vier Prüfschritte】 1. Facheinordnung: Das Thema wird einer von vier Kategorien zugeordnet – 1A Geisteswissenschaften/Künste, 1B Sozialwissenschaften, 2A Ingenieur-/Naturwissenschaften, 2B Agrar-/Medizin-/Lebenswissenschaften – und die passenden fachspezifischen Vorgaben werden geladen. Bei 2B ist die Ethikprüfung verpflichtend. 2. Themencheck: Das Thema wird aus den drei Dimensionen „Trend, Form, Begriffe“ (势·形·词) geprüft, um zu sehen, ob die Untersuchungseinheit operationalisierbar ist, ob die Forschungsfrage beantwortet werden kann und ob das Thema schon ausgereizt ist. 3. Materialcheck: Deine vorhandene Literatur wird als Materialbibliothek M1/M2… erfasst. Jeder Eintrag wird auf vier Elemente geprüft (Autor:in, Jahr, Titel, verifizierbarer Identifikator), und die tatsächliche Abdeckung wird berechnet. 4. Lückenliste und Suchstrategien: Du erfährst, wie viele und welche Literaturquellen fehlen und welche Beweislücke offen ist. Dazu bekommst du direkt in Datenbanken einfügbare Suchanfragen (mit Booleschen Kombinationen, Zeitraum und Filterkriterien). 【Wann du diesen Skill nutzt】(Triggerbegriffe) „Check mal mein Exposé“, „Kann ich dieses Thema machen?“, „Reicht meine Literatur?“, „Mein Exposé wurde abgelehnt“, „Ich will vor dem Schreiben sichergehen“ – für Studierende, die gerade ihr Thema festgelegt haben und noch nicht mit dem Schreiben begonnen haben; für alle, deren Exposé abgelehnt wurde und die nicht wissen, woran es liegt; für alle, die viele Quellen gesammelt haben, aber unsicher sind, ob das für den Start reicht; und für alle, die vor dem eigentlichen Arbeiten wissen wollen, ob sich das Thema lohnt. 【Lieferumfang】 Ein Dokument „Exposé-Check-Bericht“ + eine Bewertungskarte zur Fünf-Quellen-Bereitschaft (mit verhaltensbasierten Kriterien pro Stufe, keine schwammige Benotung) + eine priorisierte Ergänzungsliste + Suchstrategien + ein Archivierungscode. Der Archivierungscode ist kompatibel mit „学术论文全流程撰写系统 v4.0“ – du kannst ihn direkt nach dem Check dort einfügen und nahtlos weiterschreiben, ohne Fachgebiet, Thema oder Zeitschrift erneut anzugeben. 【Was dieser Skill bewusst nicht tut】 Er schreibt keinen Fließtext, erstellt keine Referenzliste und erfindet keine Autor:innen, Jahreszahlen, Bände, Hefte, Seiten oder DOIs. Alle online gefundene Literatur wird mit ⚠️ „zu prüfen“ markiert und darf erst nach deiner eigenen Verifikation verwendet werden. Dieser Skill verspricht keine Annahme oder bestandene Prüfung.
 Forschung
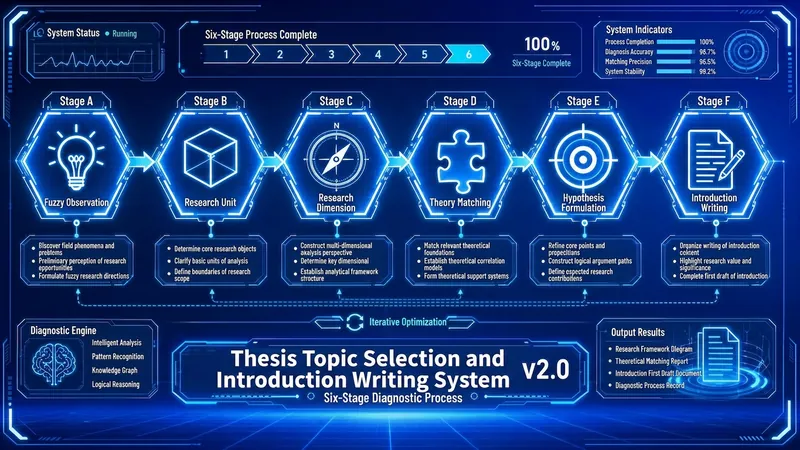
Themenwahl & Einleitung v3.2
10 Sekunden verstehen: Aus einer vagen Beobachtung eine tragfähige Themenwahl entwickeln und daraus eine einleitungsfähige Einleitung ableiten. Verwenden Sie ausschließlich von Ihnen bereitgestellte echte Materialien, keine erfundenen Literaturangaben. Auslöser: Themenwahl, Themenwahl, Einleitung, Forschungslücke, akademisches Schreiben, Abschlussarbeit, Themenwahl vor der Literaturübersicht. Geeignet für: Zeitschriftenartikel / Dissertationen / Konferenzbeiträge / Hausarbeiten, alle Disziplinen der Geistes- und Sozialwissenschaften sowie Natur- und Ingenieurwissenschaften, Agrar- und Medizinwissenschaften. In 3 Minuten startklar: Disziplin und Ausgangspunkt festlegen → Themenwahl schrittweise formen → harte Beweiskettengate → modulare Einleitung → Ratschen-Finalisierung. 【Arbeitsteilung mit anderen Skills】Check-up zuerst, Schreiben danach, Feinschliff zuletzt. Dieser Skill übernimmt den mittleren Teil: Themenwahl und Einleitungsentwurf. Er erstellt keinen vollständigen Fließtext (das macht das 《学术论文全流程撰写系统 v4.x》), und keine sprachliche Feinschliff (das macht das 《学术论文三轨润色系统 v8.x》). 【Sechs Tore】1. Disziplinen-Zuordnung: 1A Geistes- und Kunstwissenschaften / 1B Sozialwissenschaften / 2A Natur- und Ingenieurwissenschaften / 2B Agrar-, Medizin- und Lebenswissenschaften, jeweils mit entsprechenden Regelgrenzen; bei 2B wird der Ethikprüfungsstatus verpflichtend erfragt. 2. Phasenbestimmung: Befinden Sie sich in vager Beobachtung, mit Einheit aber ohne Winkel, mit Objekt aber ohne Theorie, ohne Methode, ohne Standpunkt oder nur ohne Einleitung – starten Sie am entsprechenden Tor, nicht von vorn. 3. Themenwahl: Forschungseinheit → Dimensionskompass → theoretische Perspektive → Forschungsmethode → Forschungsansicht, schichtweise verriegeln, vor jeder Verriegelung prüfen, ob die vorherige Schicht steht. 4. Harte Beweiskettengate: Vor der Einleitung müssen Sie Ihre Literatur als M1/M2…-Materialbibliothek registrieren, jedes Element wird auf Autor/Jahr/Titel/Lokator geprüft; sind weniger als 3 Dialogstellen vorhanden, lehnt das System die Generierung der Forschungslücken-Aussage ab – nicht herabstufen, sondern ablehnen. 5. Modulare Generierung: Die Einleitung wird in fünf Modulen im umgekehrten Pyramidenstil erzeugt, jedes Modul muss die Referenznummer [Mn] angeben, ohne Quelle kein Satz. 6. Ratschen-Finalisierung: Nur auf bestandenen Versionen wird aufgewertet, erreichte Module werden gesperrt und nicht mehr geändert, die Bewertung steigt nur. 【Liefergegenstände】Dokument „[Themenwahl-Keyword]·Themenwahl & Einleitung“ + nachvollziehbare Referenzzuordnungstabelle für jeden Satz + ⚠️-Liste zur Prüfung + ein AFP-Archivierungscode. Der Archivierungscode ist mit dem 开题体检器, dem v4.x-Gesamtprozess und dem 三轨润色系统 universell einsetzbar, sodass Sie beim Skillwechsel nicht erneut Disziplin, Themenwahl, Zeitschrift und Materialbibliothek angeben müssen. 【Ausdrücklich nicht enthalten】Keine erfundenen Autoren, Jahre, Bände, Seitenzahlen oder DOIs; alle online recherchierten Einträge werden mit ⚠️ als zu prüfen markiert, Sie müssen sie verifizieren, bevor sie in das Literaturverzeichnis aufgenommen werden; keine Zusage für Annahme oder Bestehen. Autorschaft und Verantwortung liegen bei Ihnen – bitte überprüfen Sie jede Referenz und jeden Datenpunkt.
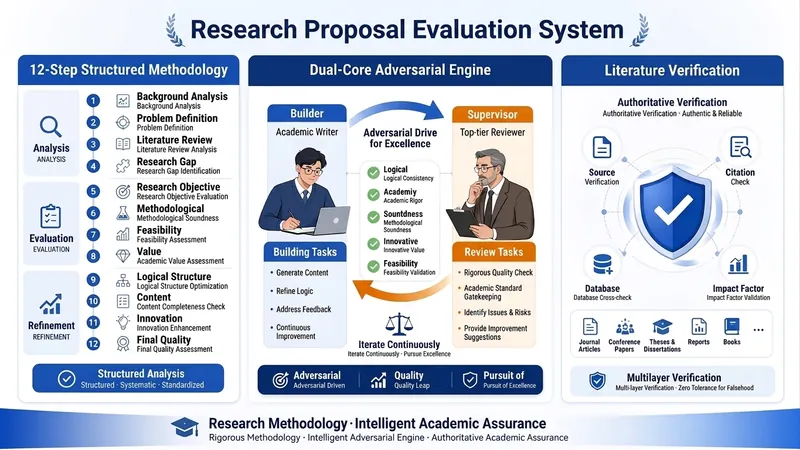
Antragsoptimierung PRO V2.0
🎯 Überblick über die Kernfunktionen Dies ist ein intelligentes Bewertungs- und Optimierungssystem, das speziell für die Beantragung von nationalen Sozialwissenschafts-, Bildungsministeriums- und Provinzprojekten entwickelt wurde. Es simuliert die Denkweise eines erfahrenen Gutachters mit 15 Jahren Erfahrung und gewährleistet durch drei Kernmechanismen die akademische Strenge und Wettbewerbsfähigkeit des Antrags. 🔧 Drei Kernmechanismen 1️⃣ 12-stufige strukturierte Methodik Die gesamte Bewertung eines Projektantrags wird in 12 Schritten abgedeckt: Phase 1-3: Basisdiagnose - Detaillierte Analyse der Ausschreibung (Förderschwerpunkte, Bewertungskriterien, Anforderungen) - Identifizierung des interdisziplinären Typs (8 Typen präzise erkennbar) - Forschungslücke in 5 Dimensionen identifizieren (Theorie/Methode/Empirie/Policy/Technik) Phase 4-7: Bewertung der Kernelemente - Analyse der Forschungsfrage nach dem TMAQ-Modell (Theorie, Methode, Ansatz, Frage) - Überprüfung der Forschungsziele nach SMART-Prinzipien - Bewertung der Vollständigkeit des Forschungskonzepts - Zuordnung des Forschungstyps (6 Typen) Phase 8-10: Tiefe Qualitätssteigerung - Präzise Identifizierung der Schwerpunkte und Herausforderungen (mit Abgrenzungskriterien und Lösungswegen) - 7-dimensionale Erkundung von Innovationspunkten - 7-dimensionale Durchführbarkeitsbegründung Phase 11-12: Gesamtoptimierung - 9-dimensionale Qualitätskontrolle (akademische Strenge, Innovation, Durchführbarkeit usw.) - Umfassende Optimierungsvorschläge und Abschlussbericht 2️⃣ Dual-Core-Konfrontationsmechanismus (Builder vs. Supervisor) Funktionsweise: - Builder (akademischer Schreiber): Generiert Optimierungsvorschläge auf Basis der Benutzermaterialien - Supervisor (Top-Journal-Gutachter): Stellt die Vorschläge des Builders mit strengsten Maßstäben in Frage - Konfrontationsiteration: Drei Runden der Konfrontation stellen sicher, dass die Vorschläge einer Prüfung standhalten Anwendungsszenarien: - Bei der Identifizierung von Innovationspunkten: Builder schlägt Innovation vor → Supervisor hinterfragt die Neuheit → iterative Optimierung - Bei der Durchführbarkeitsargumentation: Builder entwirft Plan → Supervisor hinterfragt die Durchführbarkeit → ergänzende Argumentation - Bei der Zitation von Literatur: Builder zitiert → Supervisor überprüft die Echtheit → stellt akademische Standards sicher 3️⃣ Literatur-Echtheits-Verifikationsmechanismus Zwei Arbeitsmodi: Modus A: Platzhalter-Modus (Standard) - Verwendung von [Literatur-Platzhalter-001] u.ä. anstelle konkreter Literatur - Ausgabe einer „Literaturanforderungsliste", die die Suchkriterien für jeden Platzhalter festlegt - Der Benutzer sucht selbst und fügt echte Literatur ein Modus B: Echtzeit-Verifikationsmodus - Aufruf von Google Scholar zur Echtzeit-Überprüfung der Literatur - Erstellung eines „Literaturverifikationsberichts" (Bewertung von Echtheit/Relevanz/Autorität) - Sicherstellung, dass jede Zitation nachvollziehbar ist Vermeidung von KI-Halluzinationen: - Keine erfundenen Autoren, Zeitschriften, DOIs - Alle Literatur muss verifiziert oder als Platzhalter markiert sein - Wahrung der akademischen Integrität 💡 Kernwerte und Anwendungsszenarien ✅ Gelöste Kernprobleme 1. Mangelnde akademische Strenge: KI-generierte Inhalte enthalten oft erfundene Literatur, logische Lücken 2. Unzureichende Innovation: Schwierigkeiten, echte akademische Innovationspunkte zu identifizieren 3. Schwache Durchführbarkeit: Forschungspläne entbehren systematischer Argumentation 4. Interdisziplinäre Herausforderungen: interdisziplinäre Themen sind oft „zwischen den Stühlen" 🎓 Zielgruppe - Hochschuldozenten (Sozialwissenschaften, Bildung, Geisteswissenschaften) - Wissenschaftler (Beantragung nationaler, provinzieller Projekte) - Akademische Teams (die systematisierte Bewertungsprozesse benötigen) 📋 Typischer Arbeitsablauf 1. Eingabe: Hochladen der Ausschreibung + Antragsentwurf 2. Bewertung: System führt 12-stufige strukturierte Analyse durch 3. Konfrontation: Dual-Core-Mechanismus optimiert Schlüsselbereiche iterativ 4. Verifikation: Überprüfung der Literatur auf Echtheit 5. Ausgabe: Vollständiger Bewertungsbericht + Optimierungsvorschläge + Literatursammlung 🔍 Vergleich mit herkömmlicher Begutachtung | Dimension | Herkömmliche manuelle Begutachtung | Dieses Gutachtersystem | |-----------|------------------------------------|-------------------------| | Bewertungstiefe | abhängig von persönlicher Erfahrung | 12-stufig strukturiert + 9D-Qualitätskontrolle | | Akademische Strenge | schwer umfassend zu prüfen | Literaturverifikation + Dual-Core-Konfrontation | | Innovationsidentifikation | subjektive Beurteilung | 7-dimensionale systematische Analyse | | Durchführbarkeitsargumentation | erfahrungsgetrieben | 7-dimensionale schrittweise Argumentation | | Konsistenz | variiert von Person zu Person | standardisierter Prozess | | Effizienz | Tage bis Wochen | 1-2 Stunden für erste Bewertung | Der Kernvorteil dieses Systems liegt darin, dass es das implizite Wissen eines erfahrenen Gutachters mit 15 Jahren Erfahrung explizit, strukturiert und reproduzierbar macht, sodass jeder Benutzer eine Bewertung auf Expertenniveau erhält.
Informationen
- Version
- v5
- Zuletzt aktualisiert
- Credits pro Ausführung
- Nach Verbrauch
- Modelle
- Claude Sonnet 4.5
- Funktionen
- Webrecherche