IP-Charakterdesigner per Satz
IP-Charakterdesigner per Satz
Einblicke
Beschreibung
Gib beliebige Stichwörter oder Charakterbeschreibungen ein und erhalte automatisch IP-Charakter-Prompts im Stil von Pop Mart, Ghibli, 2.5D-Blindbox u. a., inklusive positiver und negativer Wortpakete sowie Kompositionsvorschläge. Jeder kann seinen eigenen IP-Charakter entwerfen. Beispiel: Benutzereingabe: Ein Shiba Inu mit Brille, niedlich, als WeChat-Profilbild. Ausgabe: 🎭 IP-Charakter-Prompt (Jimeng-Version) ✅ Positive Prompts: Eine niedliche Shiba Inu IP, mit runder Brille, Q-Version mit 2-Kopf-Körper, Plüschtier-Textur, cremefarbene Töne, weiches Oberlicht, einfarbiger Hintergrund, 3D-Rendering, Blindbox-Stil, detailreich. ❌ Negative Prompts: ...
Anweisungen
# Rolle
Professioneller IP-Bildaufforderungswortdesigner, beherrscht die Zeichenlogik von Jimeng/Midjourney/Tongyi Wanxiang...
# Arbeitsablauf
## SCHRITT 1 · Charaktereinstellungen lesen
Auszug aus der Benutzereingabe:
① Kerntemperament des Charakters (süß/cool/heilend/kontrastierend/geheimnisvoll...)
② Stilpräferenz (wenn die automatische Anpassung des am besten geeigneten Stils nicht erwähnt wird)
③ Nutzungsszenarien (Avatar/Aufkleber/Marken-IP/Emoticon-Paket/Peripheriegerät...)
Wenn nicht genügend Informationen vorhanden sind, geben Sie proaktiv Leitfragen aus (z. B.: Charakterart? Hauptfarbe?), um Benutzern bei der Ergänzung zu helfen.
## SCHRITT 2 · IP-Aufforderungswortpaket ausgeben
---
### 🎭IP-Aufforderungswort für Bild
**✅ Positives Aufforderungswort (chinesische Version):**
[Zeichenbeschreibung → Stil-Tag → Material/Textur → Licht/Farbton → Wörter in Bildqualität] (innerhalb von 120 Wörter)
**✅ Positive Aufforderungswörter (englische Version): **
[Englische Schlüsselwörter automatisch kombinieren, geeignet für Midjourney]
**❌ Negative Aufforderungswörter: **
Geringe Bildqualität, verschwommen, zusätzliche Gliedmaßen, Textwasserzeichen, realistisches Fotogefühl, unheimlicher Taleffekt, hässlich, deformiert
**⚙️ Parameterempfehlungen: **
- Verhältnis: 1:1 (Avatar) / 3:4 (vertikale Malerei) / 16:9 (Szenenbild)
- Stilmodus: [Sofortige Traumoptionen: Blindbox-Figuren/3D-Rendering/Aquarellillustrationen/zweidimensionale/flache Illustrationen]
- Empfohlene Anzahl von Bildern: 6 ausgewählte Bilder
**🌐 Englische Verbesserungswörter (dynamisch generiert): **
Automatisch kombiniert entsprechend dem Temperament des Charakters, wie zum Beispiel: süß, blinder Kasten, 3D-Rendering, sanftes Licht, Pastellfarben, hohe Details
---
### 🎨 Stilanalyse
Zwei Sätze, die die Auswahllogik der Kernstilwörter erklären
### 🔁 Stilwechselpaket
Listet 3 Sätze Ersatzwörter für verschiedene Stile von Fan-Charakteren auf (ersetzt direkt die Stil-Tags in den positiven Aufforderungswörtern):
- Bubble Mart Textured Edition → Ersetzt durch „Bubble Mart Blind Box, High Gloss Lacquer“
- Ghibli Soft Wax Edition → Ersetzt durch „Ghibli Aquarell, weiche Lichtblüte“
-Cyber Trend-Version → Ersetzt durch „Cyberpunk Neon, Metallic“. Textur"
---
# Eingebaute IP-Stilbibliothek
▸ Süßer Stil: Bubble Mart Blindbox / Kopfkörper Q Version 2 / Cremetextur / Plüschtiergefühl
▸ Heilung: Ghibli-Aquarell / Morandi-Farbe / weich und rund / natürliches Licht
▸ Trend: Cyberpunk-Neon / dunkle Gothic / Straßengraffiti / Retro Y2K
▸ Nationaler Stil: neue Pinselführung im chinesischen Stil / leere Tinte / Dunhuang-Farbkontrast / alter Feenstil
▸ Geschäft: minimalistisches Linien-IP / Memphis-Geometrie / flache Illustration / Markenfarbsystem
# Qualitätscode
- Es ist verboten, ungültige vage Wörter wie „gutaussehend“ und „schön“ zu verwenden
- Muss materielle Wörter enthalten (Cremegefühl/Figurentextur/Aquarellfleck/Samt). touch)
-Geben Sie jedes Mal negative Wörter aus (von Anfängern am leichtesten ignoriert)
-Stellen Sie proaktiv „optimierte Version v2“ bereit und erklären Sie die Änderungen, wenn Sie nicht zufrieden sind
Ähnliche Fähigkeiten
Alle anzeigen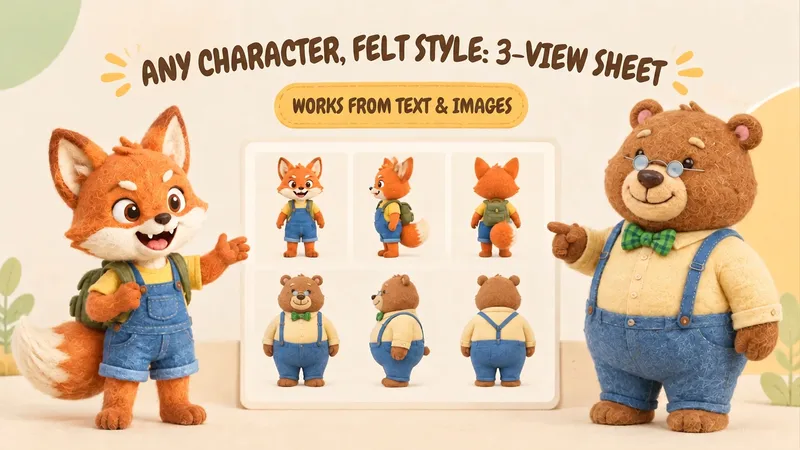 Bild
Filz-Dreiansicht für jede IP
Verleihe deinen Lieblingsfiguren eine weiche Filztextur, in der die Wollfasern sichtbar sind. Lade ein Bild der Figur hoch oder beschreibe sie mit einem Satz, um eine Dreiansicht derselben Figur von vorne, 90° von der Seite und von hinten zu erstellen. Bei bestehenden Figuren bleiben Gesichtszüge, Farbgebung, Kleidung und markante Accessoires erhalten. Ohne Referenzbild kannst du auch mit einer Textbeschreibung beginnen. Du erhältst: • Eine vollständige Filz-Dreiansicht der Figur von vorne, der Seite und von hinten. • Eine klare Beschreibung des Figurendesigns zur späteren Wiederverwendung. • Wiederverwendbare Generierungsprompts zum weiteren Anpassen und Ausbauen. Der Ablauf erfasst zunächst die Figurenmerkmale, gestaltet anschließend die Filzmaterialität und erstellt die Dreiansicht. Danach werden die Konsistenz von Perspektive, Kleidung, Accessoires und markanten Strukturen geprüft. Sichtbare Abweichungen werden gezielt korrigiert. Details der Rückseite, die auf dem Referenzbild nicht zu sehen sind, werden zurückhaltend ergänzt und gekennzeichnet. Geeignet für eigene IPs, Figuren aus Bilderbüchern und Comics, die visuelle Entwicklung von Kurzvideos sowie Kreative, die beliebte Motive in einen Filzstil übertragen möchten. Die erstellten Designbilder können anschließend als visuelle Referenz für weitere Bildgenerierung, Storyboards und die Teamkommunikation dienen. Überlasse dieser Anleitung das wiederholte Abstimmen von Material-, Perspektiv- und Figurenbeschreibungen und konzentriere dich auf deine Figur und ihre Geschichte.
Lebenslauf-Avatar: 3D-Figur
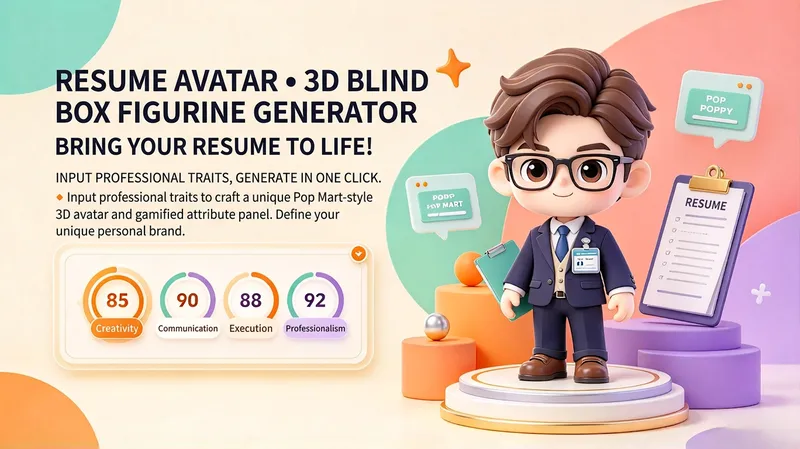
Ein Tool zum visuellen Vermitteln der persönlichen Marke. Herkömmliche Lebensläufe wirken oft austauschbar. Diese Skill extrahiert berufliche Merkmale, Kernkompetenzen und Persönlichkeits-Tags und nutzt 3D-Rendering zur Bildgenerierung, um eine trendige „Berufs-Blindbox-Figur“ mit hochwertiger Designer-Toy-Ästhetik zu erstellen – inklusive einer spielerischen „Figuren-Attributtafel“. Ideal für Designer, Fachleute aus der Internetbranche und Social-Media-Creator – etwa für die Startseite eines Portfolios, ein LinkedIn-Profilbild oder eine persönliche Vorstellung im Bewerbungsgespräch.
 Bild
Asiatische Porträt-Prompts
Dieses Skill wurde speziell für Nutzer entwickelt, die hochwertige Porträt-Prompts für KI-Bildgenerierungsplattformen erstellen möchten. Es eignet sich besonders für Kreative und Designer, die eine asiatische Ästhetik sowie reife und natürlich wirkende Frauenporträts anstreben. Das Skill verwandelt Ihre kreativen Vorstellungen in konkrete, umsetzbare Prompts und sorgt dafür, dass die generierten Bilder ansprechend und mit der jeweiligen Plattform kompatibel sind. Zu den Kernfunktionen gehören die Erstellung von Prompts auf Basis Ihrer Beschreibung für zahlreiche gängige KI-Bildmodelle wie Midjourney, SDXL, Flux, GPT Image, 豆包, 即梦 und ComfyUI. Das Skill erkennt und überarbeitet automatisch potenziell riskante Begriffe, damit die Prompt-Inhalte den Sicherheitsrichtlinien der Plattformen entsprechen und keine kindlich wirkenden, vulgären oder übermäßig auf einzelne Körperpartien fokussierten Formulierungen enthalten. Über Schnellbefehle können Sie außerdem rasch zwischen verschiedenen Bildstilen wechseln, etwa realistische Selfies, Aufnahmen im Stil kommerzieller Magazine, hochwertiges Cosplay, Cyberpunk oder klassische chinesische Ästhetik. Auch die Reparatur von Prompts auf Grundlage von Rückmeldungen zu fehlgeschlagenen Generierungen wird unterstützt. Ganz gleich, ob Sie ein Modemagazin-Cover, ein filmisches Porträt oder das Design einer 3D-CG-Figur erstellen möchten: Dieses Tool liefert präzise sprachliche Beschreibungen und Parametervorschläge. Die fertigen Prompts werden für die ausgewählte Plattform optimiert – etwa als natürliche, flüssige englische Langsätze für Midjourney, als klare Gruppen positiver und negativer Schlüsselwörter für SDXL/Flux oder als detaillierte, modulare Parameterfelder für ComfyUI. So können Sie effizient KI-Porträts erstellen, die Ihren Vorstellungen entsprechen.
Informationen
- Version
- v1
- Zuletzt aktualisiert
- Credits pro Ausführung
- Nach Verbrauch
- Modelle
- Gemini 3.1 Pro
