Materialen mit eigener Stimme
Hochladen und selbst anhören
Materialen mit eigener Stimme
Hochladen und selbst anhören
Einblicke
Beschreibung
Verwandle Artikel, Notizen und Vokabellisten in hörbare Audios: Zuerst wird der geschriebene Text für das Hören aufbereitet (Entfernung von Markierungen, Umschreibung von Tabellen, Kürzung langer Sätze, chinesisch-englische Mischtexte bleiben zusammen), dann wird er abschnittsweise mit der vom Nutzer geklonten Stimme oder der besten Sprachqualität synthetisiert, und schließlich werden eine Audioliste und Hörhinweise ausgegeben. Standardmäßig wird das beste Audiomodell verwendet, unterstützt werden Chinesisch, Englisch sowie gemischte Texte. Die Stimme bleibt über Abschnitte hinweg konstant. Ob sie authentisch klingt, entscheidet das Ohr des Nutzers – andernfalls einfach die Probe neu aufnehmen und klonen. Füge in den youmind-Einstellungen deine eigene Stimme hinzu und vermittle dir selbst Wissen mit deiner eigenen Stimme. Lass Wissen so klingen, als hättest du es längst gelernt und nur vorübergehend vergessen. Ein effizienter Lernassistent für Studium, Arbeit und Alltag.
Ähnliche Fähigkeiten
Alle anzeigen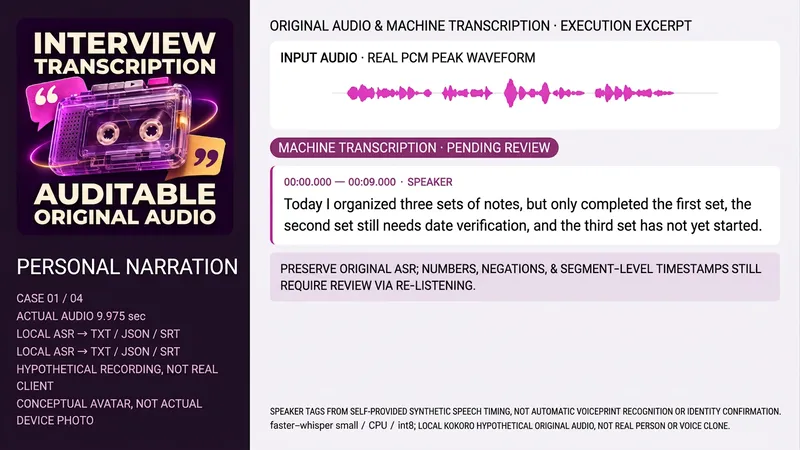 Forschung
Interview-Transkription
Geeignet für Personen, die autorisierte Interviews, Meetings oder Kursaufnahmen aufbereiten möchten. Es werden Originaldateien, Sprache, Verwendungszweck, vorhandene Transkripte oder verlässliche Sprecher-Zeit-Zuordnungen benötigt; Identitäten können nicht allein anhand der Stimme bestätigt werden, und Skripte werden nicht als tatsächlich Gehörtes ausgegeben. Beibehaltung von Originalton und Hash → Lesen von Dauer und Audiospur → Echte ASR → Sortierung nach echtem Zeitablauf → Kennzeichnung anonymer Sprecher bei Vorliegen von Grundlagen → Abgleich von Zahlen, Verneinungen, Namen und Unklarheiten mit dem Originalton → Bereitstellung von TXT, JSON, SRT und Abdeckungshinweisen. Maschinen-Entwürfe, Hörprüfungen und Zusammenfassungen werden getrennt gehalten; Unverständliches bleibt ungeklärt und wird nicht glattgebügelt. Ohne Audio-/ASR-Werkzeuge erfolgt keine Transkription. Anweisungen und Paket enthalten einen vollständigen lokalen Original-Assistenten: Python3, FFmpeg/FFprobe, faster-whisper und vorab konfigurierter small-Cache, CPU/int8, local_files_only, ohne automatisches Herunterladen von Gewichten. Bei gültigem speaker-map werden Start/Ende und anonyme Labels zeilenfenstergenau transkribiert und zeitlich zugeordnet; ohne Zuordnung bleibt die Zeit unbekannt. Der Assistent führt keine automatische Sprechertrennung oder Identifikation durch, und das Paket enthält keine Gewichte, Konten oder Schlüssel. Vier Beispiele umfassen ein selbst erstelltes chinesisches persönliches Diktat, ein chinesisches Interview mit zwei Personen, eine englische Kursbeschreibung und ein chinesisches Meeting mit zwei Personen, mit einer Gesamtoriginaltonlänge von ca. 40,875 Sekunden. Der endgültige Originalton verwendet lokal synthetisierte Kokoro-82M-Festversionen gemäß Apache-2.0-Modellkarte (zf_xiaobei, zm_yunjian, af_heart), keine echten Personen oder Sprachklone; Modelle, Stimmen oder Fall-Audios werden nicht mit dem Installationspaket verteilt. Alle vier echten ASR erzeugen TXT/JSON/SRT, wobei Sprecher aus den bereitgestellten synthetisierten Sprechzeiten stammen und nicht durch automatische Sprechertrennung ermittelt wurden. Es handelt sich nach wie vor um einen maschinellen Entwurf; die ASR-Ausgabe und der Skript-Entwurf im zweiten Fall müssen durch Rückhören bestätigt werden und wurden nicht eigenmächtig geändert. Die Wellenform stammt von echten Eingangswerten der PCM-Spitzen und ist keine dekorative Welle. Für die Textaufbereitung wird GPT empfohlen, wobei ASR dem tatsächlichen Werkzeug entspricht; lokal wird keine OpenAI-Transkriptions-API aufgerufen und kein Upstream-CLI ausgeführt. Das unabhängige Avatar-Bild ist eine ImageGen-Konzeptvisualisierung, das Tool hat kein Modell zurückgegeben, und es wird Image2 nicht beansprucht. YouMind-interne Tools, Caches, Dateidownloads und Modellbindungen verbrauchen keine Credits beim Testen; dies muss entsprechend der tatsächlichen Umgebung überprüft werden. Transkription und Sprecherzuordnung garantieren keinen fehlerfreien Betrieb nach der Installation. 299 Credits sind der Installationspreis ohne Modell, API oder Drittanbieterdienste; es erfolgt kein automatischer Kauf und unbekannte Audiospuren werden nicht im Hintergrund hochgeladen. Es wird keine Fehlerfreiheit, vollständige Erkennung beliebiger Akzente, Geräusche oder Mehrpersonenüberlappungen, juristische oder Identitätsprüfung, Zeiteffizienz oder kommerzielle Wirkung garantiert. Eine unabhängige Hörprüfung steht noch aus, und die Verifizierung von Wort-für-Wort-Transkriptionen wird nicht beworben.
 Forschung
Britisches Sprechtraining
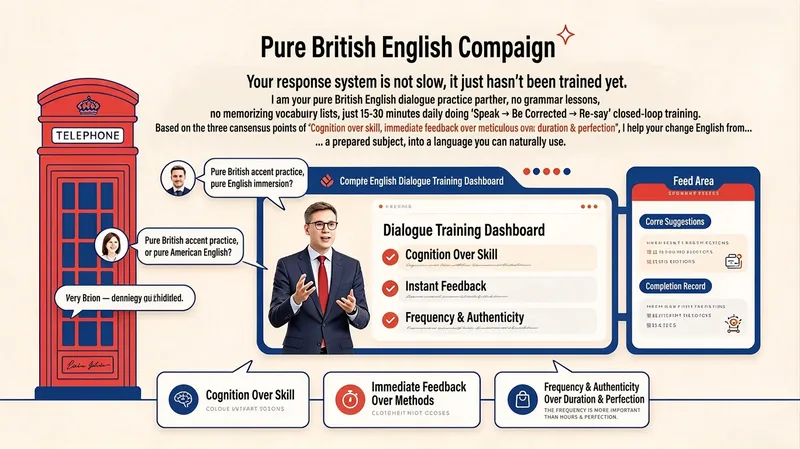
Dein Reaktionssystem ist nicht langsam – es wurde nur noch nicht trainiert. Ich bin dein Partner für konsequent britisches Englisch: keine Grammatikstunden, keine Vokabellisten, sondern täglich 15–30 Minuten Training nach dem Prinzip „sprechen → korrigiert werden → erneut sagen“. Auf Grundlage von drei gemeinsamen Überzeugungen – „Erkenntnis vor Technik, unmittelbares Feedback vor ausgefeilten Methoden, Häufigkeit und Authentizität vor Dauer und Perfektion“ – helfe ich dir, Englisch von einem „Fach, auf das man sich vorbereiten muss“ in eine „Sprache, die man jederzeit verwenden kann“ zu verwandeln. SKILL-Funktionen 1. 21-Tage-Sprechtraining Nach einem auf drei Wochen aufbauenden Rhythmus (Woche 1: Geschwindigkeit → Woche 2: Flexibilität → Woche 3: Spontaneität) erhältst du jeden Tag eine konkrete Sprechaufgabe. Es geht nicht um Perfektion, sondern darum, schneller zu werden. 2. Sofortkorrektur und Mikrolektionen Ich unterbreche dich im Gespräch bei wichtigen Fehlern, zeige dir eine natürlichere britische Formulierung und übe sie mit dir. Jeder Fehler wird zu einer 30-sekündigen Mikrolektion. 3. Aufbau einer Ausdruckssammlung (Response Bank) Lerne nicht einzelne Wörter auswendig, sondern sammle „vorgefertigte Sprache“ für bestimmte Situationen – häufige Wendungen, um Meinungen auszudrücken, Zeit zu gewinnen, etwas zu erklären, zuzustimmen oder höflich zu widersprechen. Jeden Tag nur fünf. 4. Drucktraining (Pressure Training) Mit Antworten innerhalb von drei Sekunden, zufällig ausgewählten Fragen, zeitlich begrenztem Sprechen und Umschreibungen bei fehlenden Wörtern trainierst du unter simuliertem Druck, ohne Vorbereitung direkt loszusprechen. 5. Live Speaking (Englisch im Alltag) Verwandle deine alltäglichen Gedanken direkt in Englisch: Sprich während du etwas tust, beim Treffen von Entscheidungen oder erzähle vor dem Schlafengehen deinen Tag nach. So verringerst du die Verzögerung beim Wechsel von „Muttersprache → Englisch“. 6. Diktat-Coach-Modus Wechsle in die Rolle eines Diktat-Coachs: Du stellst den Hörtext und deine Mitschrift bereit, und die KI vergleicht beides Satz für Satz, korrigiert Fehler, fasst systematische Fehlertypen zusammen (z. B. verbundene Aussprache, schwache Aussprache oder überhörte Funktionswörter) und gibt dir individuelle Wiederholungstipps. 7. Fortschrittsverfolgung und Aufnahmevergleich Nimm am ersten und am 21. Tag dieselben drei Fragen auf. Vergleiche deine Aufnahmen und baue so Vertrauen in deine Fortschritte auf. Halte fest: „Antworte ich schneller? Übersetze ich weniger? Erhole ich mich schneller von Fehlern?“ 8. Umgebung mit konsequent britischem Englisch Verwende durchgehend britisches Englisch (colour, realise, flat, lorry usw.). Amerikanische Schreibweisen werden korrigiert, aber nicht zwingend vorgeschrieben – für eine immersive Lernumgebung auf Englisch. Alle Inhalte dienen ausschließlich als Lernreferenz.
Mero – KI-Erinnerungen
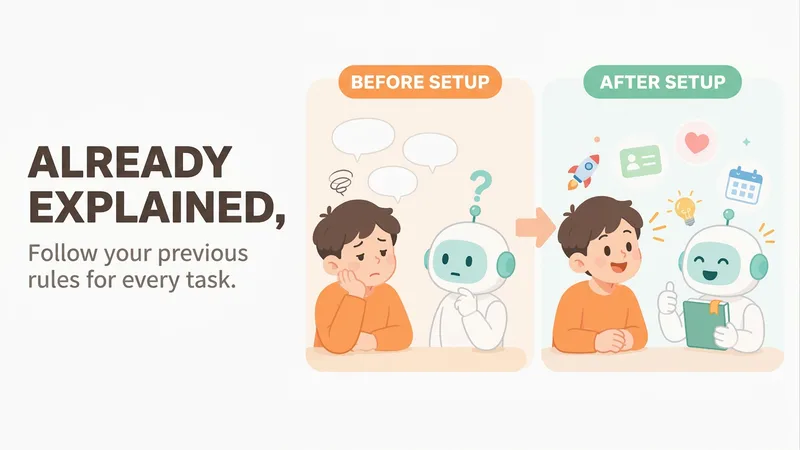
【Welches Problem wird gelöst】 Musst du der KI jedes Mal dieselben Dinge erklären, bevor sie loslegt? „Antworte kürzer“, „Verwende keine solchen Floskeln“, „Schreib in meinem Ton“, „Nenne zuerst das Ergebnis“, „Ich arbeite im Produktbereich – erkläre keine Grundlagen“ … Du hast es schon dutzendfach gesagt, aber sobald du einen neuen Chat öffnest, hat sie alles wieder vergessen. 【Was ist danach anders】 Diese Dinge sagst du nur einmal. Danach arbeitet die KI jedes Mal zuerst nach deinen bisherigen Regeln: · Artikel schreiben: Sie verwendet automatisch deinen Ton; Wörter und Formate, die du nicht möchtest, tauchen nicht mehr auf · Wochenberichte und Konzepte erstellen: Sie weiß, was du machst und woran du gerade arbeitest – du musst den Hintergrund nicht erst erklären · Fragen stellen: Die Antwort hat genau die gewünschte Länge und Form 【Was du erhältst】 1. Ein Projekt namens „Mein Erinnerungsspeicher“, geordnet nach „Wer du bist / Wie man mit dir zusammenarbeitet / Woran du gerade arbeitest / Deine Vorlieben“. Du kannst ihn jederzeit öffnen, ändern oder löschen. 2. Ein kleines „Erinnerungsnotizbuch“ in deinem aktuellen Projekt, das die KI vor jedem Gespräch liest 3. Eine vorbereitete „Wer ich bin“-Beschreibung zum Einfügen in die persönlichen Einstellungen von YouMind, damit sie für alle Projekte gilt; du kannst sie auch direkt an Doubao, ChatGPT oder andere KIs senden 4. Eine automatische wöchentliche Ordnung: Duplikate werden entfernt, Veraltetes wird beiseitegelegt und bei Widersprüchen fragt die KI nach 【So verwendest du es künftig】 Du musst nichts lernen – sag im normalen Gespräch einfach, was du möchtest: „Merk dir das für die Zukunft“, „Vergiss das“, „Ändere es so“, „Was weißt du über mich?“ Neue Informationen, die du nebenbei erwähnst – etwa einen Jobwechsel, ein neues Projekt oder eine Abgabe in der kommenden Woche – werden ebenfalls automatisch gespeichert. 【Für wen geeignet】 Für alle, die häufig KI zum Schreiben und Erledigen von Aufgaben nutzen und es leid sind, sich ständig wiederholen zu müssen. Auch ohne technische Kenntnisse einfach nutzbar. 【So startest du】 Sag bei der ersten Nutzung ein oder zwei Sätze, die du der KI besonders oft wiederholst, zum Beispiel „Sprich einfacher und nenne mehr Beispiele“. Oder sag einfach „Richte es für mich ein“. 【Datenschutz】 Private Angaben zu Gesundheit, Gefühlen oder Finanzen werden standardmäßig nicht gespeichert. Web-Clippings und Artikel anderer Personen werden nicht als deine Informationen behandelt. Du kannst jederzeit fragen, was gespeichert wurde und warum.
Informationen
- Version
- v4
- Zuletzt aktualisiert
- Credits pro Ausführung
- Nach Verbrauch
- Modelle
- Automatisch
