Videotranskription
Videotranskription
Einblicke
Beschreibung
Transkribieren Sie lokale Video- oder Audiodateien in mit Zeitstempeln versehene SRT-Untertitel und Klartext, wobei die lokale Verarbeitung bevorzugt und konfigurierte Remote-ASR-Dienste nach Zustimmung unterstützt werden.
Ähnliche Fähigkeiten
Alle anzeigen Schreiben
Audio zu Entwurf
Eine Audiodatei, Sprachnachricht, ein gesprochenes Video oder ein Transkript in einen zusammenhängenden, bearbeitbaren Entwurf verwandeln. Fehlender gesprochener Text wird automatisch transkribiert und bei Bedarf im Hintergrund weiterverarbeitet, sodass du den Vorgang nicht erneut aufrufen musst.
 Forschung
Audio: To-dos & Entscheidungen
Wandle eine Audiodatei oder ein Transkript in eine kompakte, bearbeitbare Übersicht über Entscheidungen, Aufgaben, Verantwortliche, Termine, Blockaden und offene Fragen um. Fehlender Sprachtext wird automatisch transkribiert – bei Bedarf mit Fortsetzung im Hintergrund –, bevor optionale Agent-Aktionen vorgeschlagen werden.
 Forschung
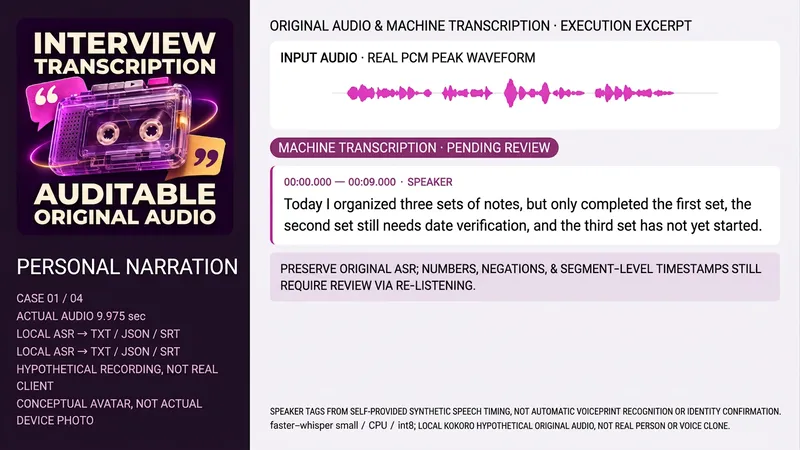
Interview-Transkription
Geeignet für Personen, die autorisierte Interviews, Meetings oder Kursaufnahmen aufbereiten möchten. Es werden Originaldateien, Sprache, Verwendungszweck, vorhandene Transkripte oder verlässliche Sprecher-Zeit-Zuordnungen benötigt; Identitäten können nicht allein anhand der Stimme bestätigt werden, und Skripte werden nicht als tatsächlich Gehörtes ausgegeben. Beibehaltung von Originalton und Hash → Lesen von Dauer und Audiospur → Echte ASR → Sortierung nach echtem Zeitablauf → Kennzeichnung anonymer Sprecher bei Vorliegen von Grundlagen → Abgleich von Zahlen, Verneinungen, Namen und Unklarheiten mit dem Originalton → Bereitstellung von TXT, JSON, SRT und Abdeckungshinweisen. Maschinen-Entwürfe, Hörprüfungen und Zusammenfassungen werden getrennt gehalten; Unverständliches bleibt ungeklärt und wird nicht glattgebügelt. Ohne Audio-/ASR-Werkzeuge erfolgt keine Transkription. Anweisungen und Paket enthalten einen vollständigen lokalen Original-Assistenten: Python3, FFmpeg/FFprobe, faster-whisper und vorab konfigurierter small-Cache, CPU/int8, local_files_only, ohne automatisches Herunterladen von Gewichten. Bei gültigem speaker-map werden Start/Ende und anonyme Labels zeilenfenstergenau transkribiert und zeitlich zugeordnet; ohne Zuordnung bleibt die Zeit unbekannt. Der Assistent führt keine automatische Sprechertrennung oder Identifikation durch, und das Paket enthält keine Gewichte, Konten oder Schlüssel. Vier Beispiele umfassen ein selbst erstelltes chinesisches persönliches Diktat, ein chinesisches Interview mit zwei Personen, eine englische Kursbeschreibung und ein chinesisches Meeting mit zwei Personen, mit einer Gesamtoriginaltonlänge von ca. 40,875 Sekunden. Der endgültige Originalton verwendet lokal synthetisierte Kokoro-82M-Festversionen gemäß Apache-2.0-Modellkarte (zf_xiaobei, zm_yunjian, af_heart), keine echten Personen oder Sprachklone; Modelle, Stimmen oder Fall-Audios werden nicht mit dem Installationspaket verteilt. Alle vier echten ASR erzeugen TXT/JSON/SRT, wobei Sprecher aus den bereitgestellten synthetisierten Sprechzeiten stammen und nicht durch automatische Sprechertrennung ermittelt wurden. Es handelt sich nach wie vor um einen maschinellen Entwurf; die ASR-Ausgabe und der Skript-Entwurf im zweiten Fall müssen durch Rückhören bestätigt werden und wurden nicht eigenmächtig geändert. Die Wellenform stammt von echten Eingangswerten der PCM-Spitzen und ist keine dekorative Welle. Für die Textaufbereitung wird GPT empfohlen, wobei ASR dem tatsächlichen Werkzeug entspricht; lokal wird keine OpenAI-Transkriptions-API aufgerufen und kein Upstream-CLI ausgeführt. Das unabhängige Avatar-Bild ist eine ImageGen-Konzeptvisualisierung, das Tool hat kein Modell zurückgegeben, und es wird Image2 nicht beansprucht. YouMind-interne Tools, Caches, Dateidownloads und Modellbindungen verbrauchen keine Credits beim Testen; dies muss entsprechend der tatsächlichen Umgebung überprüft werden. Transkription und Sprecherzuordnung garantieren keinen fehlerfreien Betrieb nach der Installation. 299 Credits sind der Installationspreis ohne Modell, API oder Drittanbieterdienste; es erfolgt kein automatischer Kauf und unbekannte Audiospuren werden nicht im Hintergrund hochgeladen. Es wird keine Fehlerfreiheit, vollständige Erkennung beliebiger Akzente, Geräusche oder Mehrpersonenüberlappungen, juristische oder Identitätsprüfung, Zeiteffizienz oder kommerzielle Wirkung garantiert. Eine unabhängige Hörprüfung steht noch aus, und die Verifizierung von Wort-für-Wort-Transkriptionen wird nicht beworben.
Informationen
- Version
- v2
- Zuletzt aktualisiert
- Credits pro Ausführung
- Nach Verbrauch
- Modelle
- Automatisch
