Analizador no verbal
Lee rostros y señales sociales sutiles
Analizador no verbal
Lee rostros y señales sociales sutiles
Vista previa
Descripción
Ve más allá de etiquetas obvias como «feliz», «enojado» o «seguro de sí mismo». Analizador no verbal examina los pequeños detalles visuales que influyen en cómo se percibe a una persona o interacción: tensión facial, dirección de la mirada, párpados, boca y mandíbula, posición de la cabeza, hombros, postura, manos, orientación corporal, distancia física, asimetrías y contradicciones entre señales. Antes de comenzar el análisis, hace solo algunas preguntas relevantes de contexto para no interpretar la imagen de forma aislada. Un momento espontáneo, un retrato posado, una conversación, una escena laboral o una dinámica de pareja pueden tener significados muy diferentes. Luego, la Skill conecta las pistas individuales para ofrecer una interpretación coherente, en lugar de simplemente enumerarlas. Busca señales que se apoyan entre sí, explicaciones alternativas y detalles que pueden pasar desapercibidos, como un rostro relajado acompañado de manos tensas, una sonrisa que no coincide con el resto del cuerpo o una dirección de la mirada que contradice la orientación del torso. Cuando se solicita, el informe también puede incluir perspectivas tradicionales de la fisonomía, como las tradiciones turcas/otomanas kıyafetname y firaset, la fisonomía occidental, el Mian Xiang chino o una comparación intercultural. Las interpretaciones históricas se mantienen claramente separadas del análisis no verbal moderno y se citan fuentes cuando hay investigación disponible. El informe final está diseñado para ser profundo, pero fácil de leer: ofrece una interpretación clara, pistas sutiles, explicaciones alternativas, contradicciones importantes y las conclusiones más relevantes, sin convertir el resultado en un artículo académico ni reducirlo a una etiqueta superficial de emociones.
Habilidades relacionadas
Ver todo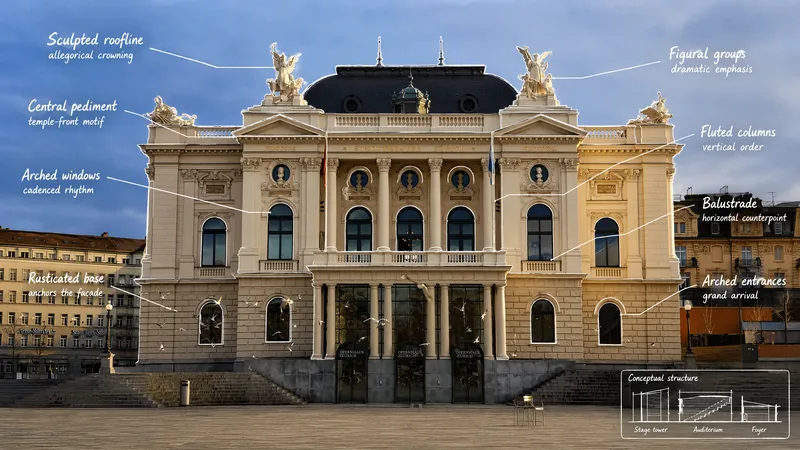 Imagen
Anotador de escenas visuales
Convierte una foto en una explicación visual de por qué importan sus detalles. La Skill traza ángulos, formas, uniones, capas y componentes relevantes sobre la imagen original; después explica su función, significado visual, contexto pertinente y posibles influencias de diseño. Cuando resulta útil, añade junto a la foto una vista conceptual de corte o de piezas separadas, claramente identificada, para mostrar cómo podría estar estructurado el objeto en su interior. Los hechos observados, el contexto verificado y las inferencias visuales se mantienen claramente separados.
 Investigación
Signal Room:Síntesis de entrev
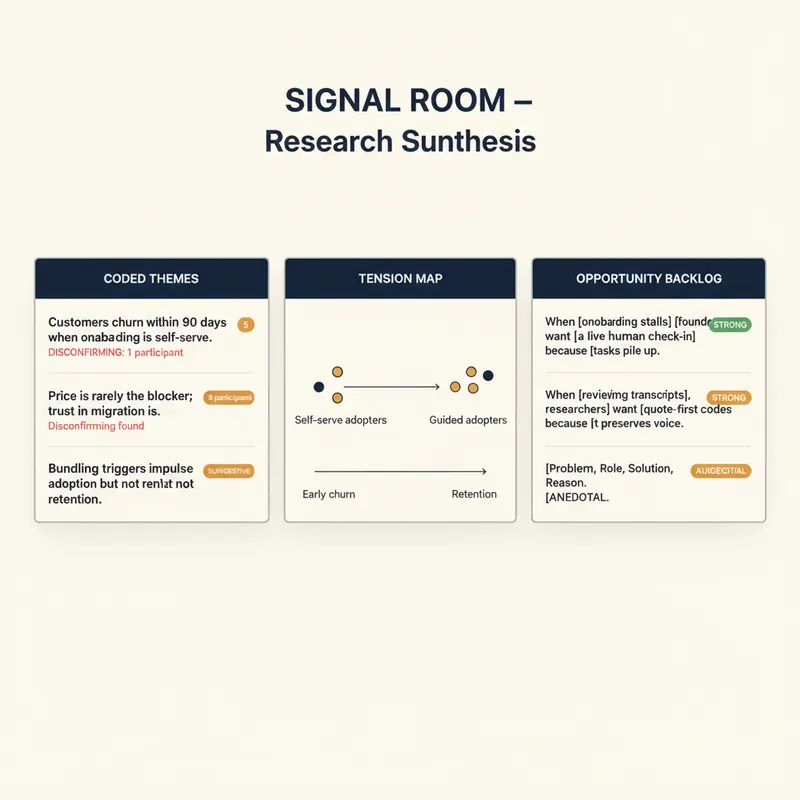
YouMind ya transcribe tus llamadas, entrevistas y podcasts. Signal Room es lo que sucede después. Sube una transcripción o veinte y recibe una síntesis de investigación que un analista de verdad firmaría: temas codificados, evidencia textual con marcas de tiempo, los puntos de desacuerdo, y una respuesta ordenada a la decisión que intentas tomar. El método es práctica cualitativa real, no resumen: • Codificación abierta que funciona con citas primero — sin cita, no hay código — con códigos nombrados con las palabras de los participantes, no con jerga de analista • Cada código etiquetado como Comportamiento, Creencia o Deseo, porque «definitivamente pagaría por eso» no es la misma clase de evidencia que «pagué por eso el mes pasado» • Temas presentados como oraciones falsables, con la fuerza contada en participantes más que en citas, y evidencia desconfirmante buscada a propósito • Un mapa de tensiones que muestra dónde se dividen realmente tus participantes y qué predice de qué lado caen • Un backlog de oportunidades escrito como «cuando [situación], [quién] quiere [resultado] porque [razón]», cada uno calificado como Fuerte, Sugerente o Anecdótico • Una respuesta directa a tu pregunta de decisión, con un nivel de confianza declarado y qué lo cambiaría • Las tres preguntas que esta ronda no pudo responder, y a quién entrevistar a continuación Protecciones que importan: nunca inventa ni pule una cita, se niega a reportar porcentajes con menos de doce participantes, seudonimiza a los participantes por defecto, y te dirá en la cara cuando n=1 significa que tienes una hipótesis y no un hallazgo. Para gerentes de producto, investigadores de UX y de mercado, periodistas, consultores, fundadores en descubrimiento de clientes, y cualquier persona con horas de grabaciones y sin hallazgos.
Retratos cinematográficos
Describe a una persona y una escena: quién es, qué lleva puesto, dónde se encuentra y cuál es la luz o el ambiente. Esta habilidad crea el prompt y genera un conjunto de retratos cinematográficos fotorrealistas. Si falta algún detalle, lo completa con un valor predeterminado de buen gusto y coherente para que siempre obtengas un resultado útil. Funciona con cualquier persona, cultura, vestuario o entorno.
Información
- Versión
- v9
- Última actualización
- Créditos por ejecución
- Según el uso
- Modelos
- Automático
