Transcripción de Video
Transcripción de Video
Vista previa
Descripción
Transcribe video o audio local en subtítulos SRT con marcas de tiempo y texto plano, priorizando el procesamiento local y admitiendo servicios de reconocimiento de voz remotos configurados con consentimiento.
Habilidades relacionadas
Ver todo Escribir
Audio a borrador
Convierte un archivo de audio, una nota de voz, un video con voz o una transcripción en un borrador editable y coherente. El texto hablado que falte se transcribe automáticamente, con continuación en segundo plano cuando es necesario, para que no tengas que volver a entrar y reanudar el flujo de trabajo.
 Investigación
Audio a tareas y decisiones
Convierte un archivo de audio o una transcripción en un registro conciso y editable de decisiones, tareas, responsables, fechas, bloqueos y preguntas abiertas. El texto de voz faltante se transcribe automáticamente, con continuación en segundo plano cuando es necesario, antes de proponer cualquier acción opcional del agente.
 Investigación
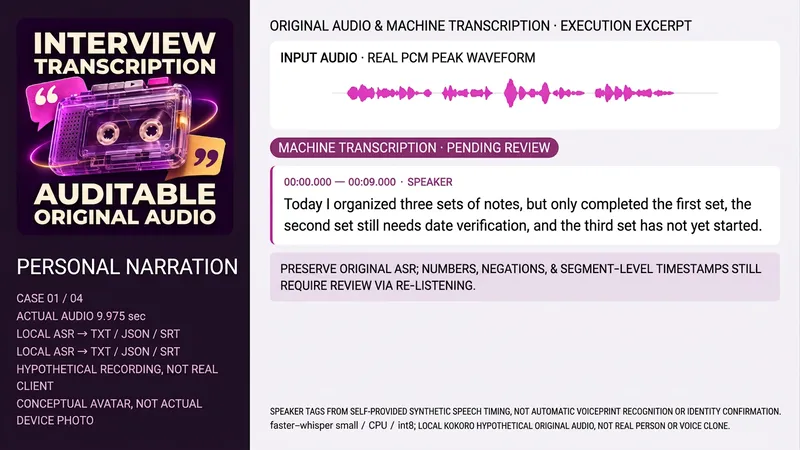
Transcripción de entrevistas
Adecuado para quienes necesitan organizar grabaciones autorizadas de entrevistas, reuniones o clases. Proporcione el archivo original, el idioma, el uso previsto, la transcripción existente o el mapeo confiable de tiempos de los oradores; no se puede confirmar la identidad solo por la voz ni tratar los guiones como lo que realmente se escucha. Conserva el audio original y el hash → lee la duración/pista de audio → ASR real → organiza según la cronología real → etiqueta a los oradores anónimos cuando haya bases → contrasta con el audio original para números, negaciones, nombres y dudas → entrega TXT, JSON, SRT y notas de cobertura. El borrador automático, la revisión auditiva y el resumen van por separado; lo que no se entienda claramente se mantiene pendiente de verificación sin rellenar palabras para que suene fluido. Si no hay herramientas de audio o ASR, se indica claramente que no se ha transcrito. Las instrucciones y el paquete incluyen un asistente local original completo: Python3, FFmpeg/FFprobe, faster-whisper y caché small preconfigurada, CPU/int8, local_files_only, sin descarga automática de pesos. Con un speaker-map confiable, se transcribe según el intervalo real y se mapean los tiempos; si no hay mapeo, las marcas de tiempo quedan como desconocidas. El asistente no realiza separación automática de voz ni identificación de identidad, y el paquete no incluye pesos, cuentas ni claves. Los cuatro ejemplos corresponden a una narración personal en chino, una entrevista en chino entre dos personas, una explicación de curso en inglés y una reunión en chino entre dos personas, con un audio original total de unos 40.875 segundos. El audio original final utiliza una versión local fija de Kokoro-82M indicada en la tarjeta de modelo Apache-2.0 (zf_xiaobei, zm_yunjian, af_heart), sin ser personas reales ni clonación de voz; el paquete no distribuye modelos, voces ni audios de ejemplo. Los cuatro ejemplos de ASR real generan archivos TXT/JSON/SRT; los oradores provienen de los tiempos de habla sintéticos proporcionados y no de una separación automática de oradores. Sigue siendo un borrador automático; la divergencia del ASR y el guion en el segundo ejemplo queda pendiente de revisión auditiva sin modificar la frase original dicha. La forma de onda proviene de los picos PCM de entrada reales y no es una onda decorativa. Se recomienda GPT para la organización de texto y las herramientas ASR correspondientes; no se llama a la API de transcripción de OpenAI ni se ejecutan CLI ascendentes a nivel local. El avatar independiente es una visualización de concepto de ImageGen, la herramienta no devolvió un modelo y no se proclama como Image2. Las herramientas de YouMind, las caché, las descargas de archivos y la vinculación de modelos no consumen puntos de prueba; es necesario confirmar según el entorno real. La transcripción y la organización de oradores no garantizan una ejecución sin dependencias tras la instalación. Los 299 puntos corresponden al precio de instalación y no incluyen modelos, API ni servicios de terceros; no compran automáticamente ni cargan pistas de audio desconocidas en servicios adicionales. No se promete cero errores, reconocimiento completo de acentos, ruido o superposición de múltiples voces, peritaje judicial o de identidad, eficiencia de tiempo ni efectos comerciales. La revisión auditiva independiente está pendiente y no se publicita la verificación palabra por palabra.
Información
- Versión
- v2
- Última actualización
- Créditos por ejecución
- Según el uso
- Modelos
- Automático
