Investigación bio/med fiable
Investigación bio/med fiable
Descripción
Escenario: Realizar una búsqueda de literatura científica biológica/biomédica y proporcionar al usuario resultados detallados y fiables. 1. El usuario inicia la búsqueda y el sistema descompone el problema y las palabras clave. 2. Utiliza fuentes de datos públicas y reproducibles para buscar literatura. 3. Realiza deduplicación, estratificación, clasificación de evidencia y ordenación de los resultados. 4. Incluye referencias en el texto que se pueden hacer clic en las respuestas. 5. Al final, enumera la información completa de las referencias una por una, y marca el IF utilizando rutas verificables públicamente; si no es posible una verificación de alta confianza, debe marcarse como 'por verificar' o 'no detectado'.
Recomendado por
Nico@YouMind
Por qué recomendamos esta habilidad
Esta habilidad es una guía fiable para la investigación biomédica. Mediante consultas estructuradas, filtrado de literatura en múltiples etapas y verificación rigurosa del IF, garantiza información científica altamente precisa y verificable.
Vista previa
1 / 2
Instrucciones
El núcleo de este proceso es: primero, usar múltiples consultas para realizar una selección inicial reproducible en PubMed/NCBI E-utilities, luego usar PMID para la eliminación de duplicados y la clasificación de la evidencia del resumen; solo un pequeño número de documentos clave ingresan a la revisión de texto completo de PMC/BioC; las citas en el texto deben ser clicables; la información bibliográfica completa debe figurar al final del artículo; el FI solo se puede verificar de manera conservadora a través de fuentes de acceso público, y no se puede asumir que tenga JCR o bases de datos locales, no se puede adivinar, y las coincidencias de baja confianza no se pueden tratar como resultados definitivos.
1. Preprocesamiento después de que un usuario inicia una búsqueda
1.1 Primero, analice la pregunta del usuario.
Tras recibir la pregunta del usuario, esta, formulada en lenguaje natural, se descompone primero en elementos estructurados.
Debe identificarse:
• Temas de investigación: genes, proteínas, fármacos, canales iónicos, tipos de células, tejidos, enfermedades y modelos.
• Sistemas biológicos: humanos, ratones, ratas, peces cebra, organoides, retina, regiones cerebrales, líneas celulares, etc.
• Tipos de relaciones: expresión, regulación, función, mecanismo, fenotipo, muerte, supervivencia, tratamiento, toxicidad, desarrollo, degeneración, etc.
• Requisitos de evidencia: Si se requieren evidencia directa, evidencia mecanicista, evidencia de texto completo, gráficos, parámetros de dosificación y métodos experimentales.
• Periodo de tiempo: tiempo ilimitado, los últimos 5 años, el último año, los últimos avances y literatura clásica.
• Tipos de resultados: respuesta breve, literatura representativa, resumen de la revisión, sugerencias de diseño experimental, tabla de evidencia, diagrama de mecanismo.
Ejemplo:
Problema del usuario:
"Por favor, ayúdenme a encontrar bibliografía relacionada con la muerte de organoides retinianos."
Descomposición estructurada (ejemplo):
• Modelos principales: organoide retiniano, organoide retiniano, organoide retiniano derivado de células madre pluripotentes humanas, organoide de copa óptica.
• Fenotipo: muerte celular, apoptosis, degeneración, pérdida de supervivencia, estrés, necrosis.
• Células relacionadas: fotorreceptor, cono, bastón, célula ganglionar de la retina, glía de Müller.
• Mecanismos potenciales: estrés oxidativo, estrés del RE, disfunción mitocondrial, hipoxia, inflamación, ferroptosis, necroptosis.
• Objetivos de la evidencia: Priorizar los estudios originales que observen directamente la muerte/apoptosis/degeneración celular en organoides retinianos humanos o animales; luego, buscar bibliografía sobre mecanismos indirectos.
1.2 Principios de segmentación por palabras clave (Ejemplo)
No te limites a escribir una sola consulta de búsqueda. Prepara al menos tres categorías de términos para cada concepto.
Categoría 1: Palabras precisas.
• organoide retiniano
• organoide de retina
• organoide retiniano humano
• organoide retiniano derivado de hPSC
• Organoide retiniano derivado de células iPSC
La segunda categoría: sinónimos e hiperónimos.
• organoide de copa óptica
• Cultivo de retina en 3D
• retina derivada de células madre
• diferenciación retiniana
• Modelo de tejido retiniano
La tercera categoría: mecanismos y términos fenotípicos.
• apoptosis
• muerte celular
• degeneración
• supervivencia
• estrés
• estrés oxidativo
• Estrés del RE
• disfunción mitocondrial
• hipoxia
• necroptosis
• ferroptosis
Si el usuario especifica el tipo de celda, agregue:
• fotorreceptor
• cono
• vara
• célula ganglionar de la retina
• Müller glia
• célula bipolar
• célula amacrina
Si el usuario especifica la especie o el origen, añada:
• humano
• ratón
• rata
• pez cebra
• Células madre embrionarias humanas
• Células iPSC
• célula madre pluripotente
1.3 Generación de consultas de búsqueda jerárquicas
Genera al menos entre 3 y 6 consultas. Cada consulta corresponde a un objetivo de búsqueda.
Primera capa: Recuperación directa de pruebas.
Se utiliza para encontrar bibliografía que coincida directamente con el modelo objetivo y el fenotipo objetivo.
```text
("organoide retiniano" O "organoide de retina" O "organoide retiniano humano") Y (apoptosis O "muerte celular" O degeneración)
```
Segunda capa: Recuperación de modelo extendido.
Se utiliza para incluir textos en los que el autor no utiliza el término preciso "organoide retiniano", pero que en realidad es relevante.
```text
("organoide de copa óptica" O "cultivo retiniano 3D" O "retina derivada de células madre") Y (supervivencia O apoptosis O estrés)
```
La tercera capa: búsqueda específica del mecanismo.
Se utiliza para verificar vías o mecanismos específicos.
```text
("organoide retiniano" O "organoide de retina") Y ("estrés oxidativo" O "estrés del RE" O hipoxia O mitocondrias)
```
Cuarta capa: Búsqueda específica por tipo de celda.
```text
("organoide retiniano" O "organoide de retina") Y (fotorreceptor O cono O bastón O "célula ganglionar de la retina") Y (muerte O apoptosis O degeneración)
```
Quinta capa: Recuperación del modelo de enfermedad.
```text
("organoide retiniano" O "organoide de retina") Y (enfermedad O degeneración O distrofia O retinitis O glaucoma)
```
Sexta capa: Revisión/búsqueda de antecedentes.
```text
("organoide retiniano" O "organoide de retina") Y (revisión O protocolo O modelo)
```
2. ¿Qué métodos y sitios web se utilizaron para la búsqueda?
2.1 Preferible: PubMed / Utilidades electrónicas del NCBI
PubMed es la herramienta preferida para la búsqueda de literatura biomédica. No utilice la extracción de datos de las páginas de PubMed por defecto. En su lugar, utilice la API de utilidades electrónicas del NCBI.
2.1.1 ESearch: Recuperación de PMID mediante una consulta
interfaz:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi
```
parámetro:
```text
db=pubmed
término=
retmode=json
retmax=20
ordenar=relevancia
```
También puedes ordenar por tiempo:
```text
ordenar=fecha+de+publicación
```
Ejemplo:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=pubmed&term=(%22retinal%20organoid%22%20OR%20%22retina%20organoid%22)%20AND%20(apoptosis%20OR%20%22cell%20death%22)&retmode=json&retmax=20&sort=relevance
```
Lea el regreso:
```text
esearchresult.idlist
```
Esta es la lista de PMID.
2.1.2 Resumen: Obtención de metadatos bibliográficos
interfaz:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi
```
parámetro:
```text
db=pubmed
id=PMID1,PMID2,PMID3
retmode=json
```
Campos extraídos:
• PMID
• título
• nombre completo de la revista
• Abreviatura de la fuente/revista
• fecha de publicación
• autores
• DOI y PMCID en los identificadores de los artículos
• volumen, número, páginas
2.1.3 EFetch: Recuperación de resumen y detalles XML
interfaz:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/efetch.fcgi
```
parámetro:
```text
db=pubmed
id=PMID1,PMID2
modo de retorno=xml
tipo de ret=abstracto
```
Campos extraídos:
• Título del artículo
• Texto abstracto
• Título de la revista
• Abreviatura ISO
• ISSN / eISSN
• Fecha de publicación
• DOI
• PMCID
• Términos MeSH
2.1.4 Estrategia de recuperación por lotes
Proceso recomendado:
1. Llama a ESearch para cada consulta.
2. Para cada consulta, seleccione los primeros 5 a 20 resultados.
3. Fusionar todos los PMID.
4. Utilice PMID para eliminar duplicados.
5. Utilice ESummary / EFetch para recuperar metadatos y datos de resumen en lotes.
6. En la etapa de selección inicial, lea únicamente los metadatos y el resumen; no comience leyendo el texto completo.
────────────────
2.2 Segunda fase: Revisión completa de los documentos PMC/BioC
El texto completo solo se incluirá en los siguientes casos:
• Los usuarios solicitan leer el texto completo con atención.
• El resumen es insuficiente para determinar el mecanismo.
• Requiere tablas, métodos experimentales, concentraciones, dosis, IC50, EC50, Kd y Ki.
• Se ha identificado un pequeño número de PMID clave que requieren revisión caso por caso.
2.2.1 PMID a PMCID
interfaz:
```text
https://www.ncbi.nlm.nih.gov/pmc/utils/idconv/v1.0/?ids=
```
Si se devuelve PMCID, significa que PMC puede tener el texto completo abierto.
2.2.2 Priorizar BioC JSON
interfaz:
```text
https://www.ncbi.nlm.nih.gov/research/bionlp/RESTful/pmcoa.cgi/BioC_json/
```
Ventajas: Altamente estructurado, adecuado para extraer párrafos de texto principales.
2.2.3 Pruebe con PMC XML cuando BioC no esté disponible
interfaz:
```text
https://www.ncbi.nlm.nih.gov/pmc/articles/
```
Omitir al extraer el texto principal:
• referencias
• bibliografía
• Agradecimientos
• contribuciones de los autores
• intereses contrapuestos
La revisión del texto completo debe incluir un criterio de detención:
• Cada documento se escanea solo una vez.
• Por defecto, solo se extraen los párrafos relacionados con la pregunta.
• Si el campo de destino no coincide, márquelo como "No se encontró evidencia directa".
• Evite extraer palabras clave repetidamente.
────────────────
2.3 bioRxiv / medRxiv
Se utiliza para complementar las últimas preimpresiones.
Puedes utilizar la API oficial:
```text
https://api.biorxiv.org/details/biorxiv/AAAA-MM-DD/AAAA-MM-DD
https://api.biorxiv.org/details/medrxiv/AAAA-MM-DD/AAAA-MM-DD
```
También puedes utilizar una búsqueda normal como complemento:
```text
sitio:biorxiv.org apoptosis de organoides retinianos
sitio:medrxiv.org degeneración de organoides de la retina
```
Los preprints deben estar etiquetados:
```text
Este es un preimpreso y no ha sido revisado por pares.
```
────────────────
2.4 Crossref/OpenAlex/Unpaywall
Se utiliza para completar el DOI, la dirección de acceso al texto completo y la información de publicación.
Referencia cruzada:
```text
https://api.crossref.org/works?query.title=<title>
```
OpenAlex:
```text
https://api.openalex.org/works?search=
```
Unpaywall:
```text
https://api.unpaywall.org/v2/
```
usar:
• Finalización del DOI.
• Búsqueda de enlaces PDF de acceso abierto.
• Verificación del nombre de la revista.
• Verificación del año de publicación.
────────────────
2.5 Página del editor
Acceda a la página del editor únicamente cuando la información de la API sea insuficiente.
Reglas de acceso:
• Cada URL del editor se intentará solo una vez.
• Si encuentra CAPTCHAs, barreras de inicio de sesión, Cloudflare, acceso denegado o barreras de acceso institucional, deténgase inmediatamente.
• Evite actualizar repetidamente la página, cambiar la ruta dentro del mismo sitio o esperar en un bucle.
• Utilice PubMed, PMC, Crossref, OpenAlex, Unpaywall y los metadatos DOI como alternativa.
3. Cómo organizar la información después de su recuperación
3.1 Establecer una estructura de registro unificada
Cada documento se recopila en un registro unificado.
Campos:
```text
pmid
hacer
pmcid
título
autores
diario
abreviatura de revista
issn
eissn
año
abstracto
fuente_de_consulta
nivel_de_evidencia
etiquetas_de_evidencia
tipo_de_papel
URL
```
3.2 Eliminación de duplicados
Prioridad:
1. Eliminación de duplicados de PMID.
2. Utilice el DOI para eliminar duplicados si el PMID no está disponible.
3. Si no hay DOI, utilice lower(title) + year + first_author para eliminar duplicados.
Conserva la consulta de origen que se utilizó la primera vez y registra qué consultas accedieron al documento.
3.3 Clasificación de la evidencia
Es necesario distinguir:
Pruebas directas:
La especie objetivo, el tejido, el tipo de célula, el modelo y las condiciones de tratamiento coinciden directamente.
Evidencia indirecta:
Se admiten sistemas adyacentes, modelos similares y mecanismos similares, pero no son sistemas directos para resolver problemas de los usuarios.
No se encontraron pruebas directas:
Solo se pueden encontrar antecedentes, especulaciones, reseñas o modelos relacionados; no hay resultados experimentales directos.
3.4 Etiquetado de tipos de documentos
Al menos cabe destacar lo siguiente:
• investigación original
• revisar
• protocolo
• preimpresión
• conjunto de datos/recurso
• estudio clínico
• documento de metodología
3.5 Reglas de clasificación
Ordenación recomendada:
1. Investigación original con evidencia directa.
2. Investigación sobre mecanismos clave.
3. Últimas investigaciones importantes.
4. Estudios fundamentales clásicos.
5. Reseña de alta calidad.
6. Evidencia indirecta.
No ordene únicamente por el factor de impacto (FI). El FI es un indicador a nivel de revista y no equivale a la calidad de un artículo individual.
4. Cómo organizar las citas en una respuesta
4.1 Formato de citación de texto
Todas las citas textuales deben ser clicables.
Formato:
```rebaja
[[1. **Revista**, Año]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
```
Ejemplo:
```rebaja
Estudios previos han observado estrés y degeneración de fotorreceptores relacionados con la etapa de desarrollo en organoides retinianos humanos [[1. **Cell Stem Cell**, 2019]](https://pubmed.ncbi.nlm.nih.gov/xxxxxxx/).
```
No lo escriba como:
```text
[1]
(PMID: xxxxx)
Véase la referencia 1.
```
4.2 Estructura de respuesta recomendada
Primer párrafo: Conclusión directa.
```text
Conclusión: Ha habido informes relevantes, pero la evidencia directa se centra principalmente en...; aún falta evidencia directa sobre...
```
Segundo párrafo: Clasificación de la evidencia.
```text
Pruebas directas:
- Referencia A: ...
Evidencia indirecta:
- Referencia B: ...
No se encontraron pruebas directas:
- No se encontró en esta ronda...
```
Tercer párrafo: Resumen del mecanismo.
Agrupar por tema, por ejemplo:
• Vía de apoptosis/caspasa
• estrés oxidativo
• disfunción mitocondrial
• Estrés del RE
• hipoxia/estrés metabólico
• inflamación
• Desajuste del desarrollo
Cuarto párrafo: Brecha en la investigación.
Indique claramente qué cuestiones carecen de pruebas directas.
Quinto párrafo: Inspiración del experimento.
Si el usuario necesita un diseño experimental, proporcione el marcador, el ensayo, el punto temporal y el control.
5. Lista completa de referencias al final del artículo.
Si en el texto se cita alguna referencia específica, se debe adjuntar una lista completa al final del artículo.
Formato:
```rebaja
## Lista completa de información de referencia
1. Smith J et al., **Nombre de la revista** (2021), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Qn}*
2. Wang X et al., **Nombre de la revista** (2022), [DOI: 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=Por verificar}*
```
Formato del autor:
• 1–3 autores: Enumere todos.
• Más de 3 autores: Primer autor y otros.
El PMID / DOI / URL debe ser clicable.
6. Verificación y etiquetado de IF
6.1 Primero, expliquemos las limitaciones prácticas de las comprobaciones IF.
Normalmente, el factor de impacto oficial de una revista proviene de Clarivate Journal Citation Reports (JCR). Sin embargo, ningún agente externo suele tener una cuenta de Clarivate/JCR ni una tabla JCR local, por lo que no se recomienda verificarlo por este medio.
```
6.2 Métodos prácticos para utilizar la habilidad IF
Ruta principal:
1. Si la entrada es PMID, primero utilice las utilidades electrónicas de NCBI para obtener los metadatos de PubMed.
- Recuperar el nombre completo de la revista. - Recuperar la fuente/abreviatura ISO. - Recuperar el ISSN/eISSN. - Recuperar campos auxiliares como título, año y DOI.
2. Utilice la interfaz JSON móvil iikx/iscience, disponible públicamente, para consultar revistas científicas.
API de búsqueda:
```text
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=
```
Detalles de la API:
```text
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=
```
3. Realice una coincidencia conservadora en los resultados de la búsqueda.
- Prioriza las coincidencias exactas de títulos de revistas normalizados. - En segundo lugar, prioriza las coincidencias exactas de abreviaturas. - Ejerce gran precaución con términos cortos y generales. - No acepta discrepancias obvias en las subcadenas, como confundir "Nature" con la serie "Nature Reviews". - Devuelve resultados ambiguos o no encontrados si la coincidencia es inestable, en lugar de adivinar.
4. Si PubMed proporciona una abreviatura, intente ampliarla al nombre completo o título alternativo utilizando el Catálogo de la NLM.
La interfaz de búsqueda del catálogo de la NLM sigue siendo NCBI E-utilities:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=[Título abreviado]&retmode=xml&retmax=1
```
Luego, utilice ESummary para obtener el título / título alternativo.
5. Lea los resultados detallados de iikx:
- Factor de impacto. - Año del IF. - Cuartil JCR. - Cuartil CAS/CAS, si corresponde. - URL de origen. - Confianza de coincidencia.
6. No incluya el año del IF en el texto principal al hacer anotaciones; utilice anotaciones concisas.
La anotación final solo debe indicar:
```text
*{SI=X,Qn}*
```
Si falla:
```text
*{SI=Verificación pendiente}*
```
o:
```text
*{SI=No detectado}*
```
6.3 Pasos específicos
Realice el siguiente procedimiento para cada documento.
Paso 1: Prepare el nombre de búsqueda de la revista.
Priorizar la recuperación de metadatos de PubMed:
```text
Nombre completo de la revista
Abreviatura ISO / Fuente
ISSN
eISSN
```
Si solo se dispone del DOI, primero utilice Crossref u OpenAlex para obtener el nombre de la revista.
Referencia cruzada:
```text
https://api.crossref.org/works/
```
OpenAlex:
```text
https://api.openalex.org/works/https://doi.org/
```
Paso 2: Estandarizar los nombres de las revistas.
Reglas de estandarización:
• Todo en minúsculas.
• Descodificación de HTML.
• Reemplazar & por and.
• Eliminar la puntuación.
• Combinar varios espacios.
• Al realizar comparaciones, también puede utilizar el formato compacto, que elimina todos los espacios.
Pseudocódigo de ejemplo:
Pitón
importar re, html
norma(s) definitoria(s):
s = html.unescape(s o '').lower()
s = re.sub(r'&', ' y ', s)
s = re.sub(r'[^a-z0-9]+', ' ', s)
return re.sub(r'\s+', ' ', s).strip()
definición compacta(s):
devolver norma(s).reemplazar(' ', '')
```
Paso 3: Consultar la interfaz de búsqueda de iikx.
```text
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=
```
Se recomienda configurar un User-Agent, por ejemplo:
```text
Mozilla/5.0
```
Si no se encuentra una coincidencia exacta en la primera página, puede hojear un número limitado de páginas, por ejemplo, hasta 8 páginas.
Los parámetros para pasar de página suelen ser:
```text
página=2
página=3
```
Paso 4: Seleccionar candidatos de los resultados de la búsqueda.
Los campos para candidatos suelen incluir:
```text
identificación
ID de clase
título
título pequeño
SI o SI2024
zky2020
URL
```
Reglas de coincidencia:
• Si compact(query) == compact(candidate.title), aceptar.
• Si norm(query) == norm(candidate.title), aceptar.
• Si compact(query) == compact(candidate.smalltitle), aceptar.
• Si norm(query) == norm(candidate.smalltitle), aceptar.
• No acepte una subcadena a menos que la consulta sea lo suficientemente larga y no ambigua.
• Tenga especial cuidado con las palabras cortas como Naturaleza, Ciencia, Célula, Cerebro, Visión y Retina.
Paso 5: Si no se encuentra ninguna coincidencia, utilice la abreviatura extendida del catálogo de la NLM.
Por ejemplo, en PubMed, la fuente es:
```text
Biomedicina de Radic Libre
```
Puedes comprobarlo:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=Free%20Radic%20Biol%20Med%5BTitle%20Abbreviation%5D&retmode=xml&retmax=1
```
Una vez obtenido el ID del catálogo de la NLM, utilícelo de la siguiente manera:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi?db=nlmcatalog&id=
```
Leer:
```text
Título
Título alternativo
```
Luego, utilice estos nombres completos para buscar iikx.
Paso 6: Compruebe la interfaz de detalles de iikx.
Si los resultados de la búsqueda contienen:
```text
id=
classid=
```
Llamar:
```text
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=
```
Lea el detalle:
```text
IF2024, IF2023, IF2022 ...
SI
zky2020 u otros campos de cuartiles JCR
jcr22 / jcr12 o campo de partición
issn
eissn
título
título pequeño
categoría
```
Paso 7: Seleccione la última instrucción IF.
Buscar en los campos devueltos todas las instancias del formulario:
```text
IF20xx
```
Por ejemplo:
```text
IF2024
IF2023
IF2022
```
Elige el año con la mayor cantidad de dígitos significativos.
Si IF20xx no está presente, intente leer:
```text
SI
si_valor
```
Si no se encuentra ningún valor válido, se marca como no detectado.
Paso 8: Generar el nivel de confianza y la etiqueta.
Si el título/abreviatura coincide exactamente y el detalle devuelve un IF válido:
```text
*{SI=X,Qn}*
```
Si la coincidencia es incierta:
```text
*{SI=Verificación pendiente}*
```
Si la API pública no devuelve resultados:
```text
*{SI=No detectado}*
```
6.4 Formato de anotación IF
Formato fijo:
```text
*{SI=X,Qn}*
```
Ejemplo:
```rebaja
Smith J et al., **Neurona** (2020), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{FI=15.0, Q1}*
```
Aviso:
• El año del JCR no está escrito dentro de la anotación IF.
• No escriba "2024 JCR IF".
• No escriba "JCR 2024".
• Solo se conserva el año de publicación.
• Si la condición IF es 0.0, nula, tiene una fuente inestable o una coincidencia inestable, el número no se mostrará.
6.5 Manejo estándar para fallas en la verificación IF
No adivines.
No utilice el nombre de la revista para rellenar los números.
No utilice modelos grandes para memorizar y completar sentencias IF.
En caso de fallo, solo se permiten tres estados:
```text
*{SI=Verificación pendiente}*
```
Se utiliza para:
• Los resultados de la búsqueda son vagos.
Existen varias revistas similares.
• Solo se encontró la abreviatura, pero no se pudo confirmar el nombre completo.
• El IF devuelto por fuentes disponibles públicamente es cuestionable.
```text
*{SI=No detectado}*
```
Se utiliza para:
• La interfaz pública no devolvió ningún resultado.
• La revista no está indexada en SCI/JCR.
• El nuevo problema aún no tiene un IF.
```text
*{SI=No verificable públicamente}*
```
Se utiliza para:
• El usuario necesita un JCR oficial, pero el agente actual no tiene permisos de Clarivate/JCR.
7. Lista de verificación final
Debe revisarse antes del envío:
• ¿Deberían responderse primero las preguntas principales del usuario?
• Si se debe distinguir entre evidencia directa, evidencia indirecta y ausencia de evidencia directa.
• ¿Se puede hacer clic en todas las citas de texto?
• ¿Hay una lista completa de referencias al final del artículo?
• ¿Cada documento incluye una etiqueta IF (Entrada/Salida) o una etiqueta que indique verificación pendiente/no detectado?
• Si el PMID/DOI/URL es clicable.
• ¿Evita sustituir los resultados generales del tejido por conclusiones sobre tipos celulares específicos?
• ¿Evita sustituir la activación/fosforilación por un aumento en la expresión total?
• Indicar si se trata de una preimpresión.
• ¿Especifica los límites de búsqueda?
• SI no se basó en la memoria o en conjeturas.
8. Pseudocódigo reproducible
Pitón
consultas = construir_consultas(pregunta_del_usuario)
todos_pmids = []
para consulta en consultas:
pmids = ncbi_esearch(query, retmax=20, sort='relevance')
todos_pmids.extender(pmids)
pmids = eliminar_mantener_orden(todos_los_pmids)
metadatos = ncbi_esummary(pmids)
resúmenes = ncbi_efetch_abstract(pmids)
registros = fusionar_metadatos_y_resúmenes(metadatos, resúmenes)
registros = tag_evidence(registros, pregunta_usuario)
registros = clasificación_registros(registros)
seleccionados = seleccionar_mejores_registros(registros)
si se necesita_texto_completo:
para cada registro en registros_clave_seleccionados:
pmcid = idconv_pmid_to_pmcid(record.pmid)
si pmcid:
registro.fulltext = fetch_bioc_or_pmc_xml(pmcid)
Para registro en seleccionado:
consulta_revista = registro.nombre_revista_completo o registro.abreviatura_revista
if_result = lookup_if_public_iikx(journal_query)
if_result.confident:
registro.if_annotation = f'*{SI={if_result.if_value},{if_result.quartile}}*'
elif if_result.ambiguous:
registro.if_annotation = '*{IF=Pending Verification}*'
demás:
registro.if_annotation = '*{IF=No detectado}*'
respuesta = componer_respuesta(
conclusión
grupos de evidencia,
citas_en_cuerpo_clicables,
lista_de_referencia_completa_con_si
)
```
9. Plantilla de entrega final recomendada
```rebaja
en conclusión:
...
Nivel de evidencia:
Pruebas directas:
- ……[[1. **Revista**, Año]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
Evidencia indirecta:
- …[[2. **Revista**, Año]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
No se encontraron pruebas directas:
- ……
Resumen del mecanismo:
1. ……
2. ……
Límites de búsqueda:
Esta ronda de búsquedas se centró principalmente en PubMed, PMC, BioC y bioRxiv; la selección inicial se basó en metadatos y resúmenes, y solo los documentos clave se sometieron a verificación de texto completo. Las anotaciones de IF se basaron en fuentes de acceso público; los documentos que no pudieron coincidir con un alto grado de confianza se marcaron como pendientes de verificación o no detectados.
Lista completa de información bibliográfica:
1. Smith J et al., **Nombre de la revista** (2021), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Q1}*
2. Wang X et al., **Nombre de la revista** (2022), [DOI: 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=Por verificar}*
```
Habilidades relacionadas
Ver todo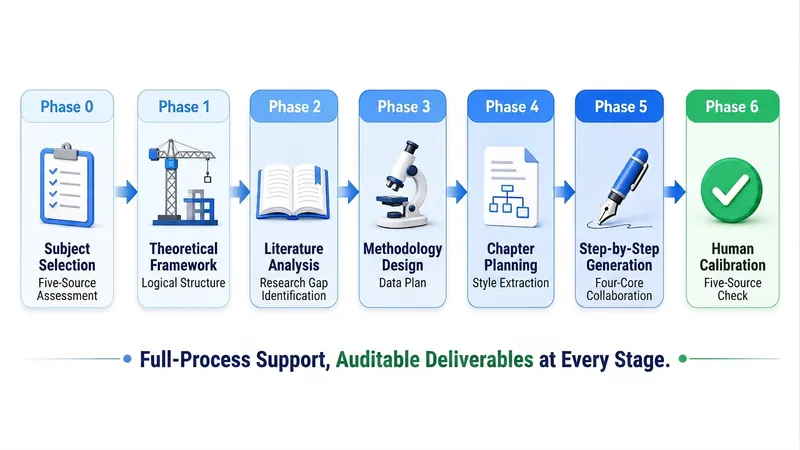
Chequeo de propuesta de tesis
Antes de invertir decenas de horas en escribir tu tesis, dedica diez minutos a hacer una revisión estructurada. 【Este Skill solo hace una cosa】 Diagnóstico, no redacción. Te dice: si el tema puede sostenerse, si hay suficiente material, qué falta, dónde conseguirlo, en qué orden, y luego te entrega una lista de materiales accionable y una estrategia de búsqueda. No escribirá tu introducción, revisión de literatura, métodos ni discusión. 【Cuatro etapas】 1. Diagnóstico de disciplina: clasifica en 1A Artes y Humanidades / 1B Ciencias Sociales / 2A Ingeniería y Ciencias / 2B Agricultura, Medicina y Ciencias de la Vida, y carga las líneas rojas normativas correspondientes; para 2B se bloquea la revisión ética obligatoriamente. 2. Revisión del tema: examina el tema desde las tres dimensiones «impulso, forma y palabras» para determinar si la unidad de investigación puede operacionalizarse, si la pregunta de investigación puede responderse y si el tema está sobreexplotado. 3. Revisión de materiales: registra tus referencias como una base de materiales M1/M2…, verifica cada una con los cuatro elementos (autor/año/título/localizador verificable) y calcula la cobertura real. 4. Lista de carencias y estrategia de búsqueda: especifica cuántos y qué tipos de referencias faltan, qué eslabón de evidencia falta, y proporciona una estrategia de búsqueda directamente pegable en la base de datos (incluyendo combinación booleana de palabras clave, rango de tiempo y criterios de filtrado). 【Cuándo usarlo】(palabras de activación) «Ayúdame a revisar mi propuesta», «¿Se puede hacer este tema?», «¿Tengo suficientes referencias?», «Mi propuesta fue rechazada», «Quiero confirmarlo antes de empezar a escribir»: estudiantes de posgrado que acaban de definir su dirección y aún no han escrito; aquellos cuya propuesta fue rechazada pero no saben cuál es el problema; los que tienen un montón de referencias pero no están seguros de si son suficientes para empezar; los que quieren confirmar si vale la pena el tema antes de invertir formalmente. 【Entregables】 Un documento de «Informe de revisión de propuesta» + una tarjeta de puntuación de preparación de cinco fuentes (cada nivel tiene criterios de comportamiento claros, no puntuaciones vagas) + una lista de prioridad de materiales + la estrategia de búsqueda + un código de archivo. El código de archivo es compatible con el «Sistema de escritura de tesis académica v4.0», así que después de la revisión puedes pegarlo directamente para continuar sin volver a explicar disciplina, tema o revista. 【Lo que no hace】 No escribe el texto, no genera una lista de referencias, no inventa autores, años, volúmenes, números, páginas o DOI. Cualquier referencia encontrada en línea se marca con ⚠️ pendiente de verificación, y debes verificarla tú mismo antes de usarla. Este Skill no promete ningún resultado de aceptación o aprobación.
 Investigación
Selección de tema e intro v3.2
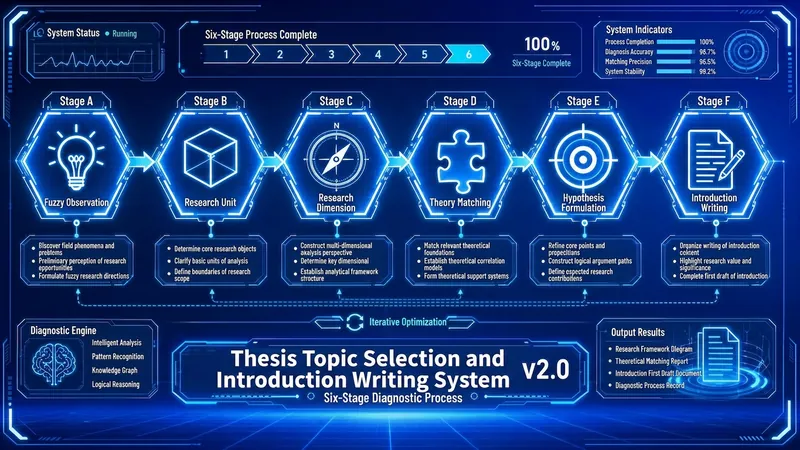
En 10 segundos: conviertes una observación vaga en un tema sólido y luego en una introducción que supera la revisión. En todo el proceso solo se usan los materiales reales que aportas; no se inventa ni un solo documento. Palabras de activación: selección de tema de tesis, tema, introducción, vacío de investigación, escritura académica, propuesta de tesis de grado, selección de tema antes de la revisión bibliográfica. Aplicable a: artículos de revista / tesis de grado / ponencias de congreso / trabajos de curso, en todas las disciplinas: humanidades, ciencias sociales, ingeniería, agricultura, medicina y ciencias de la vida. En 3 minutos puedes empezar: primero fija la disciplina y el punto de partida → define el tema por capas → control de la cadena de evidencia → introducción por módulos → versión final con mecanismo de trinquete. 【División del trabajo con otras skills】El diagnóstico va primero, la redacción después y el pulido al final. Esta skill se encarga de la parte intermedia: la definición del tema + el borrador de la introducción. No redacta el cuerpo completo del texto (eso es «Sistema integral de redacción de artículos académicos v4.x»), ni pule el lenguaje frase por frase (eso es «Sistema de pulido de tres vías v8.x»). 【Seis controles】1. Clasificación disciplinar: se ubica la tarea en una de las cuatro categorías —1A Humanidades y Artes / 1B Ciencias Sociales / 2A Ingeniería y Ciencias / 2B Agricultura, Medicina y Ciencias de la Vida— y se cargan las normas de obligado cumplimiento correspondientes; en la categoría 2B se exige verificar el estado de aprobación ética. 2. Ubicación de la etapa: ¿estás en una observación vaga, tienes una unidad pero te falta el ángulo, tienes un objeto pero te falta la teoría, te falta el método, te falta el enfoque, o solo te falta la introducción? Se parte desde el control correspondiente, sin volver a empezar desde cero. 3. Definición del tema: unidad de investigación → brújula de dimensiones → perspectiva teórica → método de investigación → enfoque de investigación, fijando cada capa en orden; antes de fijar cada capa se comprueba que la anterior se sostiene. 4. Control de la cadena de evidencia: antes de la introducción, se registran obligatoriamente tus referencias como biblioteca de materiales M1/M2…, verificando una a una los cuatro elementos: autor/año/título/localizador. Si hay menos de 3 fuentes registradas, el sistema se niega a generar el enunciado del vacío de investigación —no es una degradación, es una negativa. 5. Generación por módulos: la introducción se produce en cinco módulos de pirámide invertida; cada módulo debe llevar el número de cita [Mn]; sin fuente, no hay frase. 6. Versión final con mecanismo de trinquete: solo se construye sobre versiones ya aprobadas; los módulos que cumplen el estándar quedan bloqueados y no se modifican; la puntuación solo sube, nunca baja. 【Entregables】Documento «[Palabras clave del tema]·Tema e introducción» + tabla de trazabilidad de citas frase por frase + lista ⚠️ pendiente de verificación + un código de archivo AFP. El código de archivo es compatible con el comprobador de propuesta de tema, el flujo completo v4.x y el sistema de pulido de tres vías; al cambiar de skill no hace falta volver a explicar la disciplina, el tema, la revista ni la biblioteca de materiales. 【Lo que no hace】No inventa autores, años, volúmenes, números, páginas ni DOIs; cualquier registro obtenido mediante búsqueda en línea se marca ⚠️ pendiente de verificación y solo puede incorporarse a la lista de referencias después de que tú lo verifiques; no promete ningún resultado de aceptación ni de aprobación. La autoría y la responsabilidad son tuyas: verifica una por una las citas y los datos.
Editor de Propuestas PRO V2.0
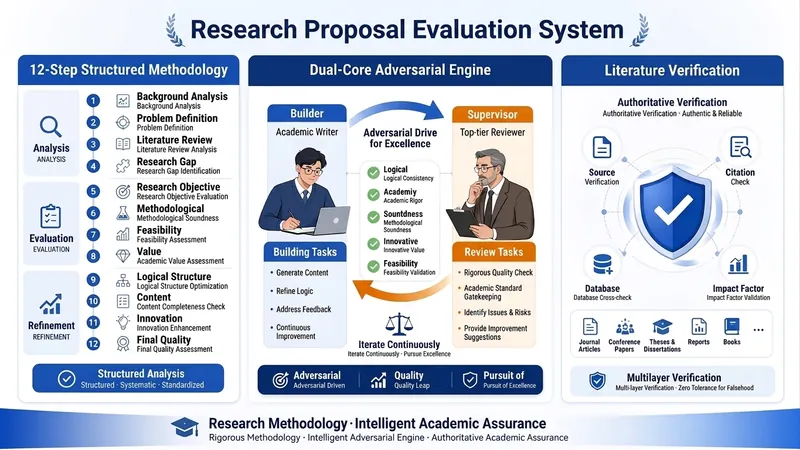
🎯 Resumen de funciones principales Este es un sistema inteligente de revisión y optimización diseñado específicamente para solicitudes de proyectos nacionales de ciencias sociales, del Ministerio de Educación y provinciales. Simula el pensamiento de un evaluador experto con 15 años de experiencia, garantizando el rigor académico y la competitividad de la propuesta mediante tres mecanismos centrales. 🔧 Tres mecanismos centrales 1️⃣ Metodología estructurada de 12 pasos Cubre todo el ciclo de vida de la revisión de la propuesta: Fase 1-3: Diagnóstico básico - Análisis profundo de la convocatoria (orientación de financiamiento, criterios de evaluación, requisitos de solicitud) - Identificación del tipo interdisciplinario (identificación precisa de 8 tipos) - Identificación de brechas de investigación en cinco dimensiones (teórica/metodológica/empírica/de políticas/técnica) Fase 4-7: Evaluación de elementos centrales - Análisis del modelo TMAQ del problema de investigación (cuatro dimensiones: teoría, método, enfoque, problema) - Verificación de los objetivos de investigación según los principios SMART - Evaluación de la integridad del marco del contenido de investigación - Coincidencia del tipo de enfoque de investigación (6 tipos) Fase 8-10: Mejora profunda de calidad - Refinamiento preciso de puntos clave y difíciles (criterios de distinción + rutas de avance) - Exploración de puntos innovadores en 7 dimensiones - Argumentación de viabilidad en 7 dimensiones Fase 11-12: Optimización integral - Control de calidad en 9 dimensiones (rigor académico, innovación, viabilidad, etc.) - Recomendaciones de optimización integral e informe final 2️⃣ Mecanismo de confrontación de doble núcleo (Builder vs Supervisor) Principio de funcionamiento: - Builder (redactor académico): genera planes de optimización basados en el material del usuario - Supervisor (revisor de revistas de alto impacto): desafía el plan del Builder con los estándares más exigentes - Iteración de confrontación: asegura que el plan sea sólido mediante 3 rondas de confrontación Escenarios de aplicación: - Exploración de puntos innovadores: Builder propone un punto innovador → Supervisor cuestiona su novedad → iteración y optimización - Argumentación de viabilidad: Builder diseña el plan → Supervisor desafía su viabilidad → argumentación complementaria - Citas de literatura: Builder cita literatura → Supervisor verifica la autenticidad → asegura las normas académicas 3️⃣ Mecanismo de verificación de autenticidad de la literatura Dos modos de trabajo: Modo A: Modo de marcador (predeterminado) - Usa marcadores como [marcador-literatura-001] en lugar de referencias específicas - Genera una "Lista de necesidades de literatura", especificando los requisitos de búsqueda para cada marcador - El usuario busca e introduce la literatura real después Modo B: Modo de verificación en tiempo real - Llama a Google Scholar para verificar la autenticidad de la literatura en tiempo real - Genera un "Informe de verificación de literatura" (puntuación de autenticidad, relevancia y autoridad) - Asegura que cada cita sea rastreable Prevención de alucinaciones de IA: - Prohíbe la invención de autores, revistas, DOI - Toda la literatura debe ser verificada o marcada como marcador - Garantiza la línea base de integridad académica 💡 Valor central y escenarios de aplicación ✅ Dolores centrales resueltos 1. Falta de rigor académico: el contenido generado por IA a menudo contiene literatura falsa y lagunas lógicas 2. Innovación insuficiente: difícil de encontrar verdaderos puntos innovadores académicos 3. Viabilidad débil: el plan de investigación carece de argumentación sistemática 4. Dificultad interdisciplinaria: los temas interdisciplinarios a menudo no encajan bien en ningún lado 🎓 Usuarios adecuados - Profesores universitarios (ciencias sociales, educación, humanidades) - Investigadores (que solicitan proyectos nacionales, provinciales/ministeriales) - Equipos académicos (que necesitan un proceso de revisión sistemático) 📋 Flujo de uso típico 1. Entrada: cargar la convocatoria del proyecto + el borrador de la solicitud 2. Revisión: el sistema realiza un análisis estructurado en 12 pasos 3. Confrontación: el mecanismo de doble núcleo itera y optimiza las partes clave 4. Verificación: verificación de autenticidad de la literatura 5. Salida: informe de revisión completo + recomendaciones de optimización + lista de literatura 🔍 Diferencias con la revisión tradicional | Dimensión | Revisión manual tradicional | Sistema de revisión experto | |-----------|-----------------------------|-----------------------------| | Profundidad de revisión | Depende de la experiencia personal | 12 pasos estructurados + control de calidad 9 dimensiones | | Rigor académico | Difícil de verificar completamente | Verificación de literatura + confrontación de doble núcleo | | Exploración de innovación | Juicio subjetivo | Análisis sistemático en 7 dimensiones | | Argumentación de viabilidad | Impulsado por experiencia | Argumentación punto por punto en 7 dimensiones | | Consistencia | Varía de persona a persona | Proceso estandarizado | | Eficiencia | De días a semanas | 1-2 horas para evaluación inicial | La ventaja central de este sistema es: hacer explícito, estructurado y reproducible el conocimiento tácito de un evaluador experto con 15 años de experiencia, permitiendo que cada usuario obtenga un servicio de revisión de nivel experto de primera clase.
Información
- Última actualización
- Créditos por ejecución
- Según el uso
- Modelos
- Claude Sonnet 4.5
- Funciones
- Investigación web