Cerebras Wafer Scale Engine と GPU を組み合わせ、超高速トークンを大規模に提供します
世界は超高速トークンを渇望しています。2026 年、Cerebras は自社推論クラウドおよびパートナー経由の双方で、高速推論に対する飽くなき需要を目の当たりにしました。この需要に応えるため、私たちは分散型推論(disaggregated inference)の開発に着手しました。GPU がプロンプト処理(prefill)を担い、Cerebras システムが出力生成(decode)を担うという構成です。
本ソリューションはすでに本番環境で稼働しており、Cerebras ならではの超高速スピードを維持したまま、1 メガワットあたりのトークン生成量を 5 倍に引き上げています。
これにより、市場の需要に応えるため、Cerebras Inference Cloud を通じてより多くの超高速トークンを提供できるようになりました。また、インフラパートナーも Cerebras の分散型ソリューションを活用し、自社のデータセンター内でより多くの超高速トークンを生成できます。
先日発表した CS-4、大幅にスケールアップした製造体制、そして計画中の 700MW のデータセンター容量と合わせ、分散型推論によって Cerebras とそのパートナーは 2027 年以降、さらに多くの超高速トークンを提供できるようになります。本ブログでは以下の内容を取り上げます。
- 超高速推論キャパシティ拡大の必要性
- デコードにおいて Cerebras が優位な理由
- Cerebras 分散型推論の本番環境での成果
- インフラパートナー向け Cerebras 分散型推論
高速推論キャパシティ拡大の必要性
Muse、Copilot、Codex といったエージェント型アプリケーションは急速に普及しており、ユーザーの関心を引きつけ続けるには高度にインタラクティブな推論が求められます。電力制約のある環境でこれらのアプリケーションの増大する需要に応えるには、業界全体として、アプリケーションを実用的なものにする応答速度を維持しつつ、1 メガワットあたりの推論キャパシティを大幅に向上させる必要があります。

出典:Goldman Sachs Research「AI Agents Forecast to Boost Tech Cash Flow as Usage Soars」2026 年 5 月 20 日、Investing.com が報じた Goldman Sachs のデータセンター容量推計
だからこそ、Cerebras は分散化(disaggregation)に投資してきました。プロンプト処理用の prefill アクセラレータと、応答生成用の Cerebras System を組み合わせることで、Cerebras の超高速生成スピードを維持しながら、1 メガワットあたりのトークンスループットを高められます。推論プロバイダーにとっては、同じ電力予算でより多くの顧客にサービスを提供できるキャパシティと、より大きな収益ポテンシャルを得られることを意味します。
デコードにおいて Cerebras が優位な理由
推論リクエストには主に 2 つのステージがあります。prefill と呼ばれるプロンプト処理では入力データを処理し、中間モデル状態を生成します。decode と呼ばれる応答生成では、その状態を用いて出力トークンを生成します。推論ワークロードの分割方法には draft-target や attention-FFN などさまざまな手法がありますが、高度にインタラクティブな推論を目指す場合、prefill と decode を分離するアプローチが特に有利です。

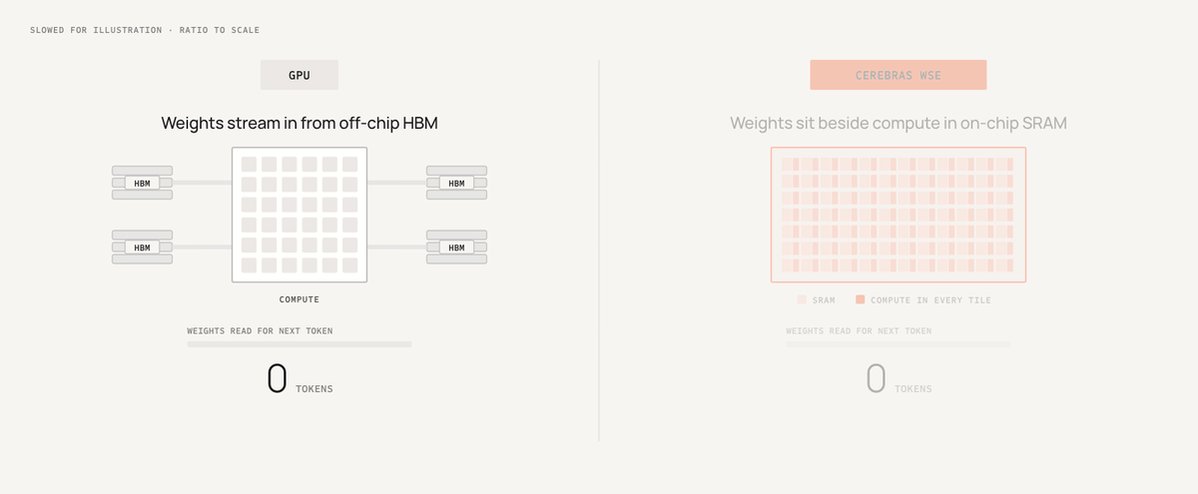
デコードは自己回帰的です。つまり、モデルは一度に 1 トークンずつ生成し、生成した各トークンを次のトークン生成の入力として使用します。ステップごとにメモリからモデルデータを再度読み込む必要があるため、メモリ帯域幅が非常に重要になります。超高速推論の領域では、SRAM 中心のチップが有利です。データをオンチップに保持し、はるかに高速に読み込めるからです。Cerebras はこれをウェハースケールで実現しており、単一チップ上に数十ギガバイトの SRAM と毎秒数ペタバイトのメモリ帯域幅を搭載しています。これは一般的な GB300 GPU と比較して、SRAM 容量で 350 倍、メモリ帯域幅で 5,400 倍に相当します。これにより、Cerebras システムはより多くの同時リクエストとモデルレイヤーをチップ上に直接収められ、CS-3、CS-4、CS-5 は魅力的なスループットで超高速スピードを実現しています。
GIF
Cerebras 分散型推論の本番環境での成果
超高速デコードに最適化された Cerebras システムと、AMD Instinct GPU のような prefill の計算要件に適したアクセラレータを組み合わせることで、膨大な量の超高速推論を大規模に提供できます。Cerebras Inference Cloud での本番環境デプロイメントでは、AMD Instinct GPU がプロンプトを処理し、Cerebras CS-3 システムが応答を生成します。プロンプト処理を GPU に移すことで、Cerebras システムはそのサービング能力をすべて応答生成に集中させられます。実測した本番環境デプロイメントでは、この組み合わせにより CS-3 のみの構成と比較して 1 メガワットあたり 5 倍のスループットを実現し、トークン生成速度の低下は一切ありませんでした。

出典:Cerebras Inference Cloud 経由で提供された GPT-OSS-120B エンドポイント(11 月 14 日共有)における、分散型推論の有効化前後の 1 メガワットあたりスループット。集約型推論ベースライン(1×)で正規化済み。
2027 年末までに、Cerebras Inference Cloud およびパートナーのデプロイメントにおいて、数百メガワット規模で分散型推論を広範に展開する計画です。私たちの目標は、顧客が利用できる超高速推論キャパシティを増やすことです。
インフラパートナー向け Cerebras 分散型推論
Cerebras の分散型推論ソリューションは、パートナー企業にも採用いただけるよう設計されています。インフラパートナーは、Cerebras が提供するリファレンスアーキテクチャに基づいて分散型推論クラスターを構築でき、選択した prefill アクセラレータと Cerebras システムを統一ネットワーク内に配置できます。ソフトウェア統合については、Cerebras のエンドツーエンド分散型ソフトウェアスタック、またはデコード専用 SDK のいずれかと連携できます。
- エンドツーエンド分散型ソフトウェアスタックは、市場投入までの時間を短縮したいパートナーに最適です。以下の要素で構成されます。
- prefill プールと decode プール間でリクエストをルーティングし、レプリカのキャパシティと正常性を管理する分散型推論フレームワーク。
- vLLM や SGLang などのオープンソース推論エンジンを使用してプロンプトを処理する prefill エンジン。
- Cerebras システム上で応答生成を行う Cerebras デコードエンジン。
- RDMA 経由でキーバリューキャッシュを含む中間モデル状態を prefill エンジンとデコードエンジン間で転送するインターフェースである KV Portal ソフトウェア。
デコード専用 SDK は、制御性を重視するパートナーに最適です。デコード専用 SDK を使用することで、パートナーは独自の推論フレームワークと prefill エンジンを Cerebras デコードエンジンおよび KV Portal ソフトウェアに持ち込むことができます。さらに、モックの Cerebras デコードレプリカや、オープンソースの分散型推論フレームワークおよび prefill エンジンとのリファレンス統合など、開発支援機能も提供します。

Amazon Web Services、Fireworks AI、Gimlet Labs、General Compute などの早期アクセスパートナーは、すでに自社のデプロイメント向けに Cerebras 分散型ソリューションを利用可能です。現在、超高速推論を自社顧客へ大規模に提供しようとしている追加パートナーへと、アクセス範囲を拡大しています。
成果、ソリューション、導入機会について詳しくご相談されたい場合は、こちらからお問い合わせください。


