AI動画絵コンテ表
文案を1カットずつ生成用指示に変換
AI動画絵コンテ表
文案を1カットずつ生成用指示に変換
コンテンツ紹介
説明
AI動画でよく起きる失敗は、大きく2つあります。1つ目は、モデルに意図をうまく伝えられないことです(「活気あふれる人物が新しい一日を迎える」と書いても、モデルは実行しにくい)。2つ目は、1カット目と2カット目で人物が別人のようになることです。【AI動画絵コンテ表】は文案を、ショットごとにコピー&ペーストして生成できる表に分解します。各ショットには、主体(誰が何をしているか、目で確認できる動作)、環境(前景と背景に何があるか)、光(方向、硬さ、色温度)、カメラ(画角・カメラ位置の高さ・動き方)、スタイル文(素材感と色調)の5項目を詳しく記載します。特に重要なのが「一貫性を保つ3つの方法」です。主人公の描写を固定テキストブロックにして、動作だけを変えながら毎回そのまま複製すること。各ショットで同じ光と場面の説明を繰り返すこと。そして、まずファーストフレーム画像で基準を定め、その画像を使って動画ツールを動かすことです。これはテキストプロンプトを何度も修正するより効果的です。さらに、尺の配分とトランジションの提案、失敗しやすい6つのポイント(複数人を同じ画面に入れたときの顔崩れ、速い動きによる変形、画面内の文字化け、手元のクローズアップの描き間違い、反射素材のぼやけ、ショットをまたいだ服の色変化)と、その回避方法も提示します。厳守するルール:動画は生成しない、実在人物の肖像や顔交換を使わない、既存の漫画・アニメ・ゲーム・映画のキャラクターを登場させない、存命の監督やアーティストを名指しで模倣しない、未成年者の姿や露出のある内容を生成しない、生成映像を実写ニュースとして公開する方法を教えない。
こんな方におすすめ
文案をAI動画の絵コンテとショットごとの生成プロンプトに整理したいコンテンツ制作者、マーケター、動画制作者向けです。
この Skill の使い方
入力を用意する
口播稿、商品紹介、ストーリーなどを用意し、用途、完成尺、画面比率、全体の雰囲気、統一したい人物や場面、使用ツールを伝えてください。
Skill を実行する
文案をショットごとの絵コンテ表に分解し、見える動作、環境、光、画角、カメラ位置、動き、スタイルを明確にして、人物や場面の描写を統一します。
結果を確認する
AI動画ツールにコピーできるショットごとのプロンプト、ファーストフレームの説明、尺の配分、トランジション案、よくある映像トラブルの回避策を受け取れます。
関連スキル
すべて表示
AI動画・絵コンテプロンプト生成
あらすじ、キャラクター設定、既存の動画プロンプトを、AI動画生成に適した本格的な短編ドラマの絵コンテと、そのまま使えるショット用プロンプトに変換します。現代劇、時代劇、ミステリー、恋愛、爽快系のシーンなど、人物関係、物語のテンポ、感情のフックを軸に、ショットサイズ、カメラ位置、視点、カメラワーク、構図、光と影、環境音、セリフを明確化。各ショットに、視覚的な焦点と実行可能なアクションを持たせます。 キャラクターの一貫性とシーンの連続性にも重点を置き、人物の外見、衣装の整合性、身分や状態、特徴的なディテールを固定することで、顔の変化、外見のぶれ、空間の混乱、曖昧な動作などの生成リスクを抑えます。キャラクターの視線、表情、呼吸、手元、身体の反応も目に見える演技の変化として落とし込み、短編ドラマの対立、緊迫感、どんでん返し、感情の高まりを強化します。 完成したあらすじから始めることも、既存のキャラクター素材、絵コンテ、プロンプトを指定して最適化することもできます。設定済みのキャラクターがある場合はそのまま活用し、重複した設計を避けられます。最後に、完成したショットを主要なAI動画モデルで1本ずつ生成しやすい15秒以内のクリップに整理し、映像、音声、長さの情報も保持。コピーして使いやすく、後編集にも役立ちます。
 動画
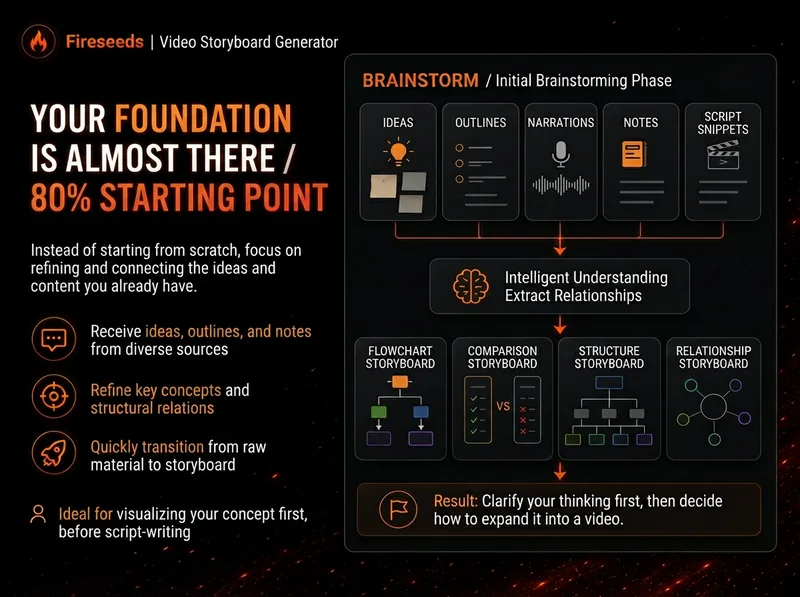
火種|動画図解ジェネレーター
多くの動画は「内容がない」のではなく、内容が抽象的で情報量が多すぎるため、視聴者が前の一文を理解した頃には、次の一文を忘れてしまいます。 「火種|動画図解ジェネレーター」は、あなたのアイデア、ブレインストーミング、概要、脚本、台本、記事を、まず本当に視覚化する価値のある概念へ分解します。そのうえで、フロー、比較、構成、階層、循環、分岐、決定木など、どの図解構造が最も適しているかを判断します。 数を埋めるために無理に図を増やしたり、複雑な内容を文字だらけの情報図に詰め込んだりすることはありません。複数の図では、同じビジュアル表現、名称、意味に基づく色を保つため、そのまま動画に挿入して説明の骨格として使えます。 特におすすめの用途: 複雑な概念の説明 業務フローの分解 2つの方法の比較 システム構成の表示 因果関係の説明 長いブレインストーミングを、動画用の視覚ノードのまとまりに整理 出力はデフォルトで16:9の静的図解です。実行環境で編集可能なExcalidrawソースファイルを提供できない場合は、その旨を明示し、静止画像を.excalidrawファイルとして偽って渡すことはありません。 活用シーン シーン1|ブレインストーミングを図解にする 口頭で話したアイデアが長くまとまっているだけで、完全な脚本がない場合に使えます。内容から最も図解する価値のあるポイントを見つけ、説明の順序に沿った図解のまとまりに整理します。 シーン2|脚本を動画用の視覚ノードにする 完全な脚本はあるものの、どこに映像を加えるべきかわからない場合に使えます。視覚化する価値のある段落を判断し、適切な図解タイプを選びます。 シーン3|複雑な概念を説明する 例:AI Agentはどのように動くのか、なぜワークフローが単発のデモより重要なのか、ビジネスモデルはどう機能するのか、プロダクトアーキテクチャにはどのような層があるのか。 シーン4|ワークフロー/プロセスを分解する 例:テーマ候補 → リサーチ → Hook → 脚本 → 制作 → 振り返り。 シーン5|比較する 例:ワークフローなし vs ワークフローあり、従来の方法 vs AIの方法、単発の成功 vs 安定して再現できる成功。
MiniMax H3動画逆解析(元Prompt付き)
完全な参考動画をマルチモーダル AI に渡すと、実際のショット、タイムライン、映像の変化、聞き取れる音声を自動で分解し、動画制作にそのまま使える実用レベルのプロンプトを生成します。人物、広告、映画素材に限らず、商品展示、建築・風景、動物、料理、スポーツの動き、ダンス、2D/3Dアニメーション、UIデモ、画面録画、インフォグラフィック、ビジュアルエフェクト、抽象映像など、さまざまな題材に対応します。 動画の情報構造に応じて、テキストから動画を生成するための完全なプロンプト、または各Shotの画像生成動画に必要な参考画像/初期フレーム用プロンプト、連続する動きの説明、必要に応じた最終フレーム用プロンプト、ショット単位の安定性に関する制約を出力できます。静止画と時間変化の両方が重要な場合は、2種類のバージョンを同時に提供することも可能です。生成内容には、主体、構図、カメラの動き、動作の因果関係、構造の変化、テキスト、セリフ、環境音、音楽など、実際に確認できる情報を保持し、各ショットを実際の終了状態まで追跡します。 明確に確認できない文字、音声、身元、場所、撮影方法については、勝手に補完しません。また、目的の映像と、プレーヤーのウォーターマークやコントロールレイヤーなどの外部要素を区別し、生成時の内容のずれを抑えます。参考動画からテキスト動画生成プロンプトやI2Vショット用プロンプトを逆解析したいクリエイターや制作チーム、動画の再構築、スタイルの再現、生成AI広告の制作に向けて素材を整理したい方に適しています。
情報
- バージョン
- v2
- 最終更新
- 実行クレジット
- 使用量に応じて消費
- モデル
- 自動選択
- 活用シーン
- 文章・コンテンツ制作動画・音声マーケティング・成長
- 得られるもの
- 文書プロンプト計画