Otimizador de Tokens
Otimizador de Tokens
Prévia
Descrição
Diagnostica o consumo de tokens da sessão atual, fornece sugestões de otimização que podem ser executadas imediatamente, ajudando o usuário a melhorar a eficiência do diálogo e a velocidade de resposta.
Recomendado por
nene@YouMind
Por que recomendamos esta habilidade
Preocupado com respostas lentas da IA e consumo rápido de tokens? Este assistente diagnostica problemas e oferece 3 a 5 sugestões prioritárias, de limpeza imediata a hábitos de longo prazo, para melhorar eficiência e economizar recursos, para diálogos mais fluidos.
Habilidades relacionadas
Ver tudo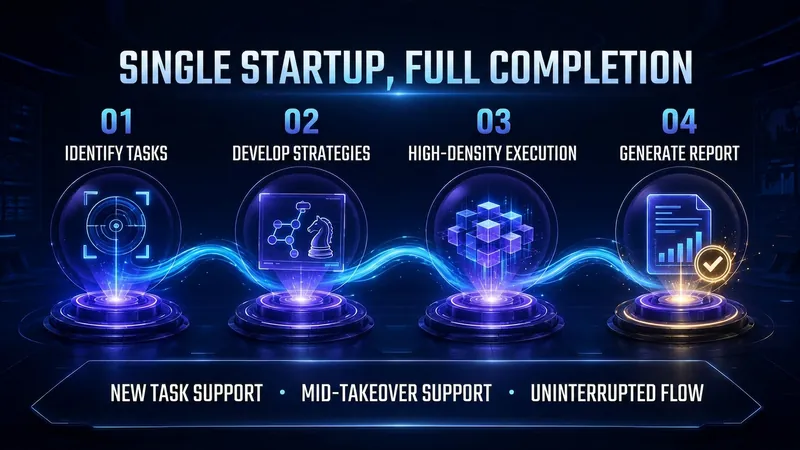
Especialista em Tokens YouMind
Você já calculou quanto paga mensalmente pelas "bobagens" da IA? "Ok, vou te ajudar…" "Primeiro, vamos revisar sua pergunta…" "Resumindo, acima está…" Você nem lê essas frases, mas cada palavra está consumindo seus Tokens. 💸 Criei um Skill chamado «Token Otimizador» para resolver isso: ✅ Identifica automaticamente o tipo de tarefa e aplica a estratégia de economia de Tokens ✅ Corta redundância sem perder profundidade, a qualidade não diminui ✅ Ao final, gera um relatório: economia de 40%+ nesta sessão, de forma clara Quem usa IA com frequência, instale uma vez e economize o equivalente a alguns cafés. Um fato pouco percebido: parte do que você paga pela IA não é pela "resposta", mas pela "linguagem de processo" — saudações iniciais, reafirmação da pergunta, transições, resumos finais. Esses conteúdos não agregam valor, mas cada Token é cobrado. Empacotei toda a metodologia de otimização de densidade informacional em um Skill: «Token Otimizador». Sua lógica é direta — identifica o tipo de tarefa e aplica automaticamente a estratégia de economia, executa com máxima densidade de informação, elimina toda expressão redundante e mantém a qualidade com restrições rígidas; ao final, gera um relatório detalhado de consumo, mostrando quanto cada etapa gastou, quanto economizou em relação ao modo padrão e como otimizar no futuro. Suporta dois modos: iniciar desde o início ou assumir no meio do processo, sem necessidade de configuração. Se você é um usuário intensivo de IA — escritor, pesquisador, criador de conteúdo em massa, usuário de API por consumo — este Skill é essencialmente uma "máquina de economizar": instale uma vez, e cada conversa reduz seus custos. Já disponível na loja de Skills do YouMind, procure por «Token Otimizador» para instalar.
Mestre de Otimização de Token
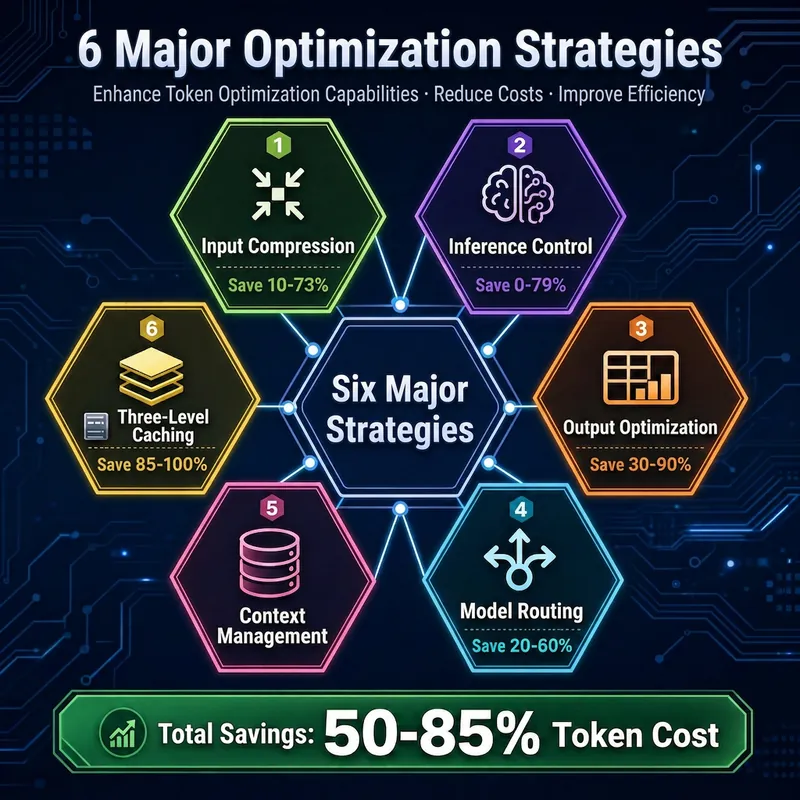
Detecção inteligente · Otimização silenciosa · Cobertura total do YouMind. Detecta automaticamente oportunidades de otimização, aplica estratégias silenciosamente, suporta três tipos de entidades: Board/Chaos/精灵. Com base no custo real do modelo do YouMind, roteamento inteligente seleciona o modelo ideal, resultando em economia de 50-85% nos custos de Token. Após a instalação, a integração com Board Memory proporciona otimização quase automática, com configuração guiada na primeira execução.
Assistente de Modelos para IA
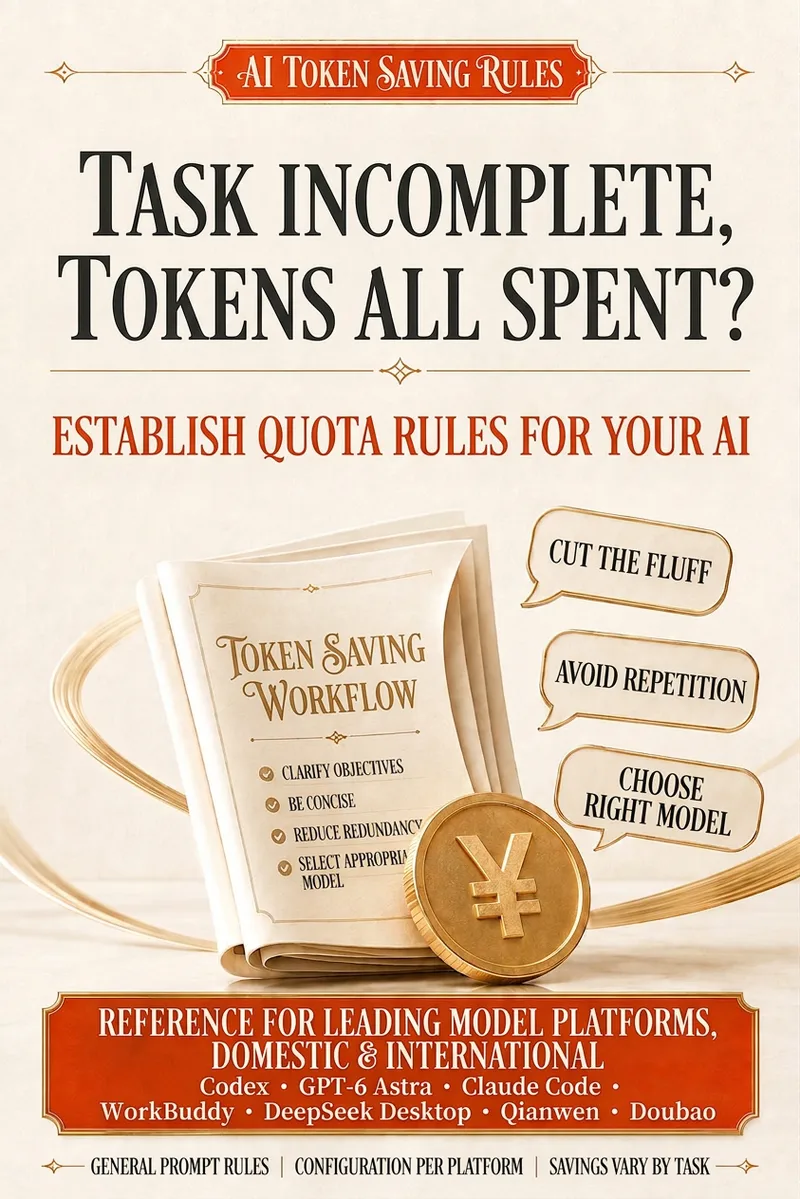
Com base na dificuldade da tarefa, no tipo de conteúdo e na etapa do projeto, ajuda você a escolher o modelo de IA mais adequado, aplicando um conjunto de regras para economizar tokens. Assim, você controla o consumo de tokens enquanto realiza tarefas de programação, criação, planejamento, design e análise de informações. Seja para componentes de página, integração com APIs, correções simples de bugs, design de arquitetura, lógica complexa, revisão ou refatoração de código, ele oferece recomendações claras de modelos e entrega diretamente o resultado necessário. Também é indicado para textos do dia a dia, títulos e ganchos, conteúdos em formato de história, propostas de marca, planos de marketing, estruturas de PPT, ideias visuais, tendências de mercado, análises de concorrentes e interpretação de dados. Para tarefas simples, em lote ou de formatação, prioriza opções que economizam mais tokens. Quando houver decisões importantes, raciocínio complexo ou necessidade de uma versão final, recomenda investir em um modelo mais adequado à qualidade exigida. Com o uso contínuo, ajusta as recomendações com base nas suas preferências de modelos, hábitos de saída, stack técnica do projeto, decisões importantes, tarefas pendentes e problemas conhecidos, reduzindo a necessidade de repetir informações. Por padrão, em tarefas de código, concentra-se nas alterações essenciais e resume o que foi modificado. Em tarefas de texto e planejamento, organiza primeiro a estrutura geral e depois detalha conforme necessário, para que cada conversa se adapte melhor ao projeto atual e ao seu ritmo de trabalho.
Informações
- Versão
- v1
- Última atualização
- Créditos por execução
- Conforme o uso
- Modelos
- Automático
