Implantamos os Cerebras Wafer Scale Engines com GPUs para entregar tokens ultrarrápidos em escala
O mundo está faminto por tokens ultrarrápidos. Em 2026, a Cerebras viu uma demanda insaciável por inferência rápida, tanto em nossa nuvem de inferência quanto por meio de nossos parceiros. Para atender a essa demanda, começamos a desenvolver a inferência desagregada: as GPUs cuidam do processamento do prompt (prefill) e os sistemas Cerebras cuidam da geração da saída (decode).
Essa solução já está em produção e entrega cinco vezes mais tokens por megawatt, mantendo as mesmas velocidades ultrarrápidas da Cerebras.
Agora podemos servir mais tokens ultrarrápidos pela Cerebras Inference Cloud para atender à demanda do mercado. Parceiros de infraestrutura também podem aproveitar a solução desagregada da Cerebras para gerar mais tokens ultrarrápidos em seus próprios data centers.
Junto com o CS-4, anunciado recentemente, nosso aumento drástico na capacidade de fabricação e os 700 MW planejados de capacidade de data center, a inferência desagregada permitirá que a Cerebras e seus parceiros entreguem muito mais tokens ultrarrápidos em 2027 e além. Neste blog, abordamos:
- A necessidade de mais capacidade de inferência ultrarrápida
- Por que a Cerebras leva vantagem no decode
- Resultados de produção da inferência desagregada da Cerebras
- Inferência desagregada da Cerebras para parceiros de infraestrutura
A necessidade de mais capacidade de inferência rápida
Aplicações agênticas como Muse, Copilot e Codex estão escalando rapidamente e exigem inferência altamente interativa para manter os usuários engajados. Para atender à demanda crescente dessas aplicações em um cenário com restrições de energia, nosso setor precisa entregar significativamente mais capacidade de inferência por megawatt, com velocidades de resposta que tornem essas aplicações realmente úteis.

Fontes: Goldman Sachs Research, “AI Agents Forecast to Boost Tech Cash Flow as Usage Soars” (“Previsão de que agentes de IA impulsionem o fluxo de caixa do setor de tecnologia com o aumento do uso”), 20 de maio de 2026; estimativas de capacidade de data center do Goldman Sachs, conforme relatado pelo Investing.com
É por isso que a Cerebras investiu na desagregação. Combinar um acelerador de prefill para o processamento de prompts com o Sistema Cerebras para a geração de respostas aumenta a taxa de transferência de tokens por megawatt, preservando as velocidades ultrarrápidas de geração da Cerebras. Para provedores de inferência, isso significa mais capacidade para atender clientes e maior potencial de receita com o mesmo orçamento de energia.
Por que a Cerebras leva vantagem no decode
Uma requisição de inferência tem duas etapas principais. O processamento do prompt, conhecido como prefill, processa a entrada e produz o estado intermediário do modelo. A geração da resposta, conhecida como decode, usa esse estado para gerar os tokens de saída. Existem várias formas de dividir a carga de trabalho de inferência, incluindo draft–target e attention–FFN, entre outras, mas separar o prefill do decode é especialmente vantajoso quando o objetivo é uma inferência altamente interativa.

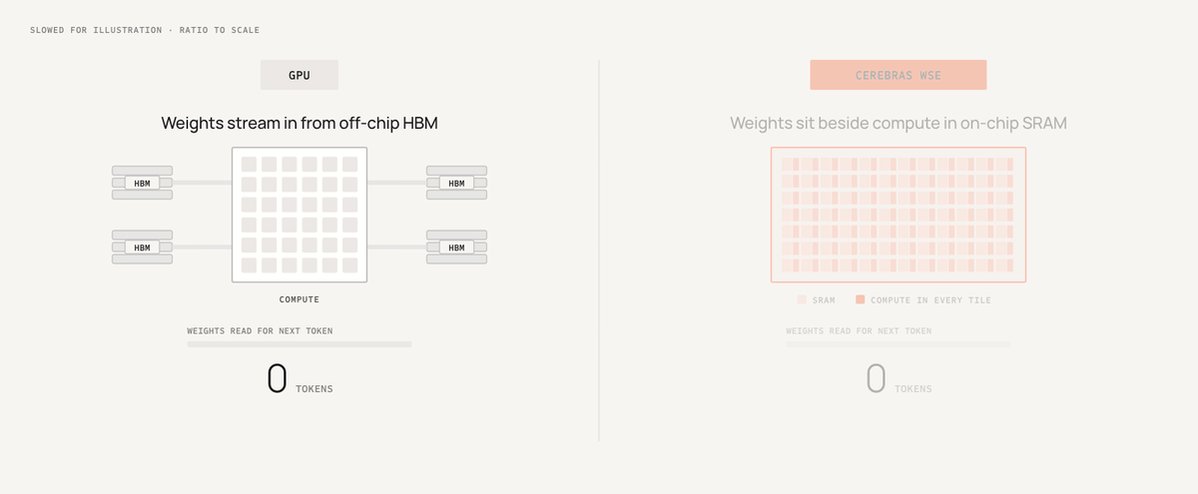
O decode é autorregressivo. Isso significa que o modelo gera um token por vez, usando cada token gerado como entrada para produzir o próximo. Cada etapa exige ler os dados do modelo da memória novamente, então a largura de banda de memória faz muita diferença. No domínio da inferência ultrarrápida, chips centrados em SRAM levam vantagem porque conseguem manter esses dados no próprio chip e lê-los muito mais rápido. A Cerebras leva isso à escala de wafer, com dezenas de gigabytes de SRAM e dezenas de petabytes por segundo de largura de banda de memória em um único chip — 350× a capacidade de SRAM e 5.400× a largura de banda de memória de uma GPU GB300 típica. Isso permite que o sistema Cerebras acomode mais requisições simultâneas e camadas de modelo diretamente no chip, possibilitando que o CS-3, o CS-4 e o CS-5 alcancem velocidades ultrarrápidas com uma taxa de transferência atrativa.
GIF
Resultados de produção da inferência desagregada da Cerebras
Combinar sistemas Cerebras, otimizados para decode ultrarrápido, com aceleradores adequados às necessidades computacionais do prefill, como as GPUs AMD Instinct, permite entregar uma quantidade imensa de inferência ultrarrápida em escala. Em uma implantação em produção na Cerebras Inference Cloud, as GPUs AMD Instinct processam os prompts e os sistemas Cerebras CS-3 geram as respostas. Transferir o processamento de prompts para as GPUs permite que os sistemas Cerebras dediquem sua capacidade de atendimento à geração de respostas. Na implantação em produção que medimos, essa combinação entregou 5× a taxa de transferência por megawatt de uma configuração apenas com CS-3, sem nenhuma perda na velocidade de geração de tokens.

Fonte: endpoint GPT-OSS-120B compartilhado em 14 de novembro via Cerebras Inference Cloud — taxa de transferência por megawatt antes e depois de habilitar a inferência desagregada, normalizada em relação à linha de base da inferência agregada (1×).
Planejamos implantar a inferência desagregada amplamente, em centenas de megawatts na Cerebras Inference Cloud e em implantações de parceiros até o final de 2027. Nosso objetivo é aumentar a capacidade de inferência ultrarrápida disponível para nossos clientes.
Inferência desagregada da Cerebras para parceiros de infraestrutura
A solução de inferência desagregada da Cerebras também foi desenvolvida para ser adotada por nossos parceiros. Parceiros de infraestrutura podem implantar clusters de inferência desagregada com base na arquitetura de referência fornecida pela Cerebras, colocando seus aceleradores de prefill escolhidos e os sistemas Cerebras lado a lado em uma rede unificada. Para a integração de software, os parceiros podem optar pela stack de software desagregado ponta a ponta da Cerebras ou por um SDK exclusivo para decode.
- A stack de software desagregado ponta a ponta é ideal para parceiros que querem otimizar o tempo de lançamento no mercado. Ela consiste em:
- Um framework de inferência desagregada para rotear requisições entre os pools de prefill e decode e gerenciar a capacidade e a integridade das réplicas.
- Um motor de prefill para processar prompts usando motores de inferência open source, como vLLM ou SGLang.
- Um motor de decode Cerebras para geração de respostas em sistemas Cerebras.
- O software KV Portal, uma interface para transferir o estado intermediário do modelo, incluindo caches de chave-valor, entre os motores de prefill e decode via RDMA.
O SDK exclusivo para decode é mais indicado para parceiros que buscam otimizar o controle. Com ele, os parceiros podem trazer seu próprio framework de inferência e motor de prefill para o motor de decode da Cerebras e o software KV Portal. Além disso, o SDK exclusivo para decode oferece recursos de apoio ao desenvolvimento, como uma réplica de decode Cerebras simulada e uma integração de referência com um framework de inferência desagregada e um motor de prefill open source.

Parceiros com acesso antecipado, incluindo Amazon Web Services, Fireworks AI, Gimlet Labs e General Compute, já contam com a solução de desagregação da Cerebras para suas implantações. Agora estamos ampliando o acesso a outros parceiros que desejam levar inferência ultrarrápida aos seus clientes em escala.
Para discutir os resultados, soluções ou oportunidades de implantação com mais detalhes, fale conosco aqui.


