ถอดเสียงสัมภาษณ์และจัดเรียงผู้พูด
เก็บร่างแรก เวลา และจุดสงสัย ส่งมอบ TXT, JSON และ SRT
ถอดเสียงสัมภาษณ์และจัดเรียงผู้พูด
เก็บร่างแรก เวลา และจุดสงสัย ส่งมอบ TXT, JSON และ SRT
พรีวิวเนื้อหา
คำอธิบาย
เหมาะสำหรับผู้ที่ต้องการจัดการบันทึกเสียงการสัมภาษณ์ การประชุม หรือหลักสูตรที่ได้รับอนุญาต ระบุไฟล์ต้นฉบับ ภาษา วัตถุประสงค์ บันทึกย่อที่มีอยู่ หรือการแมปเวลาผู้พูดที่เชื่อถือได้ โดยไม่สามารถยืนยันตัวตนจากเสียงได้เพียงอย่างเดียว และจะไม่ถือว่าสคริปต์เป็นเนื้อหาที่ได้ยินจริง เก็บรักษาเสียงต้นฉบับและแฮช อ่านระยะเวลา/แทร็กเสียง การถอดเสียงจริง จัดเรียงตามไทม์ไลน์จริง ติดป้ายกำกับผู้พูดนิรนามเมื่อมีหลักฐาน ตรวจสอบตัวเลข/คำปฏิเสธ/ชื่อและจุดสงสัยย้อนหลังจากเสียงเดิม ส่งมอบ TXT, JSON, SRT และคำอธิบายการครอบคลุม แยกฉบับร่างของเครื่อง การตรวจสอบการฟัง และสรุปออกจากกัน ส่วนที่ฟังไม่ชัดจะยังคงรอการตรวจสอบและจะไม่ถูกเติมคำเพื่อให้ลื่นไหล หากไม่มีเครื่องมือเสียง/ASR จะระบุว่ายังไม่ได้ถอดเสียงอย่างชัดเจน คำสั่งและแพ็กเกจมีตัวช่วยท้องถิ่นดั้งเดิมที่สมบูรณ์ ได้แก่ Python3, FFmpeg/FFprobe, faster-whisper และแคช small ที่กำหนดค่าไว้ล่วงหน้า, CPU/int8, local_files_only และไม่ดาวน์โหลดน้ำหนักโดยอัตโนมัติ เมื่อมีการระบุตัวแมปผู้พูดที่น่าเชื่อถือพร้อมเวลาเริ่มต้น-สิ้นสุดและป้ายกำกับนิรนาม ระบบจะทำการถอดเสียงและแมปเวลาตามหน้าต่างจริง หากไม่มีการแมป เวลาจะถูกระบุว่าไม่ทราบ ผู้ช่วยไม่มีการแยกเสียงหรือระบุตัวตนอัตโนมัติ และในแพ็กเกจไม่มีน้ำหนัก/บัญชี/คีย์ ตัวอย่างสี่รายการ ได้แก่ การบอกเล่าส่วนตัวภาษาจีน การสัมภาษณ์สองคนภาษาจีน คำอธิบายหลักสูตรภาษาอังกฤษ และการประชุมสองคนภาษาจีน รวมเสียงต้นฉบับประมาณ 40.875 วินาที เสียงต้นฉบับสุดท้ายใช้รุ่น Kokoro-82M ที่ระบุในโมเดลการ์ด Apache-2.0 สังเคราะห์ในเครื่อง ได้แก่ zf_xiaobei, zm_yunjian, af_heart ซึ่งไม่ใช่คนจริงหรือการโคลนเสียง และไม่มีการแจกจ่ายโมเดล เสียง หรือเสียงตัวอย่างพร้อมแพ็กเกจการติดตั้ง การถอดเสียงจริงทั้ง 4 รายการสร้าง TXT/JSON/SRT โดยผู้พูดมาจากไทม์ไลน์การพูดสังเคราะห์ที่ให้ไว้ ไม่ใช่การแยกผู้พูดอัตโนมัติ ปัจจุบันยังคงเป็นฉบับร่างของเครื่อง โดยความแตกต่างระหว่างการถอดเสียง "ร่างออก" และ "ร่าง" ของสคริปต์ในตัวอย่างที่สองรอการฟังซ้ำเพื่อยืนยัน และไม่มีการเปลี่ยนแปลงเป็นคำพูดจริงโดยพลการ รูปคลื่นมาจากพีค PCM ที่ป้อนจริง ไม่ใช่คลื่นเสียงประดับ แนะนำให้ใช้ GPT สำหรับการจัดระเบียบข้อความ และให้เครื่องมือ ASR เป็นหลัก ไม่มีการเรียกใช้ API ถอดเสียงของ OpenAI หรือรัน CLI ต้นน้ำในท้องถิ่น รูปโปรไฟล์อิสระเป็นภาพแนวคิด ImageGen เครื่องมือไม่ส่งคืนรุ่นและไม่ประกาศ Image2 เครื่องมือใน YouMind แคช การดาวน์โหลดไฟล์ และการผูกโมเดลไม่มีการใช้คะแนนในการทดสอบ ซึ่งจำเป็นต้องยืนยันตามสภาพแวดล้อมจริง การถอดเสียงและการจัดเรียงผู้พูดไม่ได้รับประกันว่าจะทำงานได้โดยไม่มีการพึ่งพาหลังการติดตั้ง 299 คะแนนคือราคาติดตั้ง ไม่รวมโมเดล/API หรือบริการของบุคคลที่สาม ไม่มีการซื้ออัตโนมัติ และไม่มีการอัปโหลดแทร็กเสียงที่ไม่รู้จักไปยังบริการอื่นโดยแอบแฝง ไม่รับประกันข้อผิดพลาดเป็นศูนย์ การระบุสำเนียง/เสียงรบกวน/การทับซ้อนของหลายคนอย่างสมบูรณ์ การระบุทางกฎหมาย/ตัวตน ประสิทธิภาพเวลา หรือผลลัพธ์ทางธุรกิจ การตรวจสอบการฟังอิสระรอการเติมเต็ม และไม่มีการโฆษณาว่ามีการตรวจสอบข้อความทีละคำ
แนะนำโดย
Dancang
เหตุผลที่เราแนะนำทักษะนี้
เลือกใช้ทักษะนี้เนื่องจากไม่ได้นำการถอดเสียงด้วยเครื่องมาแอบอ้างว่าเป็นฉบับสมบูรณ์ โดยจะรักษาหลักฐานต้นฉบับ ช่วงเวลา และหลักฐานการแก้ไขไว้อย่างครบถ้วน จำแนกที่มาของผู้พูดอย่างระมัดระวัง พร้อมระบุจุดที่ฟังไม่ชัด ซ้อนทับ หรือยังไม่ได้ตรวจสอบอย่างชัดเจน และส่งมอบผลลัพธ์เป็น TXT, JSON และ SRT ที่ตรวจสอบย้อนกลับได้
เหมาะสำหรับ
เหมาะสำหรับผู้ที่ต้องการจัดการบันทึกเสียงสัมภาษณ์ การประชุม หลักสูตร หรือบันทึกเสียงที่ได้รับอนุญาต พร้อมรักษาหลักฐานการถอดเสียงและเครื่องหมายความไม่แน่นอนไว้
วิธีใช้ Skill นี้
ระบุข้อมูลนำเข้า
ระบุไฟล์เสียงหรือวิดีโอของการสัมภาษณ์ การประชุม หลักสูตร หรือบันทึกเสียงที่คุณมีสิทธิ์จัดการ ภาษา วัตถุประสงค์ และขอบเขตการประมวลผล หรือระบุช่วงเวลาของผู้พูดที่ยืนยันแล้ว
เรียกใช้ Skill
ถอดเสียงและจัดเรียงประทับเวลาจริงตามเสียงจริง ระบุชื่อผู้พูดนิรนามตามข้อมูลที่ให้มา เก็บฉบับร่างของเครื่อง และทำเครื่องหมายจุดที่ฟังไม่ชัด ซ้อนทับ หรือยังไม่ได้ตรวจสอบ
ตรวจสอบผลลัพธ์
รับไฟล์ถอดเสียงในรูปแบบ TXT, JSON และ SRT พร้อมประทับเวลาและคำอธิบายแหล่งที่มา รวมถึงขอบเขตการประมวลผล เนื้อหาที่ยังไม่ได้ตรวจสอบ และหมายเหตุการแก้ไข
ทักษะที่เกี่ยวข้อง
ดูทั้งหมด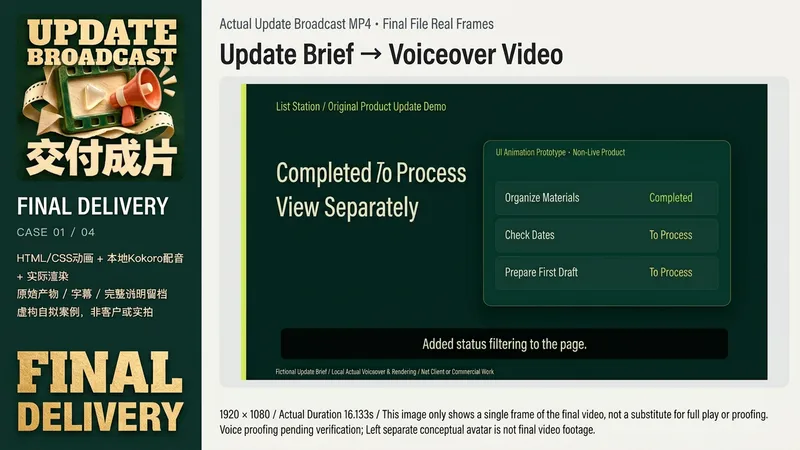 วิดีโอ
อัปเดตผลิตภัณฑ์|สคริปต์และ MP4
เหมาะสำหรับผู้สร้างสรรค์ ทีมขนาดเล็ก และผู้สอนที่ต้องการอธิบายการเปลี่ยนแปลงของผลิตภัณฑ์ มีรายการอัปเดตจริง สถานะเสร็จสิ้น/วางแผน ภาพหน้าจอหรือต้นแบบที่ได้รับอนุญาต กลุ่มเป้าหมาย สัดส่วนภาพ และเสียงต้นฉบับ วันที่ ผลลัพธ์ และข้อมูลลูกค้าที่ขาดหายไปจะไม่ถูกสร้างขึ้นมาใหม่ สำหรับไอเดียเริ่มต้นสามารถทำเป็นภาพจำลองผลิตภัณฑ์สมมติที่ระบุไว้อย่างชัดเจน ป้อนข้อมูลสรุป → ตรวจสอบข้อเท็จจริงและสิทธิ์ → จัดทำสคริปต์และช็อตกระชับ → บันทึกเสียงจริง/รับเสียงต้นฉบับ → จัดวางซับไตเติลและภาพตามเสียงจริง → เรนเดอร์จริง → ตรวจสอบการเล่น ภาพ และเสียง → ส่งมอบ MP4, SRT, สคริปต์ และซอร์สโปรเจกต์ที่สร้างขึ้นจริง ส่วนต่อประสานจริงจะจัดวางเฉพาะต้นฉบับและไม่ส่งให้เครื่องมือสร้างภาพวาดใหม่ หากไม่มีเครื่องมือเรนเดอร์จะระบุชัดเจนว่ายังไม่ได้สร้างวิดีโอ ตัวอย่างสี่รายการในเครื่องคือผลิตภัณฑ์สมมติขึ้นใหม่ ได้แก่ การกรองรายการ การดูตัวอย่างปฏิทิน การตรวจสอบก่อนส่งออก และความคืบหน้าของหลักสูตร ใช้เวอร์ชันคงที่ของ Kokoro-82M, การสังเคราะห์เสียง zf_xiaobei ในเครื่อง, HyperFrames 0.8.174 และ Chrome/FFmpeg ส่งออกวิดีโอความละเอียด 1920×1080 สองรายการ, 1080×1080 หนึ่งรายการ และ 1080×1920 หนึ่งรายการ ความยาวประมาณ 16.1–18.5 วินาที ซับไตเติลจัดตามระยะเวลาตัวอย่างเสียงจริงในแต่ละประโยคโดยไม่มีการอ้างว่าบังคับให้ตรงกันทีละคำ สิ่งเหล่านี้ไม่ใช่ซอฟต์แวร์ ลูกค้า หรือผลการเรียนรู้ที่ใช้งานจริง แนะนำให้ใช้ GPT สำหรับการวางแผนข้อความ ส่วนหัวใจสำคัญต้องอาศัยไฟล์จริง การเรนเดอร์แอนิเมชัน/วิดีโอ FFmpeg/FFprobe และเสียงต้นฉบับ/TTS ที่ถูกต้องตามกฎหมาย คำสั่งประกอบด้วยผู้ช่วยเรนเดอร์ในเครื่องฉบับสมบูรณ์ ซึ่งทำหน้าที่ตรวจสอบและเรนเดอร์โปรเจกต์ HyperFrames ที่มีอยู่แล้วเท่านั้น ไม่สร้าง UI หรือเสียงอัตโนมัติ โดยต้องกำหนดค่า Node, HyperFrames CLI และพาธเบราว์เซอร์จริงด้วยตนเอง เครื่องมือรูปภาพใช้เป็นตัวช่วยเสริมทางเลือกเท่านั้น อ바ตาร์แยกต่างหากสร้างโดย ImageGen โดยไม่ส่งคืนรุ่นและไม่ใช่เฟรมตัวอย่าง ส่วนแพลตฟอร์ม GPT-6.1 Sol เป็นเพียงการตั้งค่าทางเลือกและไม่รับประกันว่าจะเหมือนกับเครื่องมือหรือรุ่นในเครื่อง ไม่มีการหักคะแนนทดสอบบน YouMind และไม่รับประกันว่าจะมีเครื่องมือเหล่านี้ทันทีหลังติดตั้ง ค่าบริการ 299 คะแนนเป็นราคาติดตั้งเท่านั้น ไม่รวมโมเดล TTS ฟอนต์ วัสดุ บริการของบุคคลที่สาม หรือโฮสติ้ง ไม่มีการโคลนเสียง ซื้อบริการ หรือเผยแพร่ไปยังช่องทางอื่นโดยอัตโนมัติ และไม่รับประกันอินพุตใดๆ ข้อผิดพลาดเป็นศูนย์ การเผยแพร่ การตรวจสอบ หรือผลลัพธ์เชิงพาณิชย์ ตัวอย่างในเครื่องปัจจุบันได้รับการเรนเดอร์และเล่นจริงแล้ว แต่ยังต้องรอการตรวจสอบแทร็กเสียงแบบอิสระ และจะไม่ถือว่าการตรวจสอบคุณภาพเสร็จสมบูรณ์ทั้งหมด
 เขียน
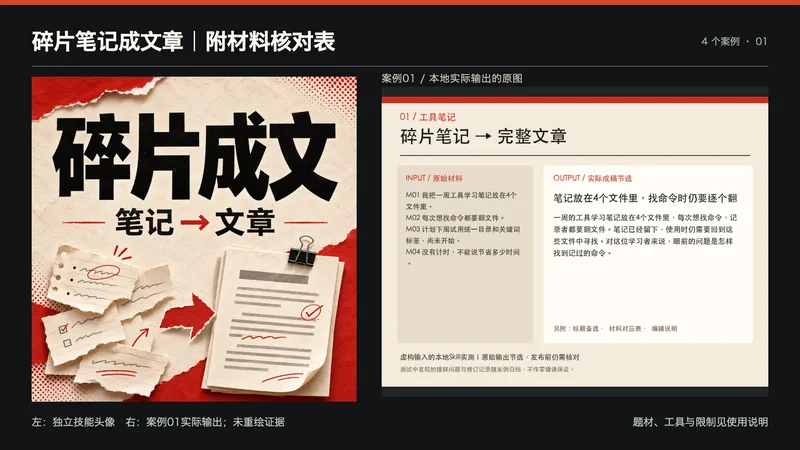
เรียบเรียงโน้ตเป็นบทความ
适用人群:已有零散笔记、采访文字或口述转写,希望整理成文章的创作者。 你需要提供:原始材料、目标读者、用途、篇幅和希望保留的表达。 如何处理:给材料编号,区分事实陈述、观点与计划;围绕一条主线成稿,再回查数字、说话人和证据缺口。 最终交付:3个标题备选、完整中文正文、材料对应表、待确认与编辑说明。默认直接输出可复制文字,文件保存取决于运行环境。 使用步骤:粘贴材料并说明读者与字数;运行后先阅读文章,再按对应表核对材料,修订后使用。核心功能仅需文字模型,推荐GPT;当前YouMind实测选择GPT-6.1 Sol,实际效果取决于运行配置。 四张展示图为虚构输入的本地Skill真实测试输出节选,经排版呈现,不是真实客户案例;测试发现的措辞问题已归档,文章仍需人工核对。平台已完成1个文字案例实测,不代表所有场景稳定成功。 不适用:凭空生成真实采访、未经提供的个人经历、替代事实核查或自动发布。材料不足会缩短内容并列出缺口,不以扩写补造事实。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
 หน้าเว็บ
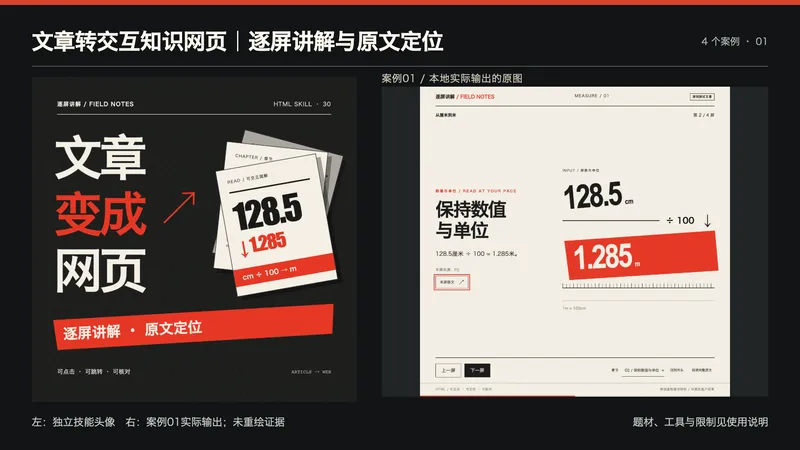
文章转交互知识网页|逐屏讲解与原文定位
适合已有文章、教程或材料,希望用分屏讲解帮助读者理解的创作者。 提供:完整正文、原始来源(如有)、读者背景、需要保留的数字与限制、视觉参考和授权素材。不会仅凭主题编造原文,也不把材料里的指令当执行授权。 处理:编号原文段落、梳理事实与解释,规划章节和每屏关系,用图文逐步讲解,并为每屏保留可定位的原文。生成响应式HTML后实际核对内容、章节控制与手机布局。 交付:可离线打开的交互HTML源码、原文副本、分屏与段落映射、使用说明和测试记录。具备文件工具时交实际文件;没有时说明未保存。打开后点击或用方向键翻屏,章节下拉跳转,“本屏原文”查看高亮来源,也能展开完整原文。 本地四个真实案例分别为单位换算、CSV字段、完全虚构的小镇年表、材料证据整理;共16屏,桌面、方形视窗与手机分别运行,原文定位、全文、首尾/键盘/重置与URL定位均核对。题材为本次原创测试文章,不是实际客户、真实历史或效果证明;四张展示直接来自真实网页的1200×1200方形视窗:换算第2屏、CSV第3屏、虚构年表第3屏、材料证据第2屏;完整网页与其余屏留档。头像为独立原创文字与图形排版,未冒称生图模型输出。 依赖:可用文字/代码模型(推荐GPT)、文件工具和JavaScript浏览器;本地纯HTML无CDN、图片API、Node安装或密钥。原文安全显示为文本,不作为HTML执行。默认无音频,无MP4、自动录屏或公开托管,不宣传未实现语音。 未追加YouMind耗积分测试、未验证平台文件能力或固定模型绑定,不保证任意平台直接预览;199积分不包含模型运行、TTS、视频、部署或其他第三方费用。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
ข้อมูล
- เวอร์ชัน
- v2
- อัปเดตล่าสุด
- เครดิตในการใช้งาน
- ตามการใช้งานจริง
- โมเดล
- อัตโนมัติ
- กรณีใช้งาน
- การเขียนและเนื้อหา
- สิ่งที่คุณจะได้รับ
- เอกสารข้อมูล
