Ми розгорнули Cerebras Wafer Scale Engines разом із GPU, щоб забезпечити блискавичну генерацію токенів у великих масштабах
Світ прагне надшвидких токенів. У 2026 році Cerebras зіткнулася з ненаситним попитом на швидкий інференс — як у нашій хмарі інференсу, так і через партнерів. Щоб задовольнити цей попит, ми почали розробляти деагрегований інференс: GPU обробляють промпти (prefill), а системи Cerebras генерують відповідь (decode).
Це рішення вже працює в продакшені та видає вп'ятеро більше токенів на мегават при тій самій надшвидкій швидкості Cerebras.
Тепер ми можемо надавати більше надшвидких токенів через Cerebras Inference Cloud, щоб задовольнити ринковий попит. Інфраструктурні партнери також можуть використовувати деагреговане рішення Cerebras, щоб отримувати більше надшвидких токенів у власних дата-центрах.
Разом із нещодавно анонсованим CS-4, суттєво нарощеними виробничими потужностями та запланованими 700 МВт потужностей дата-центрів, деагрегований інференс дозволить Cerebras і партнерам обслуговувати значно більше надшвидких токенів у 2027 році та далі. У цьому блозі ми розглянемо:
- Потребу в додаткових потужностях для надшвидкого інференсу
- Чому Cerebras має перевагу на етапі декодування
- Результати роботи деагрегованого інференсу Cerebras у продакшені
- Деагрегований інференс Cerebras для інфраструктурних партнерів
Потреба в додаткових потужностях для швидкого інференсу
Агентні застосунки, такі як Muse, Copilot і Codex, стрімко масштабуються та потребують високоінтерактивного інференсу, щоб утримувати увагу користувачів. Щоб задовольнити зростаючий попит цих застосунків в умовах обмеженої енергії, наша галузь має забезпечити значно більшу потужність інференсу на мегават при швидкості відгуку, яка робить ці застосунки корисними.

Джерела: Goldman Sachs Research, «AI Agents Forecast to Boost Tech Cash Flow as Usage Soars», 20 травня 2026 року; оцінки потужності дата-центрів Goldman Sachs за даними Investing.com
Саме тому Cerebras інвестувала в дезагрегацію. Поєднання прискорювача prefill для обробки промптів із системою Cerebras для генерації відповідей збільшує пропускну здатність токенів на мегават, зберігаючи при цьому надшвидкі швидкості генерації Cerebras. Для провайдерів інференсу це означає більше можливостей для обслуговування клієнтів і вищий потенціал доходу в межах того самого енергетичного бюджету.
Чому Cerebras має перевагу на етапі декодування
Запит на інференс складається з двох основних етапів. Обробка промпту, відома як prefill, опрацьовує вхідні дані та формує проміжний стан моделі. Генерація відповіді, відома як decode, використовує цей стан для створення вихідних токенів. Існує багато способів розділити навантаження інференсу, зокрема draft–target та attention–FFN, але саме відокремлення prefill від decode дає унікальну перевагу, коли мета — високоінтерактивний інференс.

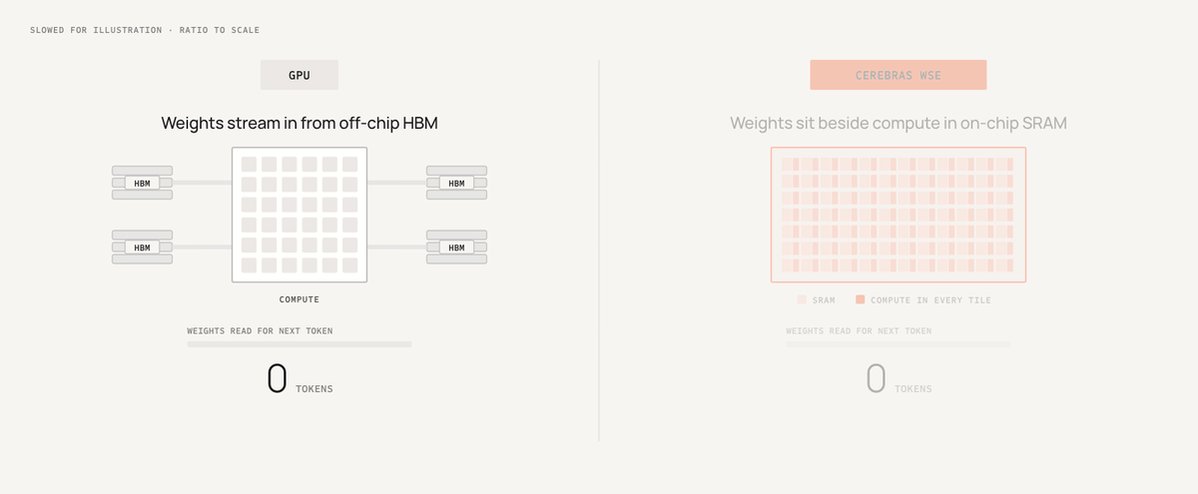
Декодування є авторегресивним. Це означає, що модель генерує один токен за раз, використовуючи кожен згенерований токен як вхідні дані для наступного. Кожен крок потребує повторного зчитування даних моделі з пам'яті, тому пропускна здатність пам'яті має вирішальне значення. У сфері надшвидкого інференсу чипи на базі SRAM мають перевагу, оскільки вони можуть зберігати ці дані безпосередньо на чипі та зчитувати їх значно швидше. Cerebras масштабує цей підхід до рівня пластини: десятки гігабайтів SRAM і десятки петабайтів на секунду пропускної здатності пам'яті на одному чипі — це у 350 разів більша ємність SRAM та у 5400 разів вища пропускна здатність пам'яті порівняно з типовим GPU GB300. Завдяки цьому система Cerebras може розмістити більше одночасних запитів і шарів моделі безпосередньо на чипі, що дозволяє CS-3, CS-4 та CS-5 досягати надшвидких швидкостей при привабливій пропускній здатності.
GIF
Результати роботи деагрегованого інференсу Cerebras у продакшені
Поєднання систем Cerebras, оптимізованих для надшвидкого декодування, з прискорювачами, які добре відповідають обчислювальним потребам prefill, такими як GPU AMD Instinct, дозволяє забезпечити колосальні обсяги надшвидкого інференсу в масштабі. У продакшен-розгортанні на Cerebras Inference Cloud GPU AMD Instinct обробляють промпти, а системи Cerebras CS-3 генерують відповіді. Перенесення обробки промптів на GPU дозволяє системам Cerebras спрямувати всю свою потужність на генерацію відповідей. У нашому виміряному продакшен-розгортанні ця комбінація забезпечила вп'ятеро вищу пропускну здатність на мегават порівняно з конфігурацією лише на CS-3, без жодної втрати швидкості генерації токенів.

Джерело: спільний ендпоінт GPT-OSS-120B від 14 листопада через Cerebras Inference Cloud — пропускна здатність на мегават до та після увімкнення деагрегованого інференсу, нормалізована відносно базового рівня агрегованого інференсу (1×).
Ми плануємо широко розгорнути деагрегований інференс на сотнях мегават у Cerebras Inference Cloud та в розгортаннях партнерів до кінця 2027 року. Наша мета — збільшити обсяг надшвидких потужностей інференсу, доступних для наших клієнтів.
Деагрегований інференс Cerebras для інфраструктурних партнерів
Деагреговане рішення Cerebras для інференсу також створене для впровадження нашими партнерами. Інфраструктурні партнери можуть розгортати кластери деагрегованого інференсу на основі референсної архітектури від Cerebras, розміщуючи обрані ними прискорювачі prefill та системи Cerebras в єдиній мережі. Для програмної інтеграції партнери можуть використовувати або повний деагрегований програмний стек Cerebras, або SDK лише для декодування.
- Повний деагрегований програмний стек найкраще підходить для партнерів, які хочуть мінімізувати час виходу на ринок. Він включає:
- Фреймворк деагрегованого інференсу для маршрутизації запитів між пулами prefill і decode, а також керування ємністю та станом реплік.
- Двигун prefill для обробки промптів за допомогою open-source двигунів інференсу, таких як vLLM або SGLang.
- Двигун декодування Cerebras для генерації відповідей на системах Cerebras.
- Програмне забезпечення KV Portal — інтерфейс для передачі проміжного стану моделі, включно з key-value кешами, між двигунами prefill і decode через RDMA.
SDK лише для декодування найкраще підходить для партнерів, яким важливий максимальний контроль. З цим SDK партнери можуть використовувати власний фреймворк інференсу та двигун prefill разом із двигуном декодування Cerebras і програмним забезпеченням KV Portal. Крім того, SDK лише для декодування надає допоміжні інструменти для розробки, такі як мок-репліка декодування Cerebras та референсна інтеграція з open-source фреймворком деагрегованого інференсу й двигуном prefill.

Партнери з раннім доступом, зокрема Amazon Web Services, Fireworks AI, Gimlet Labs і General Compute, уже використовують деагреговане рішення Cerebras у своїх розгортаннях. Зараз ми розширюємо доступ для інших партнерів, які прагнуть надавати своїм клієнтам надшвидкий інференс у великих масштабах.
Щоб детальніше обговорити результати, рішення або можливості розгортання, зв'яжіться з нами тут.


