場景分鏡與一致性提示詞
從場景拆出分鏡與提示詞,鎖定一致性
場景分鏡與一致性提示詞
從場景拆出分鏡與提示詞,鎖定一致性
展示內容
描述
英文名稱:Storyboard to Prompts — Consistency-Locked Shot Prompts。俄文名稱:將場景分鏡轉為提示詞並維持形象一致性。 輸入場景、場景節拍或現成的鏡頭清單,Skill 就會產出分鏡與提示詞。它會整理角色與道具設定表,建立可逐字插入每個鏡頭的固定描述;將提示詞拆分為嚴格固定的核心與可變部分;為景別、鏡頭運動、光線與色彩建立統一詞彙;為整個場景撰寫一組負面提示詞,並記錄重新生成流程,避免主角「飄移」。最終輸出是可直接用於 Seedance、Veo 或 Kling 的鏡頭與提示詞表,另附依畫面方位進行的整體連戲檢查。 Skill 會回答每個場景的兩個問題:哪些內容要在提示詞中逐字重複,哪些內容會隨鏡頭改變。它不會重新調度場景,也不會臨時創作戲劇內容,而是採用已確定的決策,讓這些決策能在生成器中重現。它要解決的核心痛點是主角「飄移」:臉部、髮型、服裝與道具在不同片段間改變,角色的畫面方位混淆,道具被相似物取代,最後影片只剩下一組組漂亮但彼此不連貫的畫面。 這個 Skill 是「場面調度與走位」的直接延伸:前者回答「如何安排場景」,本 Skill 則回答「如何取得主角與道具保持一致的鏡頭」。適合使用 Seedance、Veo、Kling 及類似工具製作連貫影片的 AI 導演與創作者、獨立動畫創作者、行銷人員及代理商。輸出格式為附有提示詞與畫面方位圖的鏡頭表,可立即投入工作。 標籤:分鏡、影片提示詞、角色一致性、形象維持、道具與連戲、設定表、負面提示詞、Seedance、Veo、Kling。英文名稱:Storyboard to Prompts — Consistency-Locked Shot Prompts。
適合對象
適合製作連貫影片場景的 AI 導演、動畫創作者、行銷團隊與代理商。
如何使用此 Skill
提供輸入
請提供場景、場景節拍或現成的鏡頭清單,以及角色、道具、場景、光線與格式等資訊。
執行 Skill
服務會將已核准的素材轉換為逐鏡分鏡,區分固定的形象元素與可變的鏡頭參數。
查看結果
你將獲得包含提示詞與連戲圖的鏡頭表,用來維持角色外觀、道具與畫面方位的一致。
相關技能
查看全部場景對話與潛台詞
英文名稱:Dialogue & Subtext — Scene to Dialogue Score。俄文名稱:Диалог и подтекст сцены — от реплик к звуковой партитуре。 輸入一段包含台詞的場景,Skill 會按鏡頭產出可直接使用的對話聲音譜表。它會分析角色字面上說了什麼,以及實際想表達什麼;整理未說出口的內容;逐句判斷哪些內容應由台詞說出、哪些應交給動作、哪些應留給停頓;找出沉默比語言更有力量的位置;將文字分配到各個鏡頭,包括畫外音與無聲回應;透過畫面中的行為,而不是語音生成,設定說話的語氣;標記物件聲或日常環境音可以取代台詞的位置;並判斷哪些地方不需要音樂,以及原因。輸出是一份按鏡頭整理的表格:台詞、停頓、沉默、日常聲音、聽得見的內容,以及沒有發出聲音的內容。 Skill 會回答每個場景的兩個問題:角色真正說的是什麼,以及如何將這些內容拆分到各個鏡頭,讓意義不只由語言承載。它可以處理包含台詞的場景,或前兩個 Skill 產出的現成 shot list,並專注於聲音的戲劇性。核心原則是:單靠語音配音不是方法;Skill 提供的是導演決策——什麼保持沉默、什麼發出聲音、哪裡安排停頓與寂靜——而不是語音生成按鈕。 這是系列中的第三個 Skill,延續「場景調度與阻擋」和「將場景分鏡轉為能維持形象的提示詞」:第一個負責安排場景,第二個維持畫面間的形象一致,第三個拆解角色真正說了什麼,以及哪些內容仍未說出口。它不會重複第一個 Skill 的聲音層:第一個處理「聽得見什麼」的技術聲音表,這裡處理對話的意義與潛台詞——「這代表什麼」。鏡頭的數量與順序取自 shot list,不會變更。 適合使用 Seedance、Veo、Kling 的 AI 導演與創作者、獨立動畫師、編劇和行銷人員。輸出格式是按鏡頭整理的對話譜表,可立即投入工作。 標籤:對話與潛台詞、聲音譜表、停頓與寂靜、畫外音、無聲回應、物件聲、透過行為呈現語氣。英文名稱:Dialogue & Subtext — Scene to Dialogue Score。
場面調度與走位
Mise-en-Scène & Blocking — Scene to Shot List(英文名稱)。 輸入一個場景,Skill 會提供場面調度方案並將其轉化為提示詞。它會把場景拆解為行動節拍,安排角色在空間中的位置,判斷畫面中每個人想要什麼,根據角色關係的變化推導走位,依照當下的意義選擇景別與角度,確認視線方向與 180 度軸線,判斷是否需要鏡頭運動及其目的,將光線與時間視為意義的載體,規劃場景的聲音層次,最後整理出逐鏡 shot list,包含聲音欄位,以及適用於你的生成模型的現成提示詞。 Skill 會回答每個場景的兩個問題:現場要如何調度,以及提示詞該怎麼寫,才能讓生成器重現這個具體方案。它關注的不是「有哪些景別」,而是眼前的具體場景。另有專門區塊處理 AI 影片最棘手的角色一致性與「片段感」問題:固定參考形象、統一措辭、安排鏡頭順序、設定 seed,以及列出應避免的內容。 適合使用 Seedance、Veo、Kling 等類似工具製作影片的 AI 導演與創作者、獨立動畫師、行銷人員及代理商。輸出格式為可立即投入工作的分鏡表與提示詞清單。 標籤:場面調度、走位、shot list 與分鏡表、AI 影片、場景導演、視線方向與軸線、影片提示詞、電影感畫面。英文名稱:Mise-en-Scène & Blocking — Scene to Shot List。
 圖片
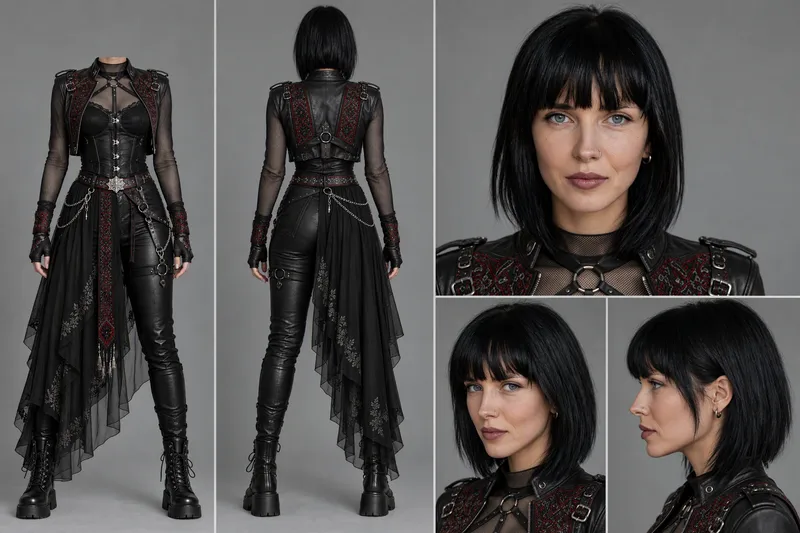
角色檔案
根據角色臉部參考圖片建立專業的角色參考表 (Character Reference Sheet)。本技能會先確認參考表的用途(若用於影片,則包含 3 個畫面:無頭正面全身、背面全身、近景特寫;若用於圖像/照片,則包含 5 個畫面:兩個全身與三個特寫——正面、3/4 側面與側面),請使用者附上 1-3 張臉部照片,詢問是否需要更換服裝(保留原照服裝 / 根據服裝參考更換 / 透過文字描述),並在必要時索取服裝參考。接著透過嚴格的範本組合提示詞,使用 GPT Image 2.5 在中性灰色背景上生成參考表,同時完整保留原角色的外貌、風格、比例與材質。
資訊
- 版本
- v2
- 更新時間
- 執行點數
- 依實際用量
- 模型
- 自動選擇
- 使用情境
- 寫作與內容影片與音訊
- 你將獲得
- 文件提示詞
