بحث عميق وموثوق في الطب/البيولوجيا
التعليمات
这套流程的核心是:先用多 query 在 PubMed / NCBI E-utilities 做可复现初筛,再用 PMID 去重和摘要证据分级;只有少量关键文献进入 PMC / BioC 全文复核;正文引用必须可点击;文末必须列完整文献信息;IF 只能通过公开可访问来源保守核查,不能默认有 JCR 或本地数据库,不能猜,不能把低置信匹配当成确定结果。
1. 用户发起检索后的预处理
1.1 先解析用户问题
收到用户问题后,先把自然语言问题拆成结构化要素。
必须识别:
• 研究对象:基因、蛋白、药物、通道、细胞类型、组织、疾病、模型。
• 生物系统:人、小鼠、大鼠、斑马鱼、类器官、视网膜、脑区、细胞系等。
• 关系类型:表达、调控、功能、机制、表型、死亡、生存、治疗、毒性、发育、退化等。
• 证据需求:是否需要直接证据、机制证据、全文证据、图表、剂量参数、实验方法。
• 时间范围:不限时间、近 5 年、近 1 年、最新进展、经典文献。
• 输出类型:简答、代表文献、综述式总结、实验设计建议、证据表、机制图谱。
示例:
用户问题:
“帮我找视网膜类器官死亡相关文献。”
结构化拆解(示例):
• 核心模型:retinal organoid, retina organoid, hPSC-derived retinal organoid, optic cup organoid。
• 表型:cell death, apoptosis, degeneration, survival loss, stress, necrosis。
• 相关细胞:photoreceptor, cone, rod, retinal ganglion cell, Müller glia。
• 潜在机制:oxidative stress, ER stress, mitochondrial dysfunction, hypoxia, inflammation, ferroptosis, necroptosis。
• 证据目标:优先找直接在人源或动物源 retinal organoid 中观察到细胞死亡/凋亡/退化的原始研究;再找间接机制文献。
1.2 关键词拆分原则(示例)
不要只写一个检索式。每个概念至少准备三类词。
第一类:精确词。
• retinal organoid
• retina organoid
• human retinal organoid
• hPSC-derived retinal organoid
• iPSC-derived retinal organoid
第二类:同义词和上位词。
• optic cup organoid
• 3D retinal culture
• stem cell-derived retina
• retinal differentiation
• retinal tissue model
第三类:机制和表型词。
• apoptosis
• cell death
• degeneration
• survival
• stress
• oxidative stress
• ER stress
• mitochondrial dysfunction
• hypoxia
• necroptosis
• ferroptosis
如果用户限定细胞类型,加入:
• photoreceptor
• cone
• rod
• retinal ganglion cell
• Müller glia
• bipolar cell
• amacrine cell
如果用户限定物种或来源,加入:
• human
• mouse
• rat
• zebrafish
• hESC
• iPSC
• pluripotent stem cell
1.3 生成分层检索式
至少生成 3–6 组 query。每组 query 对应一个检索目的。
第一层:直接证据检索。
用于找目标模型 + 目标表型直接命中的文献。
```text
("retinal organoid" OR "retina organoid" OR "human retinal organoid") AND (apoptosis OR "cell death" OR degeneration)
```
第二层:扩展模型检索。
用于捕捉作者没有使用 retinal organoid 精确词但实际相关的文献。
```text
("optic cup organoid" OR "3D retinal culture" OR "stem cell-derived retina") AND (survival OR apoptosis OR stress)
```
第三层:机制专项检索。
用于验证具体通路或机制。
```text
("retinal organoid" OR "retina organoid") AND ("oxidative stress" OR "ER stress" OR hypoxia OR mitochondria)
```
第四层:细胞类型专项检索。
```text
("retinal organoid" OR "retina organoid") AND (photoreceptor OR cone OR rod OR "retinal ganglion cell") AND (death OR apoptosis OR degeneration)
```
第五层:疾病模型检索。
```text
("retinal organoid" OR "retina organoid") AND (disease OR degeneration OR dystrophy OR retinitis OR glaucoma)
```
第六层:综述/背景检索。
```text
("retinal organoid" OR "retina organoid") AND (review OR protocol OR model)
```
2. 使用什么方法、在什么网站检索
2.1 首选:PubMed / NCBI E-utilities
PubMed 是生物医学文献检索首选。不要默认抓 PubMed 网页。应使用 NCBI E-utilities API。
2.1.1 ESearch:用 query 获取 PMID
接口:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi
```
参数:
```text
db=pubmed
term=<检索式>
retmode=json
retmax=20
sort=relevance
```
也可按时间排序:
```text
sort=pub+date
```
示例:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=pubmed&term=(%22retinal%20organoid%22%20OR%20%22retina%20organoid%22)%20AND%20(apoptosis%20OR%20%22cell%20death%22)&retmode=json&retmax=20&sort=relevance
```
返回中读取:
```text
esearchresult.idlist
```
这就是 PMID 列表。
2.1.2 ESummary:获取文献 metadata
接口:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi
```
参数:
```text
db=pubmed
id=PMID1,PMID2,PMID3
retmode=json
```
提取字段:
• PMID
• title
• fulljournalname
• source / journal abbreviation
• pubdate
• authors
• articleids 中的 DOI、PMCID
• volume、issue、pages
2.1.3 EFetch:获取摘要和 XML 细节
接口:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/efetch.fcgi
```
参数:
```text
db=pubmed
id=PMID1,PMID2
retmode=xml
rettype=abstract
```
提取字段:
• ArticleTitle
• AbstractText
• Journal Title
• ISOAbbreviation
• ISSN / eISSN
• PubDate
• DOI
• PMCID
• MeSH terms
2.1.4 批量检索策略
推荐流程:
1. 对每个 query 调用 ESearch。
2. 每个 query 取前 5–20 篇。
3. 合并所有 PMID。
4. 按 PMID 去重。
5. 用 ESummary / EFetch 批量获取 metadata 和 abstract。
6. 初筛阶段只读 metadata + abstract,不要一开始抓全文。
────────────────
2.2 第二阶段:PMC / BioC 全文复核
只有以下情况才进入全文:
• 用户要求精读全文。
• 摘要不足以判断机制。
• 需要图表、实验方法、浓度、剂量、IC50、EC50、Kd、Ki。
• 已筛出少量关键 PMID,需要逐篇机制复核。
2.2.1 PMID 转 PMCID
接口:
```text
https://www.ncbi.nlm.nih.gov/pmc/utils/idconv/v1.0/?ids=<PMID>&format=json
```
如果返回 PMCID,说明可能有 PMC 开放全文。
2.2.2 优先 BioC JSON
接口:
```text
https://www.ncbi.nlm.nih.gov/research/bionlp/RESTful/pmcoa.cgi/BioC_json/<PMCID>/unicode
```
优点:结构化程度高,适合抽取正文段落。
2.2.3 BioC 不可用时尝试 PMC XML
接口:
```text
https://www.ncbi.nlm.nih.gov/pmc/articles/<PMCID>/?report=xml
```
抽取正文时跳过:
• references
• bibliography
• acknowledgements
• author contributions
• competing interests
全文复核必须设置停止判据:
• 每篇文献只扫描一次。
• 默认只抽取与问题相关的段落。
• 如果未命中目标字段,标注“未见直接证据”。
• 不要无限换关键词重复抓取。
────────────────
2.3 bioRxiv / medRxiv
用于补充最新预印本。
可以使用官方 API:
```text
https://api.biorxiv.org/details/biorxiv/YYYY-MM-DD/YYYY-MM-DD
https://api.biorxiv.org/details/medrxiv/YYYY-MM-DD/YYYY-MM-DD
```
也可用普通搜索作为补充:
```text
site:biorxiv.org retinal organoid apoptosis
site:medrxiv.org retina organoid degeneration
```
预印本必须标注:
```text
预印本,未经同行评议。
```
────────────────
2.4 Crossref / OpenAlex / Unpaywall
用于补全 DOI、开放全文地址、出版信息。
Crossref:
```text
https://api.crossref.org/works?query.title=<title>
```
OpenAlex:
```text
https://api.openalex.org/works?search=<title or topic>
```
Unpaywall:
```text
https://api.unpaywall.org/v2/<DOI>?email=<your_email>
```
用途:
• DOI 补全。
• OA PDF 链接查找。
• 期刊名核验。
• 出版年份核验。
────────────────
2.5 出版商页面
只有在 API 信息不足时才访问出版商页面。
访问规则:
• 每个出版商 URL 只尝试一次。
• 遇到验证码、登录墙、Cloudflare、Access Denied、机构权限墙,立即停止。
• 不要反复刷新、换同站路径、循环等待。
• 改用 PubMed、PMC、Crossref、OpenAlex、Unpaywall、DOI metadata 兜底。
3. 检索后如何整理信息
3.1 建立统一记录结构
每篇文献整理成统一 record。
字段:
```text
pmid
doi
pmcid
title
authors
journal
journal_abbrev
issn
eissn
year
abstract
query_source
evidence_level
evidence_tags
paper_type
url
```
3.2 去重
优先级:
1. PMID 去重。
2. 没有 PMID 时用 DOI 去重。
3. 没有 DOI 时用 lower(title) + year + first_author 去重。
保留第一次命中的 query_source,同时记录该文献被哪些 query 命中。
3.3 证据分级
必须区分:
直接证据:
目标物种、组织、细胞类型、模型、处理条件直接命中。
间接证据:
相邻系统、相似模型、相近机制支持,但不是用户问题的直接系统。
未见直接证据:
只能找到背景、推测、综述或相邻模型,没有直接实验结果。
3.4 文献类型标注
至少标注:
• original research
• review
• protocol
• preprint
• dataset/resource
• clinical study
• method paper
3.5 排序规则
推荐排序:
1. 直接证据原始研究。
2. 关键机制研究。
3. 最新重要研究。
4. 经典奠基研究。
5. 高质量综述。
6. 间接证据。
不要只按 IF 排序。IF 是期刊层面指标,不等于单篇文献质量。
4. 回复中如何组织引用
4.1 正文引用格式
正文引用必须可点击。
格式:
```markdown
[[1. **Journal**, Year]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
```
示例:
```markdown
已有研究在人源 retinal organoids 中观察到发育阶段相关的光感受器应激和退化现象[[1. **Cell Stem Cell**, 2019]](https://pubmed.ncbi.nlm.nih.gov/xxxxxxx/)。
```
不要写成:
```text
[1]
(PMID: xxxxx)
见文献1
```
4.2 推荐回答结构
第一段:直接结论。
```text
结论:已有相关报道,但直接证据主要集中在……;关于……仍缺少直接证据。
```
第二段:证据分级。
```text
直接证据:
- 文献 A:……
间接证据:
- 文献 B:……
未见直接证据:
- 本轮未找到……
```
第三段:机制归纳。
按主题分组,例如:
• apoptosis / caspase pathway
• oxidative stress
• mitochondrial dysfunction
• ER stress
• hypoxia / metabolic stress
• inflammation
• developmental mismatch
第四段:研究空白。
明确说明哪些问题没有直接证据。
第五段:实验启发。
如果用户需要实验设计,给出 marker、assay、time point、control。
5. 文末完整文献信息列表
只要正文引用具体文献,文末必须附完整列表。
格式:
```markdown
## 完整文献信息列表
1. Smith J et al., **Journal Name** (2021), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Qn}*
2. Wang X et al., **Journal Name** (2022), [DOI: 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=待核验}*
```
作者格式:
• 1–3 位作者:列出全部。
• 超过 3 位:第一作者 et al.
PMID / DOI / URL 必须可点击。
6. IF 核查与标注
6.1 先说明 IF 核查的现实限制
正常情况下,官方 Journal Impact Factor 来自 Clarivate Journal Citation Reports(JCR)。但任意外部 Agent 通常没有 Clarivate/JCR 账号,也没有本地 JCR 表,所以不要通过这个路径核查。
```
6.2 IF skill 的实际方法
主要路线:
1. 如果输入是 PMID,先用 NCBI E-utilities 获取 PubMed metadata。
- 获取 FullJournalName。 - 获取 Source / ISO abbreviation。 - 获取 ISSN / eISSN。 - 获取标题、年份、DOI 等辅助字段。
2. 用公开的 iikx / 爱科学移动端 JSON 接口查询期刊。
搜索接口:
```text
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=<journal_query>
```
详情接口:
```text
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=<id>&classid=<classid>
```
3. 对搜索结果做保守匹配。
- 优先 exact normalized journal title match。 - 其次 exact abbreviation match。 - 对短词和宽泛词非常谨慎。 - 不接受明显 substring 误配,例如 Nature 被误配成 Nature Reviews 系列。 - 如果匹配不稳,返回 ambiguous / not_found,而不是猜。
4. 如果 PubMed 给的是缩写,尝试用 NLM Catalog 扩展为全称或 alternate title。
NLM Catalog 搜索接口仍然是 NCBI E-utilities:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=<abbr>[Title Abbreviation]&retmode=xml&retmax=1
```
然后用 ESummary 取 Title / TitleAlternate。
5. 从 iikx detail 结果中读取:
- impact factor。 - IF 年份。 - JCR quartile。 - CAS / 中科院分区,如果有。 - source URL。 - match confidence。
6. 标注时不把 IF 年份写进正文紧凑标注。
最终标注只写:
```text
*{IF=X,Qn}*
```
如果失败:
```text
*{IF=待核验}*
```
或:
```text
*{IF=未检出}*
```
6.3 具体步骤
对每篇文献执行以下流程。
第一步:准备期刊查询名。
优先从 PubMed metadata 取:
```text
FullJournalName
ISOAbbreviation / Source
ISSN
eISSN
```
如果只有 DOI,则先用 Crossref 或 OpenAlex 取期刊名。
Crossref:
```text
https://api.crossref.org/works/<DOI>
```
OpenAlex:
```text
https://api.openalex.org/works/https://doi.org/<DOI>
```
第二步:规范化期刊名。
规范化规则:
• 全部小写。
• HTML unescape。
• 将 & 替换为 and。
• 去除标点。
• 多个空格合并。
• 比较时可同时使用 compact 形式,即去除所有空格。
示例伪代码:
```python
import re, html
def norm(s):
s = html.unescape(s or '').lower()
s = re.sub(r'&', ' and ', s)
s = re.sub(r'[^a-z0-9]+', ' ', s)
return re.sub(r'\s+', ' ', s).strip()
def compact(s):
return norm(s).replace(' ', '')
```
第三步:查询 iikx 搜索接口。
```text
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=<journal_query>
```
建议设置 User-Agent,例如:
```text
Mozilla/5.0
```
如果第一页没找到 exact match,可以有限翻页,例如最多 8 页。
翻页参数通常为:
```text
page=2
page=3
```
第四步:从搜索结果中选候选。
候选字段通常包括:
```text
id
classid
title
smalltitle
IF 或 IF2024
zky2020
url
```
匹配规则:
• 如果 compact(query) == compact(candidate.title),接受。
• 如果 norm(query) == norm(candidate.title),接受。
• 如果 compact(query) == compact(candidate.smalltitle),接受。
• 如果 norm(query) == norm(candidate.smalltitle),接受。
• 如果只是 substring,不要直接接受,除非 query 足够长且无歧义。
• 对 Nature、Science、Cell、Brain、Vision、Retina 等短词尤其谨慎。
第五步:如果没有匹配,用 NLM Catalog 扩展缩写。
例如 PubMed 里 Source 是:
```text
Free Radic Biol Med
```
可以查:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=Free%20Radic%20Biol%20Med%5BTitle%20Abbreviation%5D&retmode=xml&retmax=1
```
拿到 NLM Catalog ID 后,再用:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi?db=nlmcatalog&id=<id>&retmode=xml
```
读取:
```text
Title
TitleAlternate
```
然后用这些全称再查 iikx。
第六步:查 iikx 详情接口。
如果搜索结果里有:
```text
id=<id>
classid=<classid>
```
调用:
```text
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=<id>&classid=<classid>
```
从 detail 中读取:
```text
IF2024, IF2023, IF2022 ...
IF
zky2020 或其他 JCR quartile 字段
jcr22 / jcr12 或分区字段
issn
eissn
title
smalltitle
category
```
第七步:选择最新 IF。
在返回字段中查找所有形如:
```text
IF20xx
```
例如:
```text
IF2024
IF2023
IF2022
```
选年份最大的有效数字。
如果没有 IF20xx,则尝试读取:
```text
IF
if_value
```
如果没有有效值,则标为未检出。
第八步:输出置信度和标注。
如果 exact title / abbreviation 命中,并且 detail 返回有效 IF:
```text
*{IF=X,Qn}*
```
如果匹配不确定:
```text
*{IF=待核验}*
```
如果公开接口没有结果:
```text
*{IF=未检出}*
```
6.4 IF 标注格式
固定格式:
```text
*{IF=X,Qn}*
```
示例:
```markdown
Smith J et al., **Neuron** (2020), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=15.0,Q1}*
```
注意:
• IF 标注内部不写 JCR 年份。
• 不写“2024 JCR IF”。
• 不写“JCR 2024”。
• 年份只保留在文献发表年份处。
• 如果 IF 为 0.0、空值、来源不稳、匹配不稳,不展示数字。
6.5 IF 核查失败时的标准处理
不要猜。
不要用期刊名印象补数字。
不要用大模型记忆补 IF。
失败时只允许三种状态:
```text
*{IF=待核验}*
```
用于:
• 搜索结果模糊。
• 有多个相似期刊。
• 只找到缩写但无法确认全称。
• 公开来源返回的 IF 可疑。
```text
*{IF=未检出}*
```
用于:
• 公开接口没有结果。
• 期刊不在 SCI / JCR 覆盖范围。
• 新刊暂无 IF。
```text
*{IF=不可公开核验}*
```
用于:
• 用户要求必须官方 JCR,但当前 Agent 没有 Clarivate/JCR 权限。
7. 最终回复自检清单
发出前必须检查:
• 是否先回答用户核心问题。
• 是否区分直接证据、间接证据、未见直接证据。
• 是否所有正文引用都可点击。
• 是否文末有完整文献信息列表。
• 是否每篇文献都带 IF 标注或待核验/未检出标注。
• PMID/DOI/URL 是否可点击。
• 是否避免把整体组织结果偷换成特定细胞类型结论。
• 是否避免把活化/磷酸化偷换成总表达量升高。
• 是否标注预印本。
• 是否说明检索边界。
• IF 是否没有凭记忆猜测。
8. 可复现伪代码
```python
queries = build_queries(user_question)
all_pmids = []
for query in queries:
pmids = ncbi_esearch(query, retmax=20, sort='relevance')
all_pmids.extend(pmids)
pmids = deduplicate_keep_order(all_pmids)
metadata = ncbi_esummary(pmids)
abstracts = ncbi_efetch_abstract(pmids)
records = merge_metadata_and_abstracts(metadata, abstracts)
records = tag_evidence(records, user_question)
records = rank_records(records)
selected = select_top_records(records)
if need_fulltext:
for record in selected_key_records:
pmcid = idconv_pmid_to_pmcid(record.pmid)
if pmcid:
record.fulltext = fetch_bioc_or_pmc_xml(pmcid)
for record in selected:
journal_query = record.full_journal_name or record.journal_abbrev
if_result = lookup_if_public_iikx(journal_query)
if if_result.confident:
record.if_annotation = f'*{IF={if_result.if_value},{if_result.quartile}}*'
elif if_result.ambiguous:
record.if_annotation = '*{IF=待核验}*'
else:
record.if_annotation = '*{IF=未检出}*'
answer = compose_answer(
conclusion,
evidence_groups,
clickable_body_citations,
full_reference_list_with_if
)
```
9. 推荐最终交付模板
```markdown
结论:
……
证据等级:
直接证据:
- ……[[1. **Journal**, Year]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
间接证据:
- ……[[2. **Journal**, Year]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
未见直接证据:
- ……
机制归纳:
1. ……
2. ……
检索边界:
本轮主要检索 PubMed / PMC / BioC / bioRxiv;初筛基于 metadata + abstract,仅对关键文献进入全文复核。IF 标注基于公开可访问来源核查;无法高置信匹配时标为待核验或未检出。
完整文献信息列表:
1. Smith J et al., **Journal Name** (2021), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Q1}*
2. Wang X et al., **Journal Name** (2022), [DOI: 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=待核验}*
```
الوصف
موصى بها من قبل
Nico@YouMind
لماذا نحب هذه المهارة
هذه المهارة هي دليل موثوق للبحث في الطب الحيوي، تضمن معلومات دقيقة وقابلة للتحقق عبر استعلام منظم وفحص متعدد المراحل وتدقيق صارم لمعامل التأثير (IF).
سيناريوهات التطبيق: إكمال جولة من البحث في الأدبيات العلمية في مجال البيولوجيا/الطب الحيوي وتقديم مخرجات مفصلة وموثوقة للمستخدم. 1. بعد إجراء المستخدم للبحث، يقوم النظام بتحليل المشكلة والكلمات المفتاحية. 2. استخدام مصادر بيانات عامة وقابلة للتكرار للبحث في الأدبيات. 3. إزالة التكرار، التصنيف، تقسيم الأدلة، وترتيب نتائج البحث. 4. في الرد، استخدم الاستشهادات القابلة للنقر من النص. 5. في النهاية، قائمة كاملة بمعلومات الأدبيات واحدًا تلو الآخر، مع ذكر عامل التأثير (IF) باستخدام مسار يمكن التحقق منه علنًا؛ إذا تعذر التحقق بثقة عالية، يجب وضع علامة "قيد التحقق" أو "غير مكتشف".
مهارات ذات صلة
عرض الكل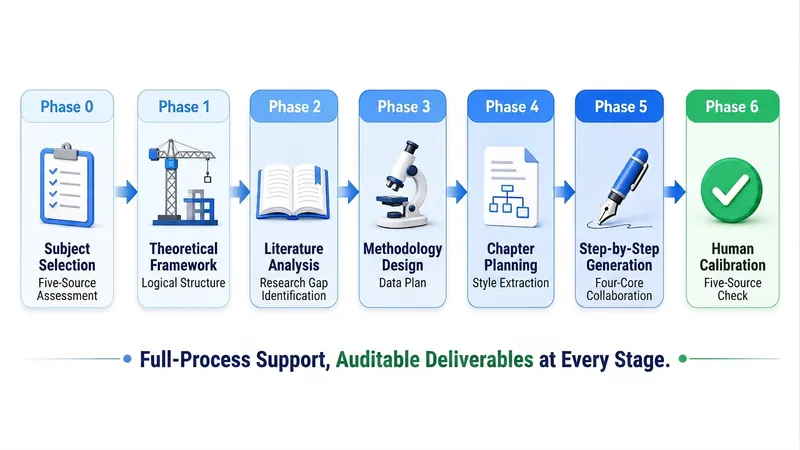
مدقق خطة البحث·جاهزية المصادر
قبل أن تستثمر عشرات الساعات في كتابة بحثك، خذ عشر دقائق لإجراء فحص منظم. 【هذه المهارة تقوم بشيء واحد فقط】 التشخيص، لا الكتابة نيابة عنك. تخبرك ما إذا كان موضوعك قابلًا للصمود، وما إذا كانت المواد كافية، وما الذي ينقصك، وأين تجده، وبأي ترتيب تكمله، ثم تقدم لك قائمة تكميلية قابلة للتنفيذ وصيغة بحث. لن تكتب عنك المقدمة أو المراجعة أو المنهجية أو المناقشة. 【المراحل الأربع】 1. تشخيص التخصص: تصنيف حسب الفئات الأربع: 1A فنون وعلوم إنسانية / 1B علوم اجتماعية / 2A علوم وهندسة / 2B زراعة وطب وعلوم الحياة، مع تحميل الخطوط الحمراء التنظيمية المقابلة؛ والفئة 2B تفرض مراجعة أخلاقية إلزامية. 2. فحص الموضوع: فحص الموضوع من ثلاثة أبعاد: «الزخم·الشكل·المصطلحات»، لتحديد ما إذا كانت وحدة البحث قابلة للتشغيل، وما إذا كان سؤال البحث قابلًا للإجابة، وما إذا كان الموضوع قد نُفد. 3. فحص المواد: تسجيل المراجع المتوفرة لديك في مكتبة مواد M1/M2...، والتحقق من أربعة عناصر لكل بند (المؤلف/السنة/العنوان/معرف التحقق)، وحساب نسبة التغطية الفعلية. 4. قائمة الثغرات وصيغة البحث: تحديد عدد ونوع المراجع المفقودة، وأي ركن من الأدلة مفقود، وتقديم صيغة بحث يمكن لصقها مباشرة في قواعد البيانات (بما في ذلك مجموعة الكلمات الرئيسية مع العوامل المنطقية، والنطاق الزمني، ومعايير التصفية). 【متى تستخدمها】 (كلمات تنشيطية) «ساعدني في فحص خطة البحث»، «هل يمكن العمل على هذا الموضوع؟»، «هل لدي ما يكفي من المراجع؟»، «تم إرجاع تقرير خطة البحث»، «أريد التأكد قبل البدء في الكتابة» — طلاب الدراسات العليا الذين حددوا اتجاههم للتو ولم يبدأوا الكتابة؛ ومن أُعيد تقرير خطتهم دون معرفة السبب؛ ومن جمعوا الكثير من المراجع لكنهم غير متأكدين من كفايتها؛ ومن يريدون التحقق من جدوى الموضوع قبل استثمار الوقت فيه. 【المخرجات】 مستند «تقرير فحص خطة البحث» + بطاقة تقييم جاهزية المصادر الخمسة (لكل فئة معايير تقييم سلوكية، وليس درجات غامضة) + قائمة أولويات المواد المطلوبة + صيغة البحث + رمز أرشيفي. رمز الأرشفة متوافق مع «学术论文全流程撰写系统 v4.0»، وبعد الفحص يمكنك لصقه مباشرة لمواصلة الكتابة دون إعادة تحديد التخصص أو الموضوع أو المجلة. 【ما لا تفعله بوضوح】 لا تكتب النص الكامل، ولا تنشئ قائمة المراجع، ولا تختلق المؤلفين أو السنوات أو المجلدات أو الصفحات أو أرقام DOI. جميع المراجع التي يتم العثور عليها عبر الإنترنت تُوسم بـ ⚠️ بحاجة إلى تحقق، ويجب عليك التحقق منها بنفسك قبل الاستخدام. هذه المهارة لا تضمن أي قبول أو اجتياز.
 بحث
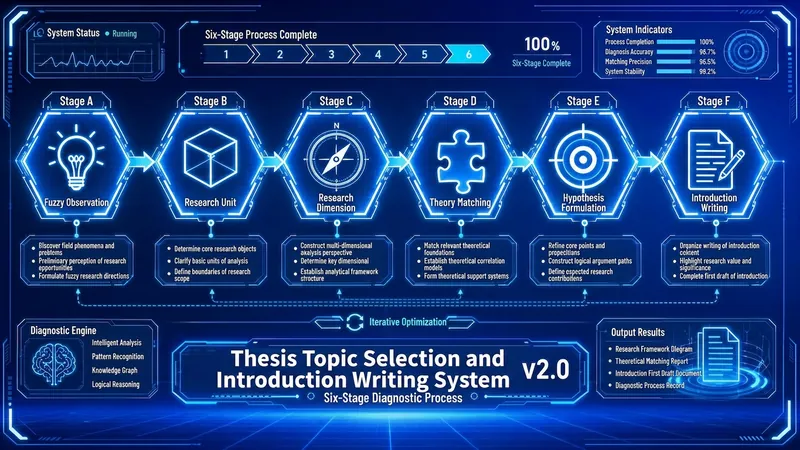
نظام الموضوع والمقدمة v3.2
10 ثوانٍ للفهم: يحوّل ملاحظة غامضة إلى موضوع قابل للدفاع، ثم إلى مقدمة قابلة للقبول. طوال الوقت، يستخدم فقط موادك الحقيقية دون اختلاق أي مرجع. كلمات الاستدعاء: اختيار موضوع البحث، اختيار الموضوع، المقدمة، الفجوة البحثية، الكتابة الأكاديمية، مقترح التخرج، اختيار الموضوع قبل مراجعة الأدبيات. مناسب لـ: أوراق المجلات / الرسائل الجامعية / أوراق المؤتمرات / أوراق المقررات، في كل التخصصات الإنسانية والاجتماعية والهندسية والزراعية والطبية. يمكنك البدء في 3 دقائق: حدد التخصص ونقطة البداية → شكل الموضوع تدريجيًا → بوابة الأدلة الإلزامية → مقدمة معيارية → صياغة نهائية متصاعدة. 【التقسيم مع المهارات الأخرى】 الفحص أولاً، والكتابة لاحقًا، والتنقيح أخيرًا. هذه المهارة تتولى الجزء الأوسط: تشكيل الموضوع + المسودة الأولى للمقدمة. وهي لا تكتب النص الكامل (هذا من «نظام الكتابة الكاملة للأوراق الأكاديمية v4.x»)، ولا تقوم بالتحسين اللغوي جملةً جملةً (هذا من «نظام التنقيح ثلاثي المسارات للأوراق الأكاديمية v8.x»). 【المراحل الست】 1. تصنيف التخصص: 1A الفنون والإنسانيات / 1B العلوم الاجتماعية / 2A العلوم الهندسية / 2B الزراعة والطب وعلوم الحياة — أربع فئات، مع تحميل الخطوط الحمراء التنظيمية المقابلة؛ الفئة 2B يُسأل إجباريًا عن حالة الموافقة الأخلاقية. 2. تحديد المرحلة: هل أنت في ملاحظة غامضة، لديك وحدة بلا زاوية، لديك موضوع بلا نظرية، تفتقد المنهج، تفتقد وجهة النظر، أم تفتقد المقدمة فقط؟ — ابدأ من البوابة المناسبة، ولا تبدأ من الصفر. 3. تشكيل الموضوع: وحدة البحث → بوصلة الأبعاد → منظور نظري → منهج البحث → وجهة نظر البحث، وتُثبَّت كل طبقة بعد التأكد من أن الطبقة السابقة راسخة. 4. بوابة الأدلة الإلزامية: قبل المقدمة، يُسجّل أدبك إجباريًا في مكتبة مواد M1/M2…، ويُتحقق من كل عنصر: المؤلف/السنة/عنوان الورقة/المعرّف؛ إذا كان عدد الإدخالات أقل من 3، يرفض النظام توليد بيان الفجوة البحثية — ليس تخفيضًا، بل رفضًا. 5. توليد معياري: تُنتج المقدمة في خمس وحدات وفق هرم مقلوب، كل وحدة تحمل رقم الاستشهاد [Mn]، ولا يُكتب أي جملة بدون مصدر. 6. الصياغة النهائية المتصاعدة: تُضاف النقاط فقط على النسخ المجتازة، وتُقفل الوحدات المستوفاة فلا تُعدّل، والدرجات ترتفع فقط ولا تنخفض. 【المخرجات】 مستند «[كلمة مفتاحية للموضوع]·الموضوع والمقدمة» + جدول تتبع الاستشهادات جملةً بجملة + قائمة ⚠️ للتحقق + كود أرشيف AFP. كود الأرشيف متوافق مع فاحص الافتتاحية ونظام v4.x الكامل ونظام التنقيح ثلاثي المسارات، وعند تغيير المهارة لا تحتاج إلى إعادة شرح التخصص أو الموضوع أو المجلة أو مكتبة المواد. 【ما لا نفعله بوضوح】 لا نختلق المؤلفين أو السنوات أو المجلدات أو الأعداد أو صفحات أو DOI؛ جميع العناوين المسترجعة عبر الإنترنت تُوسم بـ ⚠️ للتحقق، ويجب عليك التحقق منها قبل إدراجها في قائمة المراجع؛ لا نعد بأي قبول أو نتيجة مراجعة. التوقيع والمسؤولية عليك — يرجى التحقق من كل استشهاد وبيان بدقة.
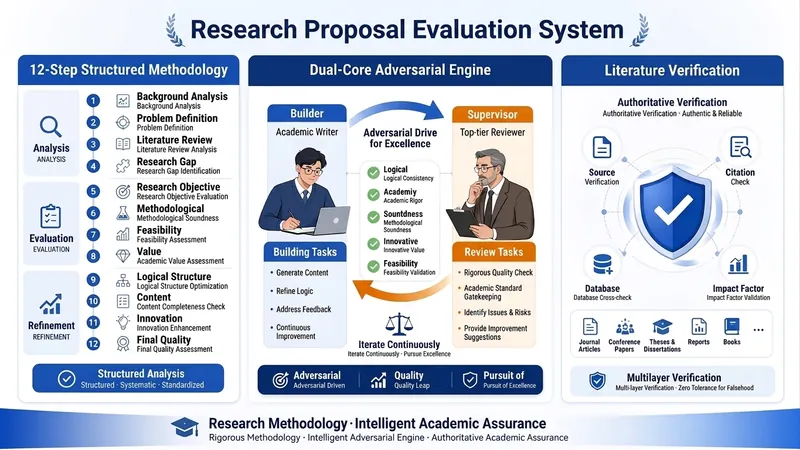
مراجعة وتحسين البحث PRO V2.0
🎯 نظرة عامة على الوظائف الأساسية هذا نظام ذكي لمراجعة وتحسين مقترحات المشاريع البحثية الوطنية (وزارة التعليم، المقاطعات)، يحاكي نمط تفكير خبير تقييم يتمتع بخبرة 15 عامًا، عبر ثلاث آليات أساسية تضمن الدقة الأكاديمية والتنافسية. 🔧 ثلاث آليات أساسية 1️⃣ منهجية هيكلية من 12 خطوة تغطي دورة حياة مراجعة مقترح المشروع بالكامل: المرحلة 1-3: التشخيص الأساسي - تحليل عميق للإعلان (توجهات التمويل، معايير التقييم، متطلبات التقديم) - تحديد نوع التخصصات البينية (8 أنواع بدقة) - تحديد فجوات البحث عبر 5 أبعاد (نظري/منهجي/تجريبي/سياسي/تقني) المرحلة 4-7: تقييم العناصر الأساسية - تحليل مشكلة البحث بنموذج TMAQ (النظرية، المنهج، الفكرة، المشكلة) - اختبار أهداف البحث وفق مبدأ SMART - تقييم شمولية إطار المحتوى البحثي - مطابقة نوع منهجية البحث (6 أنواع) المرحلة 8-10: تحسين الجودة العميق - تحديد النقاط الصعبة بدقة (معيار التمييز + مسار الاختراق) - استخراج نقاط الابتكار عبر 7 أبعاد - إثبات الجدوى عبر 7 أبعاد المرحلة 11-12: التحسين الشامل - فحص الجودة عبر 9 أبعاد (الدقة الأكاديمية، الابتكار، الجدوى...) - توصيات تحسين شاملة وتقرير نهائي 2️⃣ آلية المواجهة ثنائية النواة (Builder vs Supervisor) آلية العمل: - Builder (كاتب أكاديمي): يولد خطط تحسين بناءً على مواد المستخدم - Supervisor (مراجع من مجلة رفيعة): يتحدى خطط Builder بأعلى معايير الصرامة - التكرار المواجه: عبر 3 جولات لضمان متانة الخطة سيناريوهات التطبيق: - استخراج نقاط الابتكار: Builder يقترح → Supervisor يشكك في الجدة → تحسين متكرر - إثبات الجدوى: Builder يصمم خطة → Supervisor يتحدى الجدوى → إثبات إضافي - الاستشهاد بالمراجع: Builder يستشهد → Supervisor يتحقق من الصحة → ضمان الالتزام الأكاديمي 3️⃣ آلية التحقق من صحة المراجع نمطان للعمل: النمط أ: نمط العناصر النائبة (افتراضي) - استخدام علامات مثل [مكان-المرجع-001] بدلاً من المراجع المحددة - إخراج قائمة المراجع المطلوبة، توضح متطلبات البحث لكل عنصر نائب - يقوم المستخدم بالبحث وملء المراجع الحقيقية النمط ب: نمط التحقق الفوري - استدعاء Google Scholar للتحقق الفوري من صحة المراجع - توليد تقرير التحقق من المراجع (درجة الصحة/الملاءمة/الموثوقية) - ضمان إمكانية تتبع كل استشهاد منع الهلوسة الاصطناعية: - منع اختلاق المؤلفين والمجلات وDOI - يجب التحقق من جميع المراجع أو وضع علامة عليها كعناصر نائبة - ضمان النزاهة الأكاديمية 💡 القيمة الأساسية وسيناريوهات الاستخدام ✅ المشكلات الأساسية التي يحلها 1. عدم الدقة الأكاديمية: محتوى AI يظهر مراجع وهمية وثغرات منطقية 2. نقص الابتكار: صعوبة اكتشاف نقاط الابتكار الأكاديمية الحقيقية 3. ضعف الجدوى: نقص الإثبات المنهجي لخطة البحث 4. صعوبة التخصصات البينية: اختيار الموضوعات البينية غير متوازن 🎓 المستخدمون المستهدفون - أساتذة الجامعات (العلوم الاجتماعية، التربية، العلوم الإنسانية) - الباحثون (تقديم مشاريع وطنية ومقاطعات) - الفرق الأكاديمية (بحاجة لعمليات مراجعة منهجية) 📋 سير العمل النموذجي 1. الإدخال: تحميل إعلان المشروع + مسودة المقترح 2. المراجعة: تنفيذ التحليل الهيكلي المكون من 12 خطوة 3. المواجهة: تحسين الأجزاء الرئيسية بتكرار الآلية ثنائية النواة 4. التحقق: فحص صحة المراجع 5. الإخراج: تقرير مراجعة كامل + توصيات تحسين + قائمة مراجع 🔍 الفرق عن التقييم التقليدي | البعد | التقييم التقليدي البشري | نظام التقييم الخبير | |--------|------------------------|---------------------| | عمق التقييم | يعتمد على الخبرة الشخصية | 12 خطوة هيكلية + 9 أبعاد جودة | | الدقة الأكاديمية | صعوبة الفحص الشامل | تحقق مراجع + مواجهة مزدوجة | | اكتشاف الابتكار | حكم ذاتي | تحليل منهجي من 7 أبعاد | | إثبات الجدوى | مدفوع بالخبرة | إثبات مكون من 7 أبعاد | | الاتساق | يختلف حسب الشخص | عملية موحدة | | الكفاءة | أيام إلى أسابيع | 1-2 ساعة للتقييم الأولي | الميزة الأساسية لهذا النظام: تحويل المعرفة الضمنية لخبير تقييم يتمتع بخبرة 15 عامًا إلى معرفة واضحة ومنظمة وقابلة للتكرار، مما يمنح كل مستخدم خدمة تقييم على مستوى الخبراء.
بحث عميق وموثوق في الطب/البيولوجيا
التعليمات
这套流程的核心是:先用多 query 在 PubMed / NCBI E-utilities 做可复现初筛,再用 PMID 去重和摘要证据分级;只有少量关键文献进入 PMC / BioC 全文复核;正文引用必须可点击;文末必须列完整文献信息;IF 只能通过公开可访问来源保守核查,不能默认有 JCR 或本地数据库,不能猜,不能把低置信匹配当成确定结果。
1. 用户发起检索后的预处理
1.1 先解析用户问题
收到用户问题后,先把自然语言问题拆成结构化要素。
必须识别:
• 研究对象:基因、蛋白、药物、通道、细胞类型、组织、疾病、模型。
• 生物系统:人、小鼠、大鼠、斑马鱼、类器官、视网膜、脑区、细胞系等。
• 关系类型:表达、调控、功能、机制、表型、死亡、生存、治疗、毒性、发育、退化等。
• 证据需求:是否需要直接证据、机制证据、全文证据、图表、剂量参数、实验方法。
• 时间范围:不限时间、近 5 年、近 1 年、最新进展、经典文献。
• 输出类型:简答、代表文献、综述式总结、实验设计建议、证据表、机制图谱。
示例:
用户问题:
“帮我找视网膜类器官死亡相关文献。”
结构化拆解(示例):
• 核心模型:retinal organoid, retina organoid, hPSC-derived retinal organoid, optic cup organoid。
• 表型:cell death, apoptosis, degeneration, survival loss, stress, necrosis。
• 相关细胞:photoreceptor, cone, rod, retinal ganglion cell, Müller glia。
• 潜在机制:oxidative stress, ER stress, mitochondrial dysfunction, hypoxia, inflammation, ferroptosis, necroptosis。
• 证据目标:优先找直接在人源或动物源 retinal organoid 中观察到细胞死亡/凋亡/退化的原始研究;再找间接机制文献。
1.2 关键词拆分原则(示例)
不要只写一个检索式。每个概念至少准备三类词。
第一类:精确词。
• retinal organoid
• retina organoid
• human retinal organoid
• hPSC-derived retinal organoid
• iPSC-derived retinal organoid
第二类:同义词和上位词。
• optic cup organoid
• 3D retinal culture
• stem cell-derived retina
• retinal differentiation
• retinal tissue model
第三类:机制和表型词。
• apoptosis
• cell death
• degeneration
• survival
• stress
• oxidative stress
• ER stress
• mitochondrial dysfunction
• hypoxia
• necroptosis
• ferroptosis
如果用户限定细胞类型,加入:
• photoreceptor
• cone
• rod
• retinal ganglion cell
• Müller glia
• bipolar cell
• amacrine cell
如果用户限定物种或来源,加入:
• human
• mouse
• rat
• zebrafish
• hESC
• iPSC
• pluripotent stem cell
1.3 生成分层检索式
至少生成 3–6 组 query。每组 query 对应一个检索目的。
第一层:直接证据检索。
用于找目标模型 + 目标表型直接命中的文献。
```text
("retinal organoid" OR "retina organoid" OR "human retinal organoid") AND (apoptosis OR "cell death" OR degeneration)
```
第二层:扩展模型检索。
用于捕捉作者没有使用 retinal organoid 精确词但实际相关的文献。
```text
("optic cup organoid" OR "3D retinal culture" OR "stem cell-derived retina") AND (survival OR apoptosis OR stress)
```
第三层:机制专项检索。
用于验证具体通路或机制。
```text
("retinal organoid" OR "retina organoid") AND ("oxidative stress" OR "ER stress" OR hypoxia OR mitochondria)
```
第四层:细胞类型专项检索。
```text
("retinal organoid" OR "retina organoid") AND (photoreceptor OR cone OR rod OR "retinal ganglion cell") AND (death OR apoptosis OR degeneration)
```
第五层:疾病模型检索。
```text
("retinal organoid" OR "retina organoid") AND (disease OR degeneration OR dystrophy OR retinitis OR glaucoma)
```
第六层:综述/背景检索。
```text
("retinal organoid" OR "retina organoid") AND (review OR protocol OR model)
```
2. 使用什么方法、在什么网站检索
2.1 首选:PubMed / NCBI E-utilities
PubMed 是生物医学文献检索首选。不要默认抓 PubMed 网页。应使用 NCBI E-utilities API。
2.1.1 ESearch:用 query 获取 PMID
接口:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi
```
参数:
```text
db=pubmed
term=<检索式>
retmode=json
retmax=20
sort=relevance
```
也可按时间排序:
```text
sort=pub+date
```
示例:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=pubmed&term=(%22retinal%20organoid%22%20OR%20%22retina%20organoid%22)%20AND%20(apoptosis%20OR%20%22cell%20death%22)&retmode=json&retmax=20&sort=relevance
```
返回中读取:
```text
esearchresult.idlist
```
这就是 PMID 列表。
2.1.2 ESummary:获取文献 metadata
接口:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi
```
参数:
```text
db=pubmed
id=PMID1,PMID2,PMID3
retmode=json
```
提取字段:
• PMID
• title
• fulljournalname
• source / journal abbreviation
• pubdate
• authors
• articleids 中的 DOI、PMCID
• volume、issue、pages
2.1.3 EFetch:获取摘要和 XML 细节
接口:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/efetch.fcgi
```
参数:
```text
db=pubmed
id=PMID1,PMID2
retmode=xml
rettype=abstract
```
提取字段:
• ArticleTitle
• AbstractText
• Journal Title
• ISOAbbreviation
• ISSN / eISSN
• PubDate
• DOI
• PMCID
• MeSH terms
2.1.4 批量检索策略
推荐流程:
1. 对每个 query 调用 ESearch。
2. 每个 query 取前 5–20 篇。
3. 合并所有 PMID。
4. 按 PMID 去重。
5. 用 ESummary / EFetch 批量获取 metadata 和 abstract。
6. 初筛阶段只读 metadata + abstract,不要一开始抓全文。
────────────────
2.2 第二阶段:PMC / BioC 全文复核
只有以下情况才进入全文:
• 用户要求精读全文。
• 摘要不足以判断机制。
• 需要图表、实验方法、浓度、剂量、IC50、EC50、Kd、Ki。
• 已筛出少量关键 PMID,需要逐篇机制复核。
2.2.1 PMID 转 PMCID
接口:
```text
https://www.ncbi.nlm.nih.gov/pmc/utils/idconv/v1.0/?ids=<PMID>&format=json
```
如果返回 PMCID,说明可能有 PMC 开放全文。
2.2.2 优先 BioC JSON
接口:
```text
https://www.ncbi.nlm.nih.gov/research/bionlp/RESTful/pmcoa.cgi/BioC_json/<PMCID>/unicode
```
优点:结构化程度高,适合抽取正文段落。
2.2.3 BioC 不可用时尝试 PMC XML
接口:
```text
https://www.ncbi.nlm.nih.gov/pmc/articles/<PMCID>/?report=xml
```
抽取正文时跳过:
• references
• bibliography
• acknowledgements
• author contributions
• competing interests
全文复核必须设置停止判据:
• 每篇文献只扫描一次。
• 默认只抽取与问题相关的段落。
• 如果未命中目标字段,标注“未见直接证据”。
• 不要无限换关键词重复抓取。
────────────────
2.3 bioRxiv / medRxiv
用于补充最新预印本。
可以使用官方 API:
```text
https://api.biorxiv.org/details/biorxiv/YYYY-MM-DD/YYYY-MM-DD
https://api.biorxiv.org/details/medrxiv/YYYY-MM-DD/YYYY-MM-DD
```
也可用普通搜索作为补充:
```text
site:biorxiv.org retinal organoid apoptosis
site:medrxiv.org retina organoid degeneration
```
预印本必须标注:
```text
预印本,未经同行评议。
```
────────────────
2.4 Crossref / OpenAlex / Unpaywall
用于补全 DOI、开放全文地址、出版信息。
Crossref:
```text
https://api.crossref.org/works?query.title=<title>
```
OpenAlex:
```text
https://api.openalex.org/works?search=<title or topic>
```
Unpaywall:
```text
https://api.unpaywall.org/v2/<DOI>?email=<your_email>
```
用途:
• DOI 补全。
• OA PDF 链接查找。
• 期刊名核验。
• 出版年份核验。
────────────────
2.5 出版商页面
只有在 API 信息不足时才访问出版商页面。
访问规则:
• 每个出版商 URL 只尝试一次。
• 遇到验证码、登录墙、Cloudflare、Access Denied、机构权限墙,立即停止。
• 不要反复刷新、换同站路径、循环等待。
• 改用 PubMed、PMC、Crossref、OpenAlex、Unpaywall、DOI metadata 兜底。
3. 检索后如何整理信息
3.1 建立统一记录结构
每篇文献整理成统一 record。
字段:
```text
pmid
doi
pmcid
title
authors
journal
journal_abbrev
issn
eissn
year
abstract
query_source
evidence_level
evidence_tags
paper_type
url
```
3.2 去重
优先级:
1. PMID 去重。
2. 没有 PMID 时用 DOI 去重。
3. 没有 DOI 时用 lower(title) + year + first_author 去重。
保留第一次命中的 query_source,同时记录该文献被哪些 query 命中。
3.3 证据分级
必须区分:
直接证据:
目标物种、组织、细胞类型、模型、处理条件直接命中。
间接证据:
相邻系统、相似模型、相近机制支持,但不是用户问题的直接系统。
未见直接证据:
只能找到背景、推测、综述或相邻模型,没有直接实验结果。
3.4 文献类型标注
至少标注:
• original research
• review
• protocol
• preprint
• dataset/resource
• clinical study
• method paper
3.5 排序规则
推荐排序:
1. 直接证据原始研究。
2. 关键机制研究。
3. 最新重要研究。
4. 经典奠基研究。
5. 高质量综述。
6. 间接证据。
不要只按 IF 排序。IF 是期刊层面指标,不等于单篇文献质量。
4. 回复中如何组织引用
4.1 正文引用格式
正文引用必须可点击。
格式:
```markdown
[[1. **Journal**, Year]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
```
示例:
```markdown
已有研究在人源 retinal organoids 中观察到发育阶段相关的光感受器应激和退化现象[[1. **Cell Stem Cell**, 2019]](https://pubmed.ncbi.nlm.nih.gov/xxxxxxx/)。
```
不要写成:
```text
[1]
(PMID: xxxxx)
见文献1
```
4.2 推荐回答结构
第一段:直接结论。
```text
结论:已有相关报道,但直接证据主要集中在……;关于……仍缺少直接证据。
```
第二段:证据分级。
```text
直接证据:
- 文献 A:……
间接证据:
- 文献 B:……
未见直接证据:
- 本轮未找到……
```
第三段:机制归纳。
按主题分组,例如:
• apoptosis / caspase pathway
• oxidative stress
• mitochondrial dysfunction
• ER stress
• hypoxia / metabolic stress
• inflammation
• developmental mismatch
第四段:研究空白。
明确说明哪些问题没有直接证据。
第五段:实验启发。
如果用户需要实验设计,给出 marker、assay、time point、control。
5. 文末完整文献信息列表
只要正文引用具体文献,文末必须附完整列表。
格式:
```markdown
## 完整文献信息列表
1. Smith J et al., **Journal Name** (2021), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Qn}*
2. Wang X et al., **Journal Name** (2022), [DOI: 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=待核验}*
```
作者格式:
• 1–3 位作者:列出全部。
• 超过 3 位:第一作者 et al.
PMID / DOI / URL 必须可点击。
6. IF 核查与标注
6.1 先说明 IF 核查的现实限制
正常情况下,官方 Journal Impact Factor 来自 Clarivate Journal Citation Reports(JCR)。但任意外部 Agent 通常没有 Clarivate/JCR 账号,也没有本地 JCR 表,所以不要通过这个路径核查。
```
6.2 IF skill 的实际方法
主要路线:
1. 如果输入是 PMID,先用 NCBI E-utilities 获取 PubMed metadata。
- 获取 FullJournalName。 - 获取 Source / ISO abbreviation。 - 获取 ISSN / eISSN。 - 获取标题、年份、DOI 等辅助字段。
2. 用公开的 iikx / 爱科学移动端 JSON 接口查询期刊。
搜索接口:
```text
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=<journal_query>
```
详情接口:
```text
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=<id>&classid=<classid>
```
3. 对搜索结果做保守匹配。
- 优先 exact normalized journal title match。 - 其次 exact abbreviation match。 - 对短词和宽泛词非常谨慎。 - 不接受明显 substring 误配,例如 Nature 被误配成 Nature Reviews 系列。 - 如果匹配不稳,返回 ambiguous / not_found,而不是猜。
4. 如果 PubMed 给的是缩写,尝试用 NLM Catalog 扩展为全称或 alternate title。
NLM Catalog 搜索接口仍然是 NCBI E-utilities:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=<abbr>[Title Abbreviation]&retmode=xml&retmax=1
```
然后用 ESummary 取 Title / TitleAlternate。
5. 从 iikx detail 结果中读取:
- impact factor。 - IF 年份。 - JCR quartile。 - CAS / 中科院分区,如果有。 - source URL。 - match confidence。
6. 标注时不把 IF 年份写进正文紧凑标注。
最终标注只写:
```text
*{IF=X,Qn}*
```
如果失败:
```text
*{IF=待核验}*
```
或:
```text
*{IF=未检出}*
```
6.3 具体步骤
对每篇文献执行以下流程。
第一步:准备期刊查询名。
优先从 PubMed metadata 取:
```text
FullJournalName
ISOAbbreviation / Source
ISSN
eISSN
```
如果只有 DOI,则先用 Crossref 或 OpenAlex 取期刊名。
Crossref:
```text
https://api.crossref.org/works/<DOI>
```
OpenAlex:
```text
https://api.openalex.org/works/https://doi.org/<DOI>
```
第二步:规范化期刊名。
规范化规则:
• 全部小写。
• HTML unescape。
• 将 & 替换为 and。
• 去除标点。
• 多个空格合并。
• 比较时可同时使用 compact 形式,即去除所有空格。
示例伪代码:
```python
import re, html
def norm(s):
s = html.unescape(s or '').lower()
s = re.sub(r'&', ' and ', s)
s = re.sub(r'[^a-z0-9]+', ' ', s)
return re.sub(r'\s+', ' ', s).strip()
def compact(s):
return norm(s).replace(' ', '')
```
第三步:查询 iikx 搜索接口。
```text
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=<journal_query>
```
建议设置 User-Agent,例如:
```text
Mozilla/5.0
```
如果第一页没找到 exact match,可以有限翻页,例如最多 8 页。
翻页参数通常为:
```text
page=2
page=3
```
第四步:从搜索结果中选候选。
候选字段通常包括:
```text
id
classid
title
smalltitle
IF 或 IF2024
zky2020
url
```
匹配规则:
• 如果 compact(query) == compact(candidate.title),接受。
• 如果 norm(query) == norm(candidate.title),接受。
• 如果 compact(query) == compact(candidate.smalltitle),接受。
• 如果 norm(query) == norm(candidate.smalltitle),接受。
• 如果只是 substring,不要直接接受,除非 query 足够长且无歧义。
• 对 Nature、Science、Cell、Brain、Vision、Retina 等短词尤其谨慎。
第五步:如果没有匹配,用 NLM Catalog 扩展缩写。
例如 PubMed 里 Source 是:
```text
Free Radic Biol Med
```
可以查:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=Free%20Radic%20Biol%20Med%5BTitle%20Abbreviation%5D&retmode=xml&retmax=1
```
拿到 NLM Catalog ID 后,再用:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi?db=nlmcatalog&id=<id>&retmode=xml
```
读取:
```text
Title
TitleAlternate
```
然后用这些全称再查 iikx。
第六步:查 iikx 详情接口。
如果搜索结果里有:
```text
id=<id>
classid=<classid>
```
调用:
```text
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=<id>&classid=<classid>
```
从 detail 中读取:
```text
IF2024, IF2023, IF2022 ...
IF
zky2020 或其他 JCR quartile 字段
jcr22 / jcr12 或分区字段
issn
eissn
title
smalltitle
category
```
第七步:选择最新 IF。
在返回字段中查找所有形如:
```text
IF20xx
```
例如:
```text
IF2024
IF2023
IF2022
```
选年份最大的有效数字。
如果没有 IF20xx,则尝试读取:
```text
IF
if_value
```
如果没有有效值,则标为未检出。
第八步:输出置信度和标注。
如果 exact title / abbreviation 命中,并且 detail 返回有效 IF:
```text
*{IF=X,Qn}*
```
如果匹配不确定:
```text
*{IF=待核验}*
```
如果公开接口没有结果:
```text
*{IF=未检出}*
```
6.4 IF 标注格式
固定格式:
```text
*{IF=X,Qn}*
```
示例:
```markdown
Smith J et al., **Neuron** (2020), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=15.0,Q1}*
```
注意:
• IF 标注内部不写 JCR 年份。
• 不写“2024 JCR IF”。
• 不写“JCR 2024”。
• 年份只保留在文献发表年份处。
• 如果 IF 为 0.0、空值、来源不稳、匹配不稳,不展示数字。
6.5 IF 核查失败时的标准处理
不要猜。
不要用期刊名印象补数字。
不要用大模型记忆补 IF。
失败时只允许三种状态:
```text
*{IF=待核验}*
```
用于:
• 搜索结果模糊。
• 有多个相似期刊。
• 只找到缩写但无法确认全称。
• 公开来源返回的 IF 可疑。
```text
*{IF=未检出}*
```
用于:
• 公开接口没有结果。
• 期刊不在 SCI / JCR 覆盖范围。
• 新刊暂无 IF。
```text
*{IF=不可公开核验}*
```
用于:
• 用户要求必须官方 JCR,但当前 Agent 没有 Clarivate/JCR 权限。
7. 最终回复自检清单
发出前必须检查:
• 是否先回答用户核心问题。
• 是否区分直接证据、间接证据、未见直接证据。
• 是否所有正文引用都可点击。
• 是否文末有完整文献信息列表。
• 是否每篇文献都带 IF 标注或待核验/未检出标注。
• PMID/DOI/URL 是否可点击。
• 是否避免把整体组织结果偷换成特定细胞类型结论。
• 是否避免把活化/磷酸化偷换成总表达量升高。
• 是否标注预印本。
• 是否说明检索边界。
• IF 是否没有凭记忆猜测。
8. 可复现伪代码
```python
queries = build_queries(user_question)
all_pmids = []
for query in queries:
pmids = ncbi_esearch(query, retmax=20, sort='relevance')
all_pmids.extend(pmids)
pmids = deduplicate_keep_order(all_pmids)
metadata = ncbi_esummary(pmids)
abstracts = ncbi_efetch_abstract(pmids)
records = merge_metadata_and_abstracts(metadata, abstracts)
records = tag_evidence(records, user_question)
records = rank_records(records)
selected = select_top_records(records)
if need_fulltext:
for record in selected_key_records:
pmcid = idconv_pmid_to_pmcid(record.pmid)
if pmcid:
record.fulltext = fetch_bioc_or_pmc_xml(pmcid)
for record in selected:
journal_query = record.full_journal_name or record.journal_abbrev
if_result = lookup_if_public_iikx(journal_query)
if if_result.confident:
record.if_annotation = f'*{IF={if_result.if_value},{if_result.quartile}}*'
elif if_result.ambiguous:
record.if_annotation = '*{IF=待核验}*'
else:
record.if_annotation = '*{IF=未检出}*'
answer = compose_answer(
conclusion,
evidence_groups,
clickable_body_citations,
full_reference_list_with_if
)
```
9. 推荐最终交付模板
```markdown
结论:
……
证据等级:
直接证据:
- ……[[1. **Journal**, Year]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
间接证据:
- ……[[2. **Journal**, Year]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
未见直接证据:
- ……
机制归纳:
1. ……
2. ……
检索边界:
本轮主要检索 PubMed / PMC / BioC / bioRxiv;初筛基于 metadata + abstract,仅对关键文献进入全文复核。IF 标注基于公开可访问来源核查;无法高置信匹配时标为待核验或未检出。
完整文献信息列表:
1. Smith J et al., **Journal Name** (2021), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Q1}*
2. Wang X et al., **Journal Name** (2022), [DOI: 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=待核验}*
```
الوصف
موصى بها من قبل
Nico@YouMind
لماذا نحب هذه المهارة
هذه المهارة هي دليل موثوق للبحث في الطب الحيوي، تضمن معلومات دقيقة وقابلة للتحقق عبر استعلام منظم وفحص متعدد المراحل وتدقيق صارم لمعامل التأثير (IF).
سيناريوهات التطبيق: إكمال جولة من البحث في الأدبيات العلمية في مجال البيولوجيا/الطب الحيوي وتقديم مخرجات مفصلة وموثوقة للمستخدم. 1. بعد إجراء المستخدم للبحث، يقوم النظام بتحليل المشكلة والكلمات المفتاحية. 2. استخدام مصادر بيانات عامة وقابلة للتكرار للبحث في الأدبيات. 3. إزالة التكرار، التصنيف، تقسيم الأدلة، وترتيب نتائج البحث. 4. في الرد، استخدم الاستشهادات القابلة للنقر من النص. 5. في النهاية، قائمة كاملة بمعلومات الأدبيات واحدًا تلو الآخر، مع ذكر عامل التأثير (IF) باستخدام مسار يمكن التحقق منه علنًا؛ إذا تعذر التحقق بثقة عالية، يجب وضع علامة "قيد التحقق" أو "غير مكتشف".
مهارات ذات صلة
عرض الكلمدقق خطة البحث·جاهزية المصادر
قبل أن تستثمر عشرات الساعات في كتابة بحثك، خذ عشر دقائق لإجراء فحص منظم. 【هذه المهارة تقوم بشيء واحد فقط】 التشخيص، لا الكتابة نيابة عنك. تخبرك ما إذا كان موضوعك قابلًا للصمود، وما إذا كانت المواد كافية، وما الذي ينقصك، وأين تجده، وبأي ترتيب تكمله، ثم تقدم لك قائمة تكميلية قابلة للتنفيذ وصيغة بحث. لن تكتب عنك المقدمة أو المراجعة أو المنهجية أو المناقشة. 【المراحل الأربع】 1. تشخيص التخصص: تصنيف حسب الفئات الأربع: 1A فنون وعلوم إنسانية / 1B علوم اجتماعية / 2A علوم وهندسة / 2B زراعة وطب وعلوم الحياة، مع تحميل الخطوط الحمراء التنظيمية المقابلة؛ والفئة 2B تفرض مراجعة أخلاقية إلزامية. 2. فحص الموضوع: فحص الموضوع من ثلاثة أبعاد: «الزخم·الشكل·المصطلحات»، لتحديد ما إذا كانت وحدة البحث قابلة للتشغيل، وما إذا كان سؤال البحث قابلًا للإجابة، وما إذا كان الموضوع قد نُفد. 3. فحص المواد: تسجيل المراجع المتوفرة لديك في مكتبة مواد M1/M2...، والتحقق من أربعة عناصر لكل بند (المؤلف/السنة/العنوان/معرف التحقق)، وحساب نسبة التغطية الفعلية. 4. قائمة الثغرات وصيغة البحث: تحديد عدد ونوع المراجع المفقودة، وأي ركن من الأدلة مفقود، وتقديم صيغة بحث يمكن لصقها مباشرة في قواعد البيانات (بما في ذلك مجموعة الكلمات الرئيسية مع العوامل المنطقية، والنطاق الزمني، ومعايير التصفية). 【متى تستخدمها】 (كلمات تنشيطية) «ساعدني في فحص خطة البحث»، «هل يمكن العمل على هذا الموضوع؟»، «هل لدي ما يكفي من المراجع؟»، «تم إرجاع تقرير خطة البحث»، «أريد التأكد قبل البدء في الكتابة» — طلاب الدراسات العليا الذين حددوا اتجاههم للتو ولم يبدأوا الكتابة؛ ومن أُعيد تقرير خطتهم دون معرفة السبب؛ ومن جمعوا الكثير من المراجع لكنهم غير متأكدين من كفايتها؛ ومن يريدون التحقق من جدوى الموضوع قبل استثمار الوقت فيه. 【المخرجات】 مستند «تقرير فحص خطة البحث» + بطاقة تقييم جاهزية المصادر الخمسة (لكل فئة معايير تقييم سلوكية، وليس درجات غامضة) + قائمة أولويات المواد المطلوبة + صيغة البحث + رمز أرشيفي. رمز الأرشفة متوافق مع «学术论文全流程撰写系统 v4.0»، وبعد الفحص يمكنك لصقه مباشرة لمواصلة الكتابة دون إعادة تحديد التخصص أو الموضوع أو المجلة. 【ما لا تفعله بوضوح】 لا تكتب النص الكامل، ولا تنشئ قائمة المراجع، ولا تختلق المؤلفين أو السنوات أو المجلدات أو الصفحات أو أرقام DOI. جميع المراجع التي يتم العثور عليها عبر الإنترنت تُوسم بـ ⚠️ بحاجة إلى تحقق، ويجب عليك التحقق منها بنفسك قبل الاستخدام. هذه المهارة لا تضمن أي قبول أو اجتياز.
بحثنظام الموضوع والمقدمة v3.2
10 ثوانٍ للفهم: يحوّل ملاحظة غامضة إلى موضوع قابل للدفاع، ثم إلى مقدمة قابلة للقبول. طوال الوقت، يستخدم فقط موادك الحقيقية دون اختلاق أي مرجع. كلمات الاستدعاء: اختيار موضوع البحث، اختيار الموضوع، المقدمة، الفجوة البحثية، الكتابة الأكاديمية، مقترح التخرج، اختيار الموضوع قبل مراجعة الأدبيات. مناسب لـ: أوراق المجلات / الرسائل الجامعية / أوراق المؤتمرات / أوراق المقررات، في كل التخصصات الإنسانية والاجتماعية والهندسية والزراعية والطبية. يمكنك البدء في 3 دقائق: حدد التخصص ونقطة البداية → شكل الموضوع تدريجيًا → بوابة الأدلة الإلزامية → مقدمة معيارية → صياغة نهائية متصاعدة. 【التقسيم مع المهارات الأخرى】 الفحص أولاً، والكتابة لاحقًا، والتنقيح أخيرًا. هذه المهارة تتولى الجزء الأوسط: تشكيل الموضوع + المسودة الأولى للمقدمة. وهي لا تكتب النص الكامل (هذا من «نظام الكتابة الكاملة للأوراق الأكاديمية v4.x»)، ولا تقوم بالتحسين اللغوي جملةً جملةً (هذا من «نظام التنقيح ثلاثي المسارات للأوراق الأكاديمية v8.x»). 【المراحل الست】 1. تصنيف التخصص: 1A الفنون والإنسانيات / 1B العلوم الاجتماعية / 2A العلوم الهندسية / 2B الزراعة والطب وعلوم الحياة — أربع فئات، مع تحميل الخطوط الحمراء التنظيمية المقابلة؛ الفئة 2B يُسأل إجباريًا عن حالة الموافقة الأخلاقية. 2. تحديد المرحلة: هل أنت في ملاحظة غامضة، لديك وحدة بلا زاوية، لديك موضوع بلا نظرية، تفتقد المنهج، تفتقد وجهة النظر، أم تفتقد المقدمة فقط؟ — ابدأ من البوابة المناسبة، ولا تبدأ من الصفر. 3. تشكيل الموضوع: وحدة البحث → بوصلة الأبعاد → منظور نظري → منهج البحث → وجهة نظر البحث، وتُثبَّت كل طبقة بعد التأكد من أن الطبقة السابقة راسخة. 4. بوابة الأدلة الإلزامية: قبل المقدمة، يُسجّل أدبك إجباريًا في مكتبة مواد M1/M2…، ويُتحقق من كل عنصر: المؤلف/السنة/عنوان الورقة/المعرّف؛ إذا كان عدد الإدخالات أقل من 3، يرفض النظام توليد بيان الفجوة البحثية — ليس تخفيضًا، بل رفضًا. 5. توليد معياري: تُنتج المقدمة في خمس وحدات وفق هرم مقلوب، كل وحدة تحمل رقم الاستشهاد [Mn]، ولا يُكتب أي جملة بدون مصدر. 6. الصياغة النهائية المتصاعدة: تُضاف النقاط فقط على النسخ المجتازة، وتُقفل الوحدات المستوفاة فلا تُعدّل، والدرجات ترتفع فقط ولا تنخفض. 【المخرجات】 مستند «[كلمة مفتاحية للموضوع]·الموضوع والمقدمة» + جدول تتبع الاستشهادات جملةً بجملة + قائمة ⚠️ للتحقق + كود أرشيف AFP. كود الأرشيف متوافق مع فاحص الافتتاحية ونظام v4.x الكامل ونظام التنقيح ثلاثي المسارات، وعند تغيير المهارة لا تحتاج إلى إعادة شرح التخصص أو الموضوع أو المجلة أو مكتبة المواد. 【ما لا نفعله بوضوح】 لا نختلق المؤلفين أو السنوات أو المجلدات أو الأعداد أو صفحات أو DOI؛ جميع العناوين المسترجعة عبر الإنترنت تُوسم بـ ⚠️ للتحقق، ويجب عليك التحقق منها قبل إدراجها في قائمة المراجع؛ لا نعد بأي قبول أو نتيجة مراجعة. التوقيع والمسؤولية عليك — يرجى التحقق من كل استشهاد وبيان بدقة.
مراجعة وتحسين البحث PRO V2.0
🎯 نظرة عامة على الوظائف الأساسية هذا نظام ذكي لمراجعة وتحسين مقترحات المشاريع البحثية الوطنية (وزارة التعليم، المقاطعات)، يحاكي نمط تفكير خبير تقييم يتمتع بخبرة 15 عامًا، عبر ثلاث آليات أساسية تضمن الدقة الأكاديمية والتنافسية. 🔧 ثلاث آليات أساسية 1️⃣ منهجية هيكلية من 12 خطوة تغطي دورة حياة مراجعة مقترح المشروع بالكامل: المرحلة 1-3: التشخيص الأساسي - تحليل عميق للإعلان (توجهات التمويل، معايير التقييم، متطلبات التقديم) - تحديد نوع التخصصات البينية (8 أنواع بدقة) - تحديد فجوات البحث عبر 5 أبعاد (نظري/منهجي/تجريبي/سياسي/تقني) المرحلة 4-7: تقييم العناصر الأساسية - تحليل مشكلة البحث بنموذج TMAQ (النظرية، المنهج، الفكرة، المشكلة) - اختبار أهداف البحث وفق مبدأ SMART - تقييم شمولية إطار المحتوى البحثي - مطابقة نوع منهجية البحث (6 أنواع) المرحلة 8-10: تحسين الجودة العميق - تحديد النقاط الصعبة بدقة (معيار التمييز + مسار الاختراق) - استخراج نقاط الابتكار عبر 7 أبعاد - إثبات الجدوى عبر 7 أبعاد المرحلة 11-12: التحسين الشامل - فحص الجودة عبر 9 أبعاد (الدقة الأكاديمية، الابتكار، الجدوى...) - توصيات تحسين شاملة وتقرير نهائي 2️⃣ آلية المواجهة ثنائية النواة (Builder vs Supervisor) آلية العمل: - Builder (كاتب أكاديمي): يولد خطط تحسين بناءً على مواد المستخدم - Supervisor (مراجع من مجلة رفيعة): يتحدى خطط Builder بأعلى معايير الصرامة - التكرار المواجه: عبر 3 جولات لضمان متانة الخطة سيناريوهات التطبيق: - استخراج نقاط الابتكار: Builder يقترح → Supervisor يشكك في الجدة → تحسين متكرر - إثبات الجدوى: Builder يصمم خطة → Supervisor يتحدى الجدوى → إثبات إضافي - الاستشهاد بالمراجع: Builder يستشهد → Supervisor يتحقق من الصحة → ضمان الالتزام الأكاديمي 3️⃣ آلية التحقق من صحة المراجع نمطان للعمل: النمط أ: نمط العناصر النائبة (افتراضي) - استخدام علامات مثل [مكان-المرجع-001] بدلاً من المراجع المحددة - إخراج قائمة المراجع المطلوبة، توضح متطلبات البحث لكل عنصر نائب - يقوم المستخدم بالبحث وملء المراجع الحقيقية النمط ب: نمط التحقق الفوري - استدعاء Google Scholar للتحقق الفوري من صحة المراجع - توليد تقرير التحقق من المراجع (درجة الصحة/الملاءمة/الموثوقية) - ضمان إمكانية تتبع كل استشهاد منع الهلوسة الاصطناعية: - منع اختلاق المؤلفين والمجلات وDOI - يجب التحقق من جميع المراجع أو وضع علامة عليها كعناصر نائبة - ضمان النزاهة الأكاديمية 💡 القيمة الأساسية وسيناريوهات الاستخدام ✅ المشكلات الأساسية التي يحلها 1. عدم الدقة الأكاديمية: محتوى AI يظهر مراجع وهمية وثغرات منطقية 2. نقص الابتكار: صعوبة اكتشاف نقاط الابتكار الأكاديمية الحقيقية 3. ضعف الجدوى: نقص الإثبات المنهجي لخطة البحث 4. صعوبة التخصصات البينية: اختيار الموضوعات البينية غير متوازن 🎓 المستخدمون المستهدفون - أساتذة الجامعات (العلوم الاجتماعية، التربية، العلوم الإنسانية) - الباحثون (تقديم مشاريع وطنية ومقاطعات) - الفرق الأكاديمية (بحاجة لعمليات مراجعة منهجية) 📋 سير العمل النموذجي 1. الإدخال: تحميل إعلان المشروع + مسودة المقترح 2. المراجعة: تنفيذ التحليل الهيكلي المكون من 12 خطوة 3. المواجهة: تحسين الأجزاء الرئيسية بتكرار الآلية ثنائية النواة 4. التحقق: فحص صحة المراجع 5. الإخراج: تقرير مراجعة كامل + توصيات تحسين + قائمة مراجع 🔍 الفرق عن التقييم التقليدي | البعد | التقييم التقليدي البشري | نظام التقييم الخبير | |--------|------------------------|---------------------| | عمق التقييم | يعتمد على الخبرة الشخصية | 12 خطوة هيكلية + 9 أبعاد جودة | | الدقة الأكاديمية | صعوبة الفحص الشامل | تحقق مراجع + مواجهة مزدوجة | | اكتشاف الابتكار | حكم ذاتي | تحليل منهجي من 7 أبعاد | | إثبات الجدوى | مدفوع بالخبرة | إثبات مكون من 7 أبعاد | | الاتساق | يختلف حسب الشخص | عملية موحدة | | الكفاءة | أيام إلى أسابيع | 1-2 ساعة للتقييم الأولي | الميزة الأساسية لهذا النظام: تحويل المعرفة الضمنية لخبير تقييم يتمتع بخبرة 15 عامًا إلى معرفة واضحة ومنظمة وقابلة للتكرار، مما يمنح كل مستخدم خدمة تقييم على مستوى الخبراء.
اعثر على مهارتك المفضلة التالية
استكشف مزيدًا من مهارات الذكاء الاصطناعي المنتقاة للبحث والإبداع والعمل اليومي.