Wach auf, Schatz, es gibt ein neues Paper von der Harvard: Economy of Minds (EOM). Sie haben ein dezentrales Multi-Agenten-System entwickelt, bei dem Agenten mit marktähnlichen Mechanismen (Auktionen, Zahlungen, Vermögensaufbau) koordinieren und sich im Laufe der Zeit verbessern.
Sie berichten, dass eine solche Umgebung zu emergenter mehrstufiger Argumentation und starker Leistung bei verschiedenen agentischen Aufgaben geführt hat!
Hinweis: Dieser Artikel wurde von AVB mit GPT-5.2 im Paper Breakdown-Toolkit verfasst
Warum sollte mich das interessieren?
Wenn du Multi-Agenten-Systeme baust, um bestimmte Aufgaben zu erledigen – das ist für dich. Die meisten Multi-Agenten-Stapel verlassen sich immer noch stark auf manuelle Orchestrierung – du (der Entwickler) schreibst explizite Prompts und Zustandsmaschinen-Graphen, um manuell zu definieren, "wer was und wann tut".
Lange Aufgaben erfordern je nach Zustand und Fortschritt der Aufgabe unterschiedliche Rollenwechsel. Und es ist fast immer am besten, Systeme zu entwerfen, die ihre System-Prompts optimal umschalten können, damit Aufgaben immer vorankommen.
Das Ziel dieses Papers ist genau das. Wie erzeugt man für eine gegebene Aufgabe eine optimierte Population von Multi-Agenten, jede mit spezifischen Anweisungen, wie und wann zu handeln ist.
Und das haben sie auf eine wirklich einzigartige und unterhaltsame Weise gemacht – durch die Simulation eines Marktsystems, das extern steuert, wie sich Agenten entwickeln.
Das Endergebnis dieser Optimierung ist eine Gruppe spezialisierter Agenten und ein intelligenter Routing-Mechanismus, der auswählt, wie sie eine Aufgabe lösen.
Wenn wir einfache Agenten mit einem grundlegenden Aktionsraum in ein komplexes Multi-Agenten-Szenario stecken, was passiert wohl? Komplexe Verhaltensweisen entstehen automatisch, weil diese einfachen Agenten beginnen, ihr Leben um die Unsicherheiten herum zu optimieren, die andere Agenten im Szenario verursachen. Das ist das Beste an der ganzen Sache.
Übrigens ist diese Theorie, dass "Verhaltensweisen organisch aus Multi-Agenten-Szenarien entstehen", kein neues Konzept. Sogar einige ältere Pre-LLM-Multi-Agenten-Arbeiten haben dies angedeutet, wie das berühmte OpenAI-Verstecken-Paper.
https://openai.com/index/emergent-tool-use/
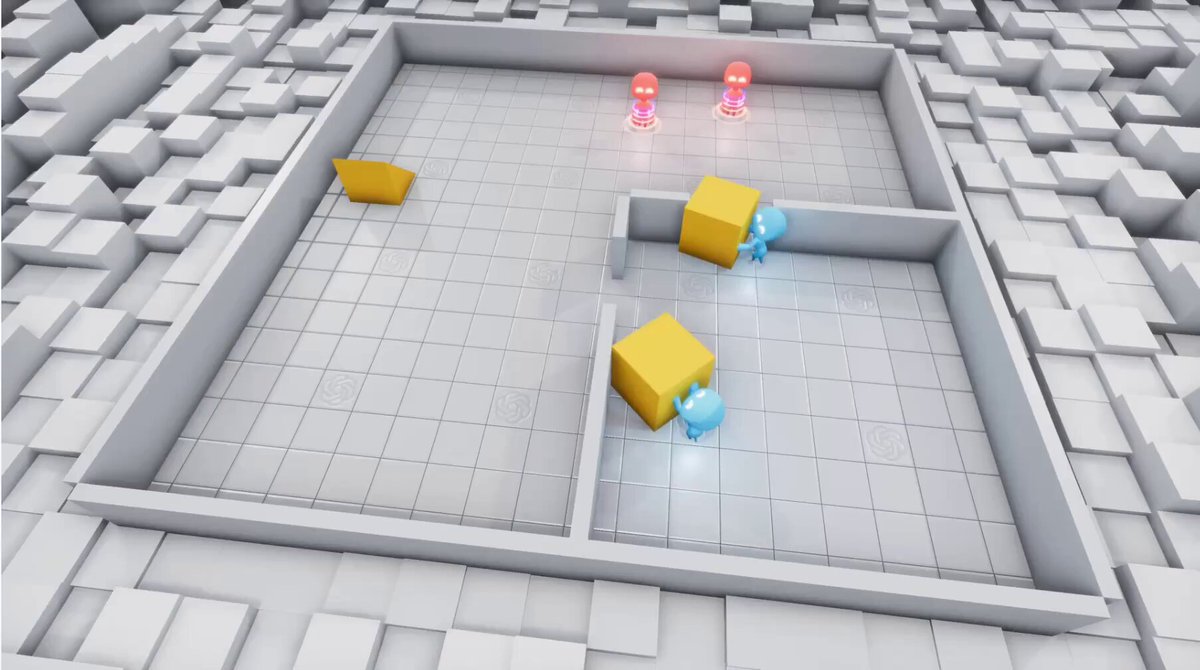
Dieses Paper erinnerte mich zwar an einige Ideen aus diesen älteren Multi-Agenten-Papieren, aber es gibt ein paar Einschränkungen. Es ist wichtig, Folgendes zu beachten:
- Dieses Paper TRAINIERT keine Agenten, um finanziell unabhängig zu sein oder Trades oder Auktionen durchzuführen!
- Tatsächlich ist dies ein neuer Algorithmus zur Optimierung von Agenten in gängigen verifizierbaren Umgebungen wie Mathematik, Optimierung von Beschleunigercode, Deep Search, wissenschaftlicher Forschung usw.
- Die Agenten wissen größtenteils nicht einmal, dass sie sich in diesem Marktsimulator befinden. Dies ist ein externes System, das steuert, wie sich Agenten entwickeln (und welche nicht).
Agenten bieten in der Auktion, um das Recht zu gewinnen, einen Schritt in einer dieser Zielumgebungen zu machen.
Ein Gewinn in dieser Auktion belastet ihren Geldbeutel mit dem Gebot, und sie dürfen die Umgebung "besuchen", um eine tatsächliche Aktion auszuführen, die die Umgebung von Schritt
t
zu Schritt
t+1 voranbringt.
Zukünftige Agenten, die in derselben Umgebung Aktionen ausführen, zahlen ihr Gebot an den vorherigen Agenten (den letzten Gewinner) zurück.
Wiederhole dies eine Weile, und die reichsten Agenten haben am Ende die besten Strategien für die Zielumgebung.
Das ist ein super interessanter Ansatz für die Kreditzuweisung über lange Zeiträume und evolutionäre Prompt-Optimierungsalgorithmen. Lass uns den Algorithmus von Anfang an aufschlüsseln, um wirklich zu verstehen, was sie da kochen.
Der Ansatz
In diesem Paper ist ein Agent kein separat trainierter neuronaler Netzwerke. Jeder Agent ist im Wesentlichen eine Prompt-basierte LLM-Strategie mit:
- einem Prompt (einem System-Prompt / einer Instruktionsvorlage, die seine "Rolle" und Vorgehensweise definiert). Diese Rolle ändert sich je nach Zielumgebung, für die wir optimieren. Zum Beispiel weisen sie für die MATH-Aufgaben diese Rollen zu: Planer, Ausführer, Verifizierer, und für die Beschleuniger-Entwurfsaufgabe: Historiker, Planer, Ausführer
- einer Auslöse-/Aufwachbedingung, die bestimmt, wann sie berechtigt sind, in der Auktion zu bieten.
- einem (festen) Gebotswert, der in Auktionen verwendet wird,
- und einer Vermögensvariablen, die sich im Laufe der Zeit ändert und die Selektion antreibt
EOM läuft dann in zwei gekoppelten Schleifen:
- Planung (innerhalb einer Episode): Agenten versteigern das Recht, bei jedem Schritt zu handeln, und das Vermögen wird über eine Bucket-Brigade-Zahlungsregel aktualisiert.
- Anpassung (über Episoden hinweg): Die Population entwickelt Prompts durch Exploration/Exploitation, die nur durch Vermögen gesteuert wird.
Das Ziel von EOM (das endgültige Ergebnis) ist eine Gruppe von Agenten. Jeder Agent mit seinem eigenen System-Prompt darüber, wie man in einer bestimmten Umgebung handelt, und einer Strategie, wann man handelt. Bei einem neuen Problem bieten die Agenten darauf, wer handelt, führen die Aktion aus und wiederholen den Vorgang, bis die Lösung erreicht ist.
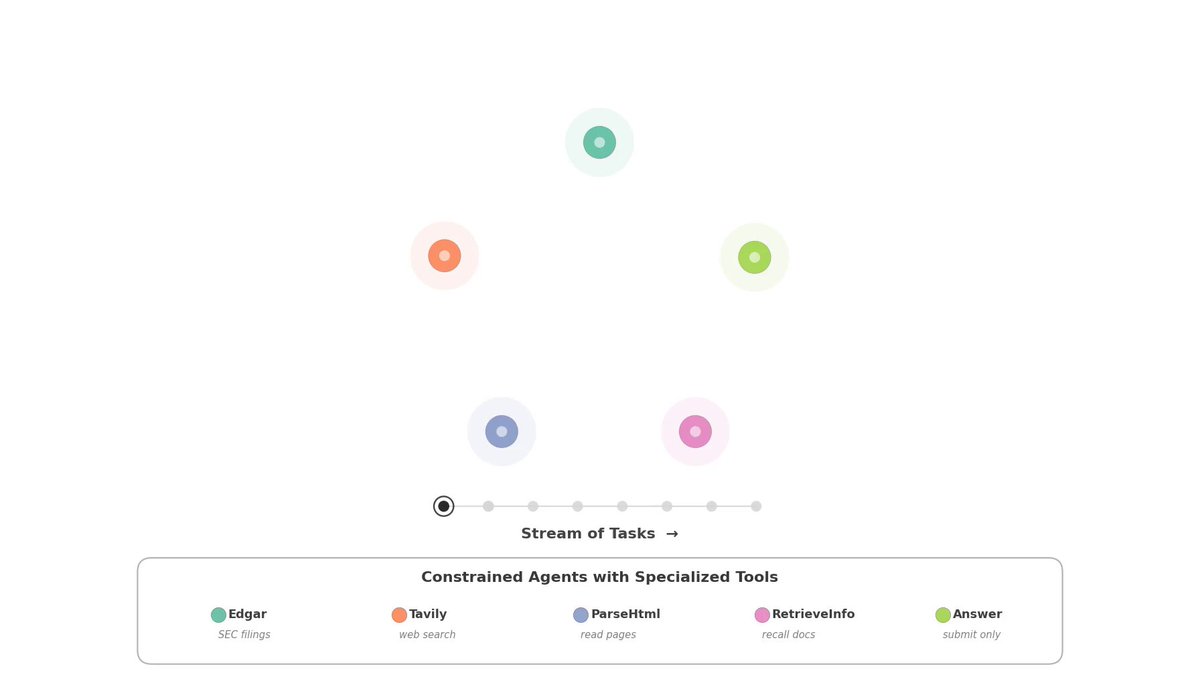
Schleife 1: Erfahrungen sammeln + Auktion durchführen
Bei jedem Umgebungsschritt in einer Episode:
- Basierend auf der aktuellen Beobachtung der Zielumgebung führt jeder Agent einen Prompt aus, der bestimmt, ob er "aufwachen" soll oder nicht. Aufwachen bedeutet einfach, an der bevorstehenden Auktion in Schritt 2 teilzunehmen.
- Die Agenten, die sich entschieden haben aufzuwachen, geben automatisch ihre festen Gebote ab. Es ist ein festes Gebot, weil diese Gebote während der Initialisierung festgelegt werden (d. h. die Agenten versuchen nicht, ein Gebot intelligent zuzuteilen).
- Der Agent mit dem höchsten Gebot ist der Auktionsgewinner! Er verliert sofort das Geld, das er geboten hat. Aber er gewinnt die Kontrolle über die Umgebung.
- Der Gewinner-Agent führt eine Aktion in der Zielumgebung in ihrem aktuellen Zustand durch. Dies wird darin bestehen, den nächsten Schritt in der Zielumgebung auszuführen und die Uhr von s_t -> s_t+1 vorzustellen.
- Die Umgebung wechselt den Zustand und erzeugt eine Belohnung r_t.
- Vermögenstransfer findet statt mit Bucket-Brigade-Kreditzuweisung! 2 Dinge passieren: a) Der neue Gewinner zahlt sein Gebot an den vorherigen Gewinner b) Der neue Gewinner sammelt auch die Umgebungsbelohnung r_t in seinen Geldbeutel
Für den ersten Gewinner geht die Zahlung an das "Haus" (nicht an einen anderen Agenten).
- Im nächsten Schritt wiederholt sich die gesamte Schleife, aber mit der aktualisierten Umgebung. Allerdings "wachen" Agenten basierend auf der neuesten Beobachtung auf (erhalten aus s_t+1 ), und der Gewinner dieser Auktion zahlt sein Gebot an den Gewinner der vorherigen Auktion. Dieses Gebot wird dem Geldbeutel des vorherigen Gewinners hinzugefügt.
- Wenn ein Agent zu irgendeinem Zeitpunkt bankrott geht, wird er rausgeworfen. Wenn ein Agent auch auf seinem Geldbeutel sitzt und die Teilnahme verweigert, sinkt sein Geldbeutel mit der Zeit ebenfalls und er geht schließlich bankrott. Das verleiht der ganzen Sache Dringlichkeit.

Nun geben viele Umgebungen keine Zwischenbelohnungen und erzeugen nur eine, nachdem die gesamte Episode beendet ist. Im traditionellen RL hat dies aufgrund des berüchtigten "Kreditzuweisungsproblems" schon viele Kopfschmerzen verursacht. Grundsätzlich: Wenn eine lange Aktionskette schließlich zu einer guten Belohnung führt, wie schreibt man jeder einzelnen Aktion in der Kette eine Teilbelohnung zu?
Diese Methode adressiert dieses Problem mit der Regel "zahle dein Gebot an den letzten Auktionsgewinner".

Diese Designentscheidung hat eine entscheidende Konsequenz in Bezug auf den Rückwärtsfluss des Werts: Ein Agent kann profitieren, indem er das System in Zustände versetzt, in denen nachgelagerte Agenten bereit sind, "ihr Gebot zu zahlen", um die Kontrolle zu übernehmen. Dies wird zu einer dezentralisierten Kreditzuweisung entlang des Verlaufs.
Wenn deine Aktion zukünftige wertvolle Aktionen ermöglicht, "kaufen" spätere Agenten die Fortsetzung von dir über Gebote, sodass du belohnt wirst, selbst wenn du nicht direkt rt bei deinem Aktionsschritt erhalten hast.
Als nächstes, nachdem die Episoden-Durchläufe beendet sind, ist es Zeit, die Strategien zu aktualisieren.
Schleife 2: Agenten entwickeln
Nachdem Episoden beendet sind, wird die Population von Agentenstrategien durch ökonomische Selektion und einen Prompt-Mutationsmechanismus aktualisiert. Grundsätzlich entfernen wir Agenten, die aktuell arm sind, und mutieren die Agenten, die reich sind, für die nächste Runde.

Denke daran, Agenten mit niedrigem Vermögen sind schlecht, weil sie entweder:
- nicht an der Auktion teilgenommen haben (zu passiv)
- teilgenommen, aber Aktionen ausgeführt haben, die zu schlechten Zuständen in der Zukunft führten, an denen andere Agenten nicht teilnahmen
Nachdem wir diese Underperformer ausgesondert haben, fügen wir neue Agenten hinzu, bis die Populationsgrößenbeschränkungen erreicht sind, und verwenden zwei Quellen:
- Exploitation: Wähle wohlhabende "Eltern"-Agenten aus und mutieren ihre Prompts leicht, um Kinder zu erzeugen, die nützliche Verhaltensweisen beibehalten, aber leicht variieren. Dies verstärkt erfolgreiche Strategien und fördert die Spezialisierung.
- Exploration: Ersetze bankrotte/schwache Agenten durch neue Varianten, die durch Änderung von Prompts erstellt wurden, um Fehlermodi zu korrigieren oder verschiedene Verhaltensbereiche zu erkunden.
Inferenz und was lieferst du tatsächlich aus?
Lieferst du einen einzelnen Agenten aus? Einen einzelnen Gewinner? NEIN!
In EOM ist das, was du "trainierst" und dann zur Lösung von Aufgaben "auslieferst", eine Gesellschaft/Population von Agenten, wobei jeder Agent seine eigenen Prompts und seine eigene lokale "Wann-handeln"-Logik hat.
Zur Bewertungszeit bewerten sie explizit mit einer thread-lokalen Kopie der trainierten Population, und die Aufwach-Strategie wird verwendet, um auszuwählen, welcher Agent handelt. Die Population ist "eingefroren" (kein weiteres Training).
All die Marktsimulations-Eskapaden wie Geldbeutel und Vermögenstransfer sind nur Trainingszeit-Dinge. Sobald die Population optimiert ist, verwenden wir sie während der Inferenz nicht wirklich.
Beachte, dass das Gebotssystem immer noch verwendet wird, um zu bestimmen, wer in einem Schritt "handeln" soll, wenn mehrere Akteure gemeinsam "aufwachen" wollen.
**
Eine Fallstudie, um alles zu erklären

Sieh dir Abbildung 5 oben an. Sie erklärt den Coolness-Faktor dieser "Economy of Minds"-Idee für die Beschleuniger-Entwurfsaufgabe. Im Beschleuniger-Entwurf sind Agenten rollenspezialisiert:
- Historiker: fasst vorherige Versuche zusammen, behält das Gedächtnis an vielversprechende/fehlgeschlagene Richtungen
- Planer: schlägt hochrangige Suchrichtungen vor
- Ausführer: führt detaillierte lokale Bewertungen durch
Und die Umgebungsbelohnung zielt auf die Verbesserung des EDP (Energie-Verzögerungs-Produkts) auf GEMMINI ResNet-50-Kernen ab (niedrigerer EDP ist besser).
Jeder rollenspezialisierte Agent (Historiker, Planer, Ausführer) trägt Vermögen, und dieses Vermögen wird zu einer Live-Bestenliste der Nützlichkeit, während die Episoden fortschreiten.
Agenten, die helfen, neue Bestmarken zu erzielen, sammeln Vermögen. Die regelmäßige Abgabe bestraft alle stetig (also sterben mittelmäßige Agenten einfach langsam aus), und sobald das Vermögen unter Null fällt, geht der Agent bankrott und wird entfernt.
In der Zwischenzeit erschaffen die reichsten Agenten mutierte "gute-Geburt"-Nachkommen (Exploitation) und die schwächsten erschaffen modifizierte "schlechte-Geburt"-Nachkommen (Exploration).
Über verschiedene Kerne hinweg entdeckt der Marktdruck automatisch, welche Spezialisten-Linie tatsächlich wertvoll ist. Manchmal bricht das Historiker-artige Gedächtnis aufgrund vererbter Voreingenommenheit zusammen, manchmal reproduziert sich eine Planer-Linie, weil die hochrangige Suchrichtung der Engpass ist, und manchmal koexistieren mehrere Rollen, weil sie sich ergänzen.
Mit anderen Worten, Koordination und Kreditzuweisung entstehen aus einfachen Anreizen (Vermögensfluss, Abgabe, Geburt, Bankrott), und erzeugen eine anpassungsfähige Population ohne zentrales System! Und genau deshalb fühlt sich der Ansatz wie eine coole Art an, Multi-Agenten-Systeme zu bauen.
Emergente Verhaltensweisen / "Aha-Momente", die das Paper hervorhebt
Erinnere dich, dass sie für eine bestimmte Umgebung (sagen wir MATH) ihre Agenten während der Initialisierungsphase mit spezifischen Rollen ausstatten. Planer, Ausführer, Verifizierer. Ein Agent mit dem Planer-Prompt wird wahrscheinlich früh in den Episoden bieten, während Verifizierer wahrscheinlich bieten, nachdem eine Lösungsentwurf vorhanden ist.
Obwohl dies eine intuitive Art ist, über dieses Paper nachzudenken, ist es in der Praxis nicht das korrekte Modell. Eine nützliche Art, EOM zu lesen, ist: sie codieren keinen Workflow fest, sondern sie richten wirtschaftliche Regeln ein, und dann organisiert sich die Population selbst in Verhaltensweisen, die überraschend wie gelernte "Algorithmen" und "Institutionen" aussehen.
Hier sind einige coole Erkenntnisse, die das Paper berichtet:
1) Kreditzuweisung wird zu einem Marktsignal, das ganze Aktionsketten auswählt
Eine Kernbeobachtung ist, dass die Leistung verbessert wird, weil die Wirtschaft nützliche Aktionsketten auswählt, sie reproduziert und Agenten löscht, die nicht beitragen. Koordination ist also eine emergente Eigenschaft der Selektion, kein entwickelter Protokoll.
Dies ist ein "Aha", weil es nicht nur darum geht, dass "Agenten bessere Prompts machen"; das System wird besser darin, welche Sequenzen von Agenten handeln, d.h., die Interaktionstopologie schärft sich im Laufe der Zeit. Ähnlich wie das OpenAI-Verstecken-Paper!

2) Nicht-monotone Lernkurven: frühes Chaos ist "produktiv"
Auf Finance-Agent-Bench stellen sie explizit ein Muster fest: EOM fällt früh ab (während die Exploration alternative Spezialisten testet) und erholt sich erst später und übertrifft die anfängliche Leistung. Das ist ein bisschen wie Grokking beim Training neuronaler Netzwerke (schätze ich?)
Jedenfalls ist das ein sehr "marktähnliches" Phänomen: die Autoren sagen (sinngemäß) "Früher Umschwung und Neuzuweisung können die vorläufige Leistung vorübergehend beeinträchtigen, während nach besseren Spezialisten/ Koordination gesucht wird"
3) Vermögensverläufe zeigen "Abstammungslinien", die dominieren, und "schlechte Geburten", die aussterben
Im Beschleuniger-Entwurf kannst du buchstäblich sehen, wie nützliche Abstammungslinien bestehen bleiben, Nachkommen hervorbringen und Auktionen dominieren, während fehlgeschlagene Varianten bankrott gehen und entfernt werden.
Mit anderen Worten, die Lerneinheit ist nicht ein einzelner Agenten-Prompt: es ist ein sich entwickelnder Familienstammbaum von Prompts unter dem Selektionsdruck des Vermögens.
4) Entdeckung wiederverwendbarer Domänenstrukturen ohne Vorlagen (übertragbare Heuristiken)
Ein besonders auffälliges emergentes Verhalten: Bei den schwierigsten Beschleuniger-Kernen konvergiert die Gesellschaft wiederholt auf ein spezifisches Tiling/Datenfluss-Motiv (Output-Stationary-Stil), obwohl:
- es nicht als dieses Motiv als Vorlage gegeben ist, und
- die Belohnung nur "EDP-Rekordbrüche" ist (keine Beschriftungen wie "verwende output-stationary")
Das System lernt also eine wiederverwendbare Design-Heuristik durch Selektion.
5) Prompts entwickeln sich zu kompakten mehrstufigen Argumentationsroutinen (selbstprüfende "Checklisten")
In der wissenschaftlichen Forschung berichten sie von Prompt-Evolution, bei der ein AUSFÜHRER internalisiert, was zuvor andere Rollen erforderte, und Mutationen fügen zunehmend explizite Selbstkontrollen hinzu (Prinzip zuerst, Symmetrie-Checks, Machbarkeitsprüfungen, Substitution zur Falsifikation).
Ein Agent wird weniger zu einem generischen Textgenerator und mehr wie ein prozedurales Modul, das eine gelernte wissenschaftliche Ableitungsroutine ausführt.
6) Aktionsdisziplin: Lernen, wo (nicht) teure Aktionen auszugeben (CloudCast)
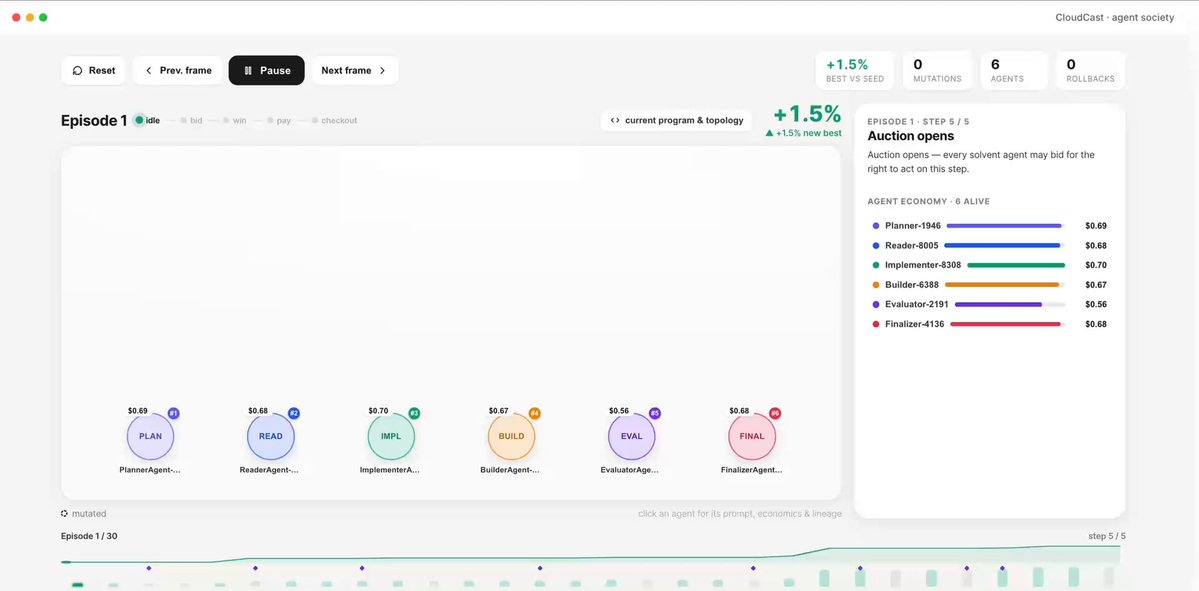
CloudCast ist eine iterative Code-Optimierungsaufgabe, bei der die Agentengesellschaft ein Python-Programm verbessern muss, das eine Multi-Cloud-Broadcast-Routing-Topologie entwirft, um die gesamte Datenübertragungskosten (Egress) zu minimieren. Dies war eines ihrer Testfelder.
In dieser CloudCast-Aufgabe beobachten sie, dass die Wirtschaft je nach Arbeitsbereichszustand unterschiedliche Workflow-Formen auswählt:
- nahe einer hohen Punktzahl → kurze "lesen-bearbeiten-bewerten-festschreiben"
- unsicher/rückläufig → längere "bearbeiten-bauen-bewerten"-Schleifen
Das ist ein emergentes Ressourcenbewusstseins-Verhalten: eine gesellschaftsweite Strategie dafür, wann man vorsichtig vs. aggressiv handelt, ohne zentrale Steuerung.
Lies das vollständige Paper hier: http://arxiv.org/abs/2606.02859
Und auch bei Paper Breakdown, das ich verwendet habe, um dieses Paper zu studieren: http://paperbreakdown.com/abs/2606.02859
Danke fürs Lesen!
**


