Hemos implementado los Cerebras Wafer Scale Engines junto con GPUs para ofrecer tokens ultrarrápidos a gran escala
El mundo tiene hambre de tokens ultrarrápidos. En 2026, Cerebras experimentó una demanda insaciable de inferencia rápida, tanto en nuestra nube de inferencia como a través de nuestros socios. Para satisfacer esta demanda, comenzamos a desarrollar la inferencia desagregada: las GPUs se encargan del procesamiento de prompts (prefill) y los sistemas Cerebras se encargan de la generación de respuestas (decode).
Esta solución ya está en producción y ofrece cinco veces más tokens por megavatio a las mismas velocidades ultrarrápidas de Cerebras.
Ahora podemos servir más tokens ultrarrápidos a través de Cerebras Inference Cloud para responder a la demanda del mercado. Los socios de infraestructura también pueden aprovechar la solución desagregada de Cerebras para generar más tokens ultrarrápidos en sus propios centros de datos.
Junto con nuestro recientemente anunciado CS-4, el enorme aumento de escala en nuestra fabricación y los 700 MW de capacidad de centros de datos que tenemos planificados, la inferencia desagregada permitirá a Cerebras y a sus socios servir muchos más tokens ultrarrápidos en 2027 y en adelante. En este blog abordamos:
- La necesidad de contar con mayor capacidad de inferencia ultrarrápida
- Por qué Cerebras tiene ventaja en la fase de decode
- Los resultados en producción de la inferencia desagregada de Cerebras
- La inferencia desagregada de Cerebras para socios de infraestructura
La necesidad de contar con mayor capacidad de inferencia rápida
Las aplicaciones agénticas como Muse, Copilot y Codex están escalando rápidamente y requieren una inferencia altamente interactiva para mantener a los usuarios enganchados. Para satisfacer la creciente demanda de estas aplicaciones en un entorno con restricciones energéticas, nuestra industria debe ofrecer una capacidad de inferencia significativamente mayor por megavatio, a velocidades de respuesta que hagan que estas aplicaciones sean realmente útiles.

Fuentes: Goldman Sachs Research, “Se prevé que los agentes de IA impulsen el flujo de caja tecnológico a medida que se dispara su uso”, 20 de mayo de 2026; estimaciones de capacidad de centros de datos de Goldman Sachs, según lo publicado por Investing.com
Por eso Cerebras invirtió en la desagregación. Combinar un acelerador de prefill para el procesamiento de prompts con el sistema Cerebras para la generación de respuestas aumenta el rendimiento de tokens por megavatio sin sacrificar las velocidades de generación ultrarrápidas de Cerebras. Para los proveedores de inferencia, esto significa más capacidad para atender a los clientes y un mayor potencial de ingresos con el mismo presupuesto energético.
Por qué Cerebras tiene ventaja en la fase de decode
Una solicitud de inferencia consta de dos etapas principales. El procesamiento de prompts, conocido como prefill, procesa la entrada y genera un estado intermedio del modelo. La generación de respuestas, conocida como decode, utiliza ese estado para producir los tokens de salida. Existen muchas formas de dividir la carga de trabajo de inferencia, entre ellas draft–target y attention–FFN, pero separar el prefill del decode resulta especialmente ventajoso cuando el objetivo es lograr una inferencia altamente interactiva.

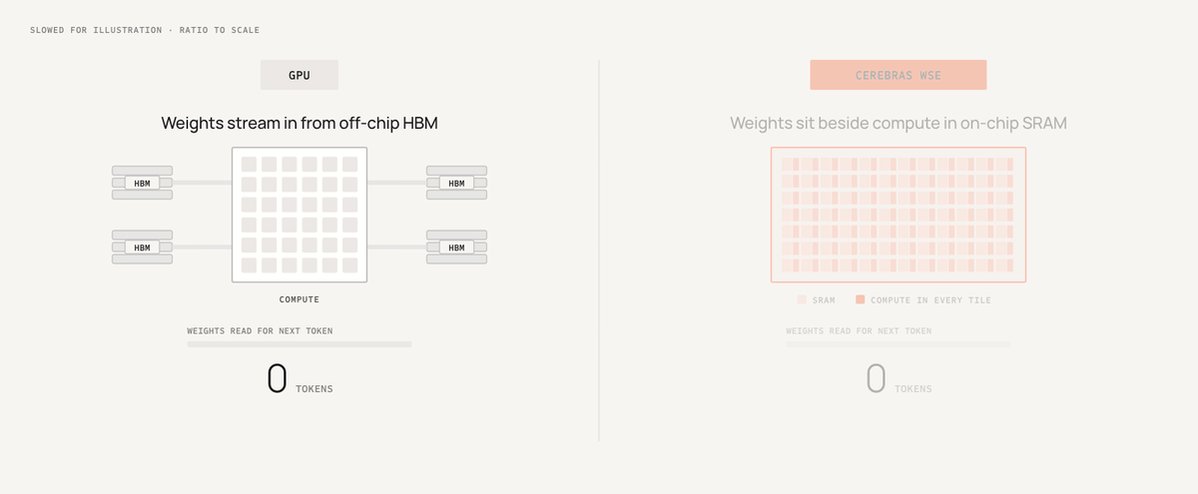
La fase de decode es autorregresiva. Esto significa que el modelo genera un token a la vez, utilizando cada token generado como entrada para producir el siguiente. Cada paso implica volver a leer los datos del modelo desde la memoria, por lo que el ancho de banda de memoria es fundamental. En el ámbito de la inferencia ultrarrápida, los chips centrados en SRAM tienen ventaja porque pueden mantener esos datos dentro del propio chip y leerlos mucho más rápido. Cerebras lleva esto a escala de oblea (wafer scale), con decenas de gigabytes de SRAM y decenas de petabytes por segundo de ancho de banda de memoria en un solo chip: 350 veces la capacidad de SRAM y 5.400 veces el ancho de banda de memoria de una GPU GB300 típica. Esto permite que el sistema Cerebras aloje más solicitudes concurrentes y capas del modelo directamente en el chip, logrando que el CS-3, el CS-4 y el CS-5 alcancen velocidades ultrarrápidas con un rendimiento muy atractivo.
GIF
Resultados en producción de la inferencia desagregada de Cerebras
Combinar los sistemas Cerebras, optimizados para un decode ultrarrápido, con aceleradores perfectamente adaptados a las necesidades de cómputo del prefill, como las GPUs AMD Instinct, permite entregar una cantidad inmensa de inferencia ultrarrápida a gran escala. En una implementación en producción dentro de Cerebras Inference Cloud, las GPUs AMD Instinct procesan los prompts y los sistemas Cerebras CS-3 generan las respuestas. Trasladar el procesamiento de prompts a las GPUs permite que los sistemas Cerebras dediquen toda su capacidad de servicio a la generación de respuestas. En nuestra implementación en producción medida, esta combinación ofreció 5 veces más rendimiento por megavatio que una configuración basada únicamente en CS-3, sin ninguna pérdida en la velocidad de generación de tokens.

Fuente: endpoint compartido GPT-OSS-120B del 14 de noviembre a través de Cerebras Inference Cloud; rendimiento por megavatio antes y después de habilitar la inferencia desagregada, normalizado respecto a la línea base de inferencia agregada (1×).
Planeamos implementar la inferencia desagregada de forma generalizada en cientos de megavatios dentro de Cerebras Inference Cloud y en las implementaciones de nuestros socios para finales de 2027. Nuestro objetivo es aumentar la capacidad de inferencia ultrarrápida disponible para nuestros clientes.
La inferencia desagregada de Cerebras para socios de infraestructura
La solución de inferencia desagregada de Cerebras también se diseñó pensando en que nuestros socios la adoptaran. Los socios de infraestructura pueden implementar clústeres de inferencia desagregada basados en la arquitectura de referencia proporcionada por Cerebras, ubicando en un mismo lugar sus aceleradores de prefill elegidos y los sistemas Cerebras dentro de una red unificada. Para la integración de software, los socios pueden optar por integrarse con el stack de software desagregado integral de Cerebras o con un SDK exclusivo para decode.
- El stack de software desagregado integral es ideal para los socios que buscan optimizar su tiempo de llegada al mercado. Está compuesto por:
- Un framework de inferencia desagregada para enrutar las solicitudes entre los pools de prefill y decode, y gestionar la capacidad y el estado de salud de las réplicas.
- Un motor de prefill para procesar prompts utilizando motores de inferencia de código abierto como vLLM o SGLang.
- Un motor de decode de Cerebras para la generación de respuestas en sistemas Cerebras.
- El software KV Portal, una interfaz para transferir el estado intermedio del modelo, incluidas las cachés clave-valor, entre los motores de prefill y decode mediante RDMA.
El SDK exclusivo para decode es la mejor opción para los socios que priorizan el control. Con este SDK, los socios pueden aportar su propio framework de inferencia y motor de prefill al motor de decode de Cerebras y al software KV Portal. Además, el SDK exclusivo para decode incluye herramientas de desarrollo, como una réplica de decode de Cerebras simulada y una integración de referencia con un framework de inferencia desagregada y un motor de prefill de código abierto.

Los socios con acceso anticipado, entre ellos Amazon Web Services, Fireworks AI, Gimlet Labs y General Compute, ya pueden utilizar la solución de desagregación de Cerebras en sus implementaciones. Ahora estamos ampliando el acceso a otros socios que desean llevar la inferencia ultrarrápida a sus clientes a gran escala.
Si quieres analizar los resultados, las soluciones o las oportunidades de implementación con más detalle, contáctanos aquí.


