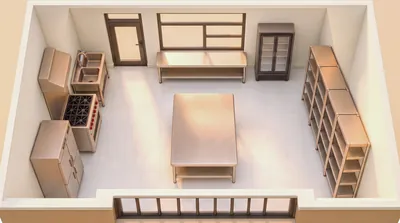
Modelado de escenas 3D por voz
Controla Blender con YM para modelar
Modelado de escenas 3D por voz
Controla Blender con YM para modelar
Vista previa
Descripción
Controla directamente Blender mediante Blender MCP para modelar y verificar el espacio de la escena, e itera optimizando los prompts de generación de imágenes con IA. Está dirigido a usuarios que no saben usar software 3D; la IA, como agente completo, se encarga del modelado, la resolución de problemas de renderizado, la verificación de iluminación y la ingeniería de prompts. El objetivo final es mantener la coherencia de la escena al crear videos de animación 3D: Blender construye la escena, controla la cámara y transmite las referencias de posición al modelo de generación de video.
Habilidades relacionadas
Ver todo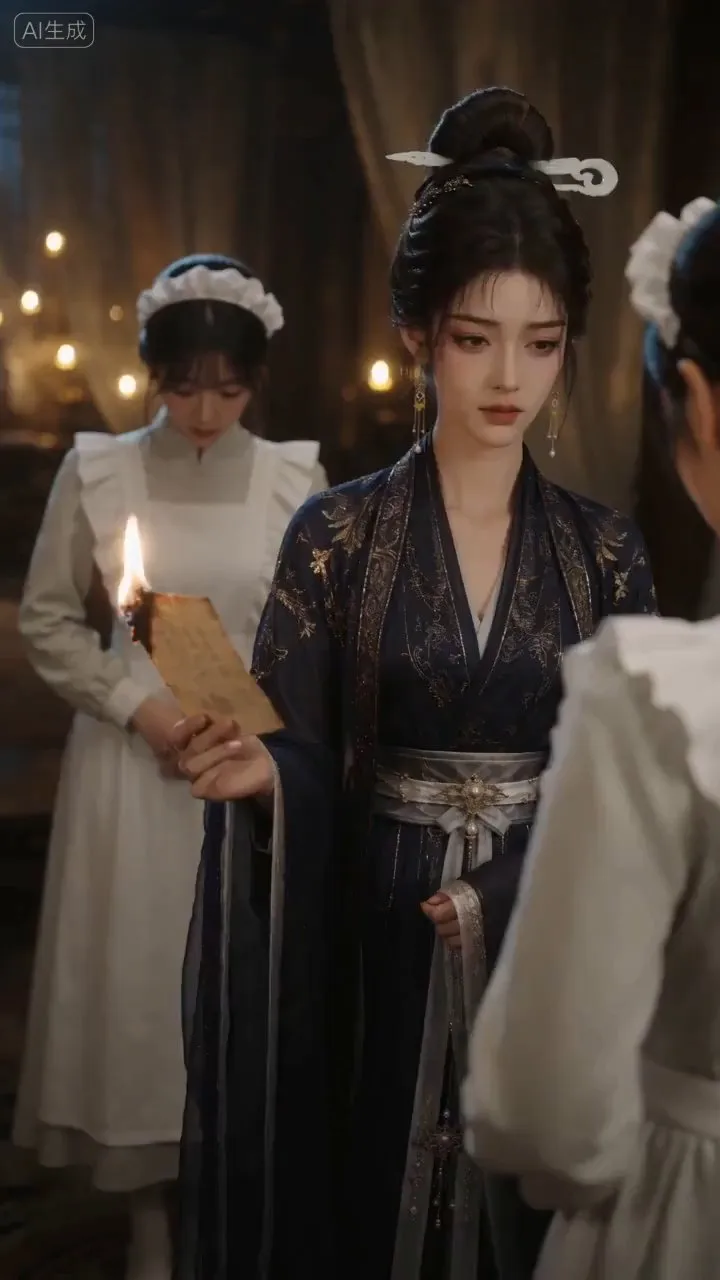
Prompts de vídeo y planos IA
Convierte una trama, la descripción de un personaje o unos prompts de vídeo existentes en storyboards profesionales para dramas cortos generados con IA y prompts de planos listos para usar. Ya se trate de escenas urbanas, de época, de suspense, emocionales o de venganza, trabaja en torno a las relaciones entre personajes, el ritmo narrativo y los ganchos emocionales para definir con claridad el tipo de plano, la posición de cámara, la perspectiva, el movimiento de cámara, la composición, la iluminación, el sonido ambiente y los diálogos. Así, cada plano cuenta con un foco visual claro y acciones ejecutables. La habilidad presta especial atención a la coherencia de los personajes y la continuidad de las escenas. Ayuda a fijar el aspecto, la lógica del vestuario, el estado de identidad y los detalles distintivos de cada personaje, reduciendo riesgos de cambios de rostro, alteraciones de apariencia, desorden espacial y acciones ambiguas durante la generación. La mirada, las expresiones, la respiración y las reacciones de las manos y el cuerpo también se convierten en cambios interpretativos visibles, lo que refuerza el conflicto, la tensión, los giros y la progresión emocional del drama corto. Puedes empezar con una trama completa o proporcionar recursos de personajes, storyboards o prompts existentes para optimizarlos de forma específica. Si ya tienes personajes definidos de manera estable, puedes reutilizarlos directamente para evitar diseñarlos de nuevo. Por último, todos los planos pueden organizarse en fragmentos de hasta 15 segundos, adecuados para generarse por partes con los principales modelos de vídeo de IA, conservando la información de imagen, sonido y duración para facilitar su copia, uso y edición posterior.
Asistente H3 de vídeo inverso
Entrega un vídeo de referencia completo a una IA multimodal para que descomponga automáticamente los planos reales, la línea temporal, los cambios visuales y los sonidos audibles, y genere prompts de nivel profesional listos para la creación de vídeos. No se limita a personas, anuncios o material cinematográfico: también sirve para productos, arquitectura y paisajes, animales, gastronomía, acciones deportivas, danza, animación 2D/3D, demostraciones de UI, grabaciones de pantalla, infografías, efectos visuales e imágenes abstractas, entre muchos otros temas. Según la estructura informativa del vídeo, el asistente puede generar un prompt completo de texto a vídeo o, para cada Shot, los prompts de imagen de referencia o del primer fotograma necesarios para crear vídeo de imagen a vídeo, descripciones del movimiento continuo, prompts del fotograma final cuando sean necesarios y restricciones de estabilidad a nivel de plano. Cuando son importantes tanto la imagen estática como los cambios temporales, también puede proporcionar ambas versiones. El contenido generado conserva la información que se puede confirmar en la práctica, como el sujeto, la composición, el movimiento de cámara, la relación causal de las acciones, los cambios estructurales, el texto, los diálogos, los sonidos ambientales y la música, y sigue cada plano hasta su estado final real. Cuando no es posible confirmar con claridad un texto, sonido, identidad, ubicación o método de grabación, el asistente evita completarlo por su cuenta. También distingue la imagen objetivo de elementos externos, como las marcas de agua del reproductor y las capas de control, para reducir la desviación del contenido durante la generación. Es adecuado para creadores y equipos de producción que necesiten obtener prompts de texto a vídeo o prompts de planos I2V a partir de vídeos de referencia, así como organizar materiales para reconstruir vídeos, reproducir estilos y producir publicidad generativa.
Director IA de vídeo
Convierte las descripciones cotidianas de escenas de vídeo o imágenes de los usuarios en prompts estructurados, propios de un director, para herramientas de generación como Seedance 2.0 / Runway / Luma / Pika / Kling / Stable Diffusion. Este Skill debe activarse cuando el usuario mencione «generar un vídeo», «prompt de vídeo», «storyboard de vídeo», «continuar una escena», «mantener la coherencia del personaje», «Seedance», «Runway», «Kling» o «Luma», o describa cualquier escena de vídeo o imagen que quiera generar. Incluso si solo dice «ayúdame a generar una imagen de XX» o «un vídeo de una escena de XX», también debe activarse.
Información
- Versión
- v6
- Última actualización
- Créditos por ejecución
- Según el uso
- Modelos
- Automático
