Optimizador de tokens
Optimizador de tokens
Vista previa
Descripción
Diagnostica el consumo de tokens de la sesión actual y ofrece sugerencias de optimización ejecutables de inmediato para ayudar al usuario a mejorar la eficiencia del diálogo y la velocidad de respuesta.
Recomendado por
nene@YouMind
Por qué recomendamos esta habilidad
Preocupado por la lentitud de la IA y el consumo de Token? Este asistente diagnostica y ofrece 3-5 sugerencias priorizadas, desde limpieza inmediata hasta hábitos a largo plazo, para mejorar la eficiencia y ahorrar recursos.
Habilidades relacionadas
Ver todo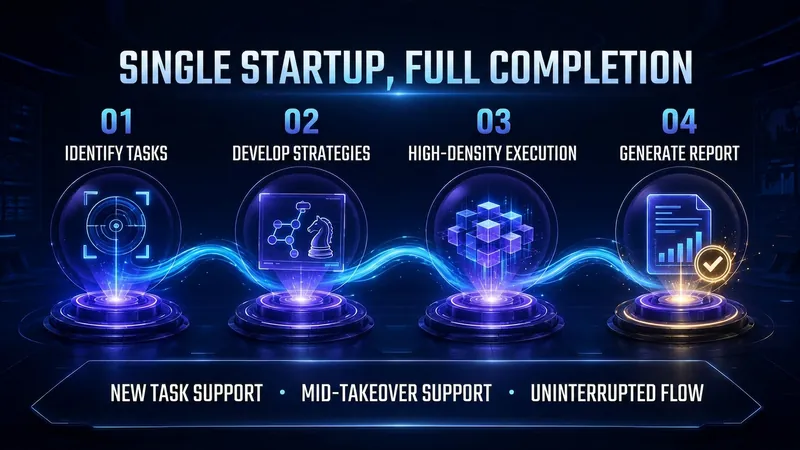
Token Ahorrador
¿Has calculado cuánto pagas cada mes por las 'palabras vacías' de la IA? —'Bien, déjame ayudarte...' —'Primero, repasemos tu pregunta...' —'En resumen, lo anterior es...' Estas frases no las lees, pero cada palabra descuenta tus tokens. 💸 Creé una Skill llamada «Token Ahorrador» para solucionarlo: ✅ Identifica automáticamente el tipo de tarea y aplica estrategias de ahorro de tokens ✅ Elimina redundancia sin perder profundidad, calidad intacta ✅ Al terminar, genera un informe detallado: esta vez ahorraste más del 40%, claro Los usuarios frecuentes de IA, instálala y recupera el costo de varios cafés. Un hecho que la mayoría ignora: una parte considerable de lo que pagas por la IA no es por la 'respuesta', sino por el 'lenguaje de proceso' —saludos iniciales, repetición de la pregunta, transiciones, resúmenes finales. Este contenido no genera valor, pero cada token cuenta. He encapsulado toda la metodología de optimización de densidad informativa en una Skill: «Token Ahorrador». Su lógica es directa: identifica el tipo de tarea, aplica estrategias de ahorro de tokens, ejecuta con máxima densidad informativa, elimina toda redundancia y, con restricciones estrictas, asegura que la calidad no disminuya. Al finalizar, genera un informe detallado de tokens, mostrando el consumo por fase, el ahorro respecto al modo estándar y sugerencias de optimización futura. Soporta inicio desde el principio o intervención a medio camino, sin necesidad de configuración. Si eres un usuario intensivo de IA —escritores, investigadores, creadores de contenido en masa, usuarios de API por consumo— esta Skill es una 'máquina de ahorro': instálala una vez y cada conversación reduce tus costos. Ya está disponible en el mercado de Skills de YouMind, busca «Token Ahorrador» para instalarla.
Gurú de optimización de Token
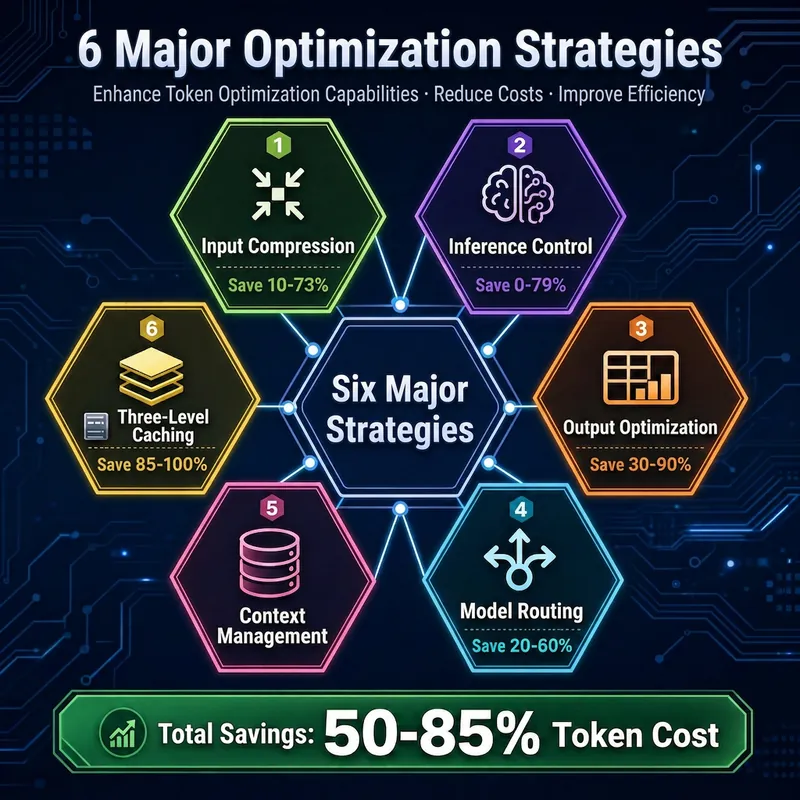
Detección inteligente · Optimización silenciosa · Cobertura total de YouMind. Detecta automáticamente oportunidades de optimización, aplica estrategias de forma silenciosa, compatible con tres tipos de entidades: Board, Chaos y 精灵. Basado en el costo real del modelo de YouMind, enrutamiento inteligente para seleccionar el modelo óptimo, logrando un ahorro de costos de Token del 50-85%. Después de la instalación, mediante la integración con Board Memory se logra un efecto de optimización casi automático, y la primera ejecución guía la configuración de forma automática.
Selector de modelos y ahorro
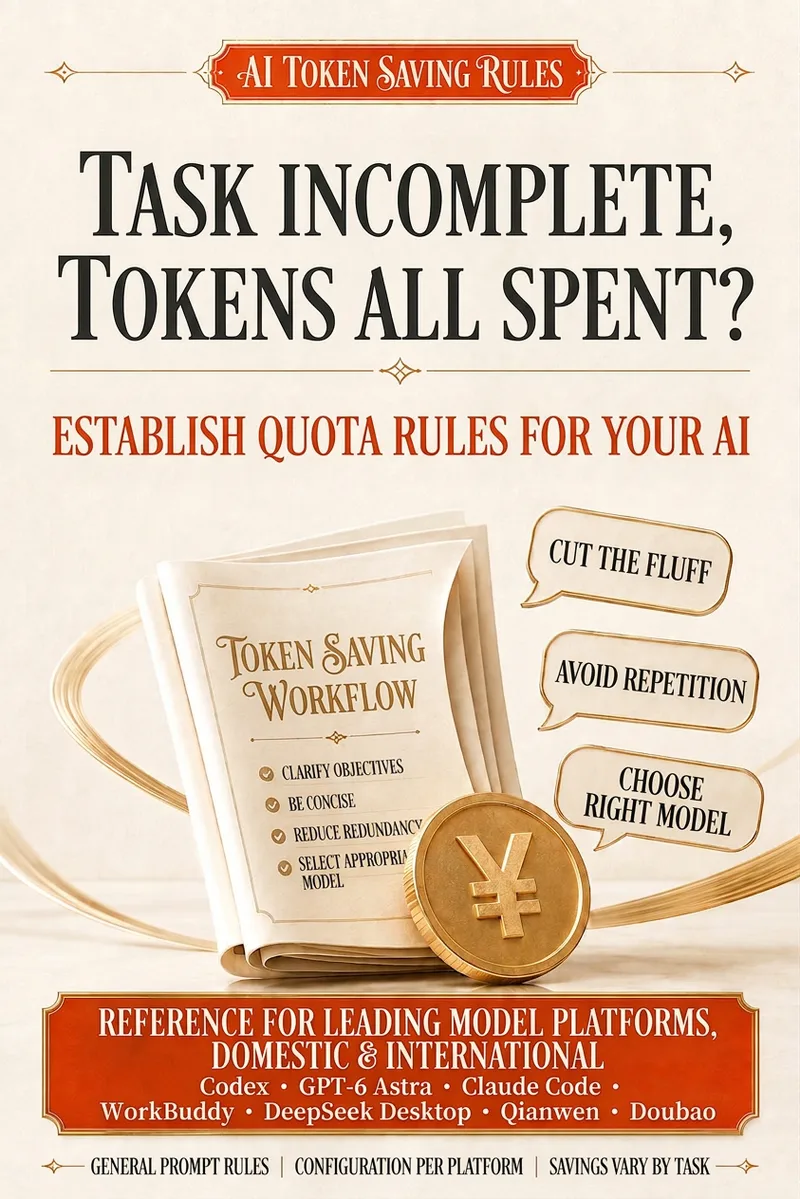
Según la dificultad de la tarea, el tipo de contenido y la fase del proyecto, te ayuda a elegir un modelo de IA más adecuado y a aplicar reglas de ahorro para reducir el consumo de tokens. Mientras controla el uso de la cuota, se encarga de tareas de programación, creación de contenido, planificación, diseño y análisis de información. Ya se trate de componentes de una página, integración con APIs, correcciones sencillas de errores, diseño de arquitectura, lógica compleja, revisión o refactorización de código, ofrece recomendaciones claras sobre el modelo y proporciona directamente el resultado necesario. También es adecuado para textos cotidianos, títulos y ganchos, contenido narrativo, propuestas de marca, planes de marketing, estructuras para PPT, ideas visuales, tendencias de mercado, análisis de la competencia e interpretación de datos. Para trabajos sencillos, por lotes o con formato definido, prioriza métodos que consuman menos cuota; cuando hay decisiones importantes, razonamientos complejos o una versión final que cerrar, te recuerda que conviene invertir en un modelo más adecuado para obtener calidad. Con el uso continuado, ajusta sus recomendaciones según tus preferencias de modelos, hábitos de salida, stack tecnológico del proyecto, decisiones clave, tareas pendientes y problemas conocidos, para reducir la comunicación repetitiva. En las tareas de código, se centra por defecto en los cambios esenciales y resume las modificaciones. En textos y propuestas, primero organiza el marco general y después lo desarrolla según sea necesario, para que cada conversación encaje mejor con el proyecto actual y tu ritmo de trabajo.
Información
- Versión
- v1
- Última actualización
- Créditos por ejecución
- Según el uso
- Modelos
- Automático
