Recherche bio/médicale fiable
Recherche bio/médicale fiable
Aperçu
Description
Scénario d'utilisation : effectuer une recherche de littérature scientifique dans le domaine de la biologie/biomédecine et fournir à l'utilisateur des résultats détaillés et fiables. 1. Après la demande de l'utilisateur, le système décompose la question et les mots-clés. 2. Utiliser des sources de données publiques et reproductibles pour rechercher la littérature. 3. Dédupliquer, hiérarchiser, classer par niveau de preuve et trier les résultats de recherche. 4. Utiliser des citations cliquables dans le corps de la réponse. 5. À la fin, lister chaque référence complète avec le facteur d'impact (IF) via une voie vérifiable publiquement ; si la vérification de haute confiance n'est pas possible, marquer comme « À vérifier » ou « Non détecté ».
Recommandé par
Nico@YouMind
Pourquoi nous recommandons cette compétence
Cette compétence est un guide fiable pour la recherche biomédicale, garantissant des informations scientifiques hautement précises et vérifiables grâce à des requêtes structurées, un filtrage documentaire en plusieurs étapes et une vérification rigoureuse des IF.
Instructions
Ce processus repose sur trois piliers : premièrement, l’utilisation de plusieurs requêtes pour effectuer un premier tri reproductible dans les utilitaires électroniques PubMed/NCBI ; deuxièmement, l’utilisation de PMID pour la déduplication et l’évaluation des preuves dans les résumés ; seul un petit nombre de documents clés sont soumis à l’examen du texte intégral dans PMC/BioC ; les citations dans le texte doivent être cliquables ; les informations bibliographiques complètes doivent figurer à la fin de l’article ; le facteur d’impact (FI) ne peut être vérifié qu’avec prudence à partir de sources accessibles au public et ne peut être présumé présent dans le JCR ou les bases de données locales, ni être deviné, et les correspondances de faible confiance ne peuvent être considérées comme des résultats définitifs.
1. Prétraitement après qu'un utilisateur a initié une recherche
1.1 Tout d'abord, analysez la question de l'utilisateur.
Après réception de la question d'un utilisateur, celle-ci, formulée en langage naturel, est d'abord décomposée en éléments structurés.
Doit être identifié :
• Sujets de recherche : gènes, protéines, médicaments, canaux, types cellulaires, tissus, maladies et modèles.
• Systèmes biologiques : humains, souris, rats, poissons-zèbres, organoïdes, rétine, régions du cerveau, lignées cellulaires, etc.
• Types de relations : expression, régulation, fonction, mécanisme, phénotype, mort, survie, traitement, toxicité, développement, dégénérescence, etc.
• Exigences en matière de preuves : Sont-elles requises des preuves directes, des preuves mécanistiques, des preuves en texte intégral, des graphiques, des paramètres de dosage et des méthodes expérimentales ?
• Période : illimitée, les 5 dernières années, la dernière année, les développements les plus récents et la littérature classique.
• Types de résultats : réponse courte, littérature représentative, résumé de l’analyse, suggestions de conception expérimentale, tableau des preuves, schéma du mécanisme.
Exemple:
Problème utilisateur :
« Veuillez m'aider à trouver de la documentation relative à la mort des organoïdes rétiniens. »
Décomposition structurée (exemple) :
• Modèles de base : organoïde rétinien, organoïde de rétine, organoïde rétinien dérivé de hPSC, organoïde de la cupule optique.
• Phénotype : mort cellulaire, apoptose, dégénérescence, perte de survie, stress, nécrose.
• Cellules apparentées : photorécepteur, cône, bâtonnet, cellule ganglionnaire rétinienne, glie de Müller.
• Mécanismes potentiels : stress oxydatif, stress du réticulum endoplasmique, dysfonctionnement mitochondrial, hypoxie, inflammation, ferroptose, nécroptose.
• Objectifs de recherche de preuves : Prioriser les études originales qui observent directement la mort cellulaire/l'apoptose/la dégénérescence dans les organoïdes rétiniens humains ou animaux ; puis rechercher des publications sur les mécanismes indirects.
1.2 Principes de segmentation par mots clés (Exemple)
Ne vous contentez pas d'une seule requête de recherche. Préparez au moins trois catégories de termes pour chaque concept.
Catégorie 1 : Mots précis.
• organoïde rétinien
• organoïde rétinien
• organoïde rétinien humain
• Organoïde rétinien dérivé de hPSC
• Organoïde rétinien dérivé de cellules iPSC
La deuxième catégorie : les synonymes et les hyperonymes.
• organoïde de la cupule optique
• Culture rétinienne 3D
• rétine dérivée de cellules souches
• Différenciation rétinienne
• Modèle de tissu rétinien
La troisième catégorie : termes liés au mécanisme et au phénotype.
• apoptose
• mort cellulaire
• dégénérescence
• survie
• stresser
• stress oxydatif
• Stress des ER
• dysfonctionnement mitochondrial
• hypoxie
• nécroptose
• ferroptose
Si l'utilisateur spécifie le type de cellule, ajoutez :
• photorécepteur
• cône
• tige
• cellule ganglionnaire rétinienne
• Müller glia
• cellule bipolaire
• cellule amacrine
Si l'utilisateur précise l'espèce ou l'origine, ajoutez :
• humain
• souris
• rat
• poisson-zèbre
• cellules souches embryonnaires humaines
• iPSC
• cellules souches pluripotentes
1.3 Génération de requêtes de recherche hiérarchiques
Générez au moins 3 à 6 requêtes. Chaque requête correspond à un objectif de recherche.
Première étape : Collecte directe des preuves.
Utilisé pour trouver la littérature qui correspond directement au modèle et au phénotype cibles.
```text
("organoïde rétinien" OU "organoïde de la rétine" OU "organoïde rétinien humain") ET (apoptose OU "mort cellulaire" OU dégénérescence)
```
Deuxième couche : Récupération de modèle étendue.
Utilisé pour recenser les publications où l'auteur n'utilise pas le terme précis « organoïde rétinien », mais où celui-ci est en réalité pertinent.
```text
(« organoïde de la coupe optique » OU « culture rétinienne 3D » OU « rétine dérivée de cellules souches ») ET (survie OU apoptose OU stress)
```
Troisième niveau : recherche spécifique au mécanisme.
Utilisé pour vérifier des voies ou des mécanismes spécifiques.
```text
(« organoïde rétinien » OU « organoïde de la rétine ») ET (« stress oxydatif » OU « stress du RE » OU hypoxie OU mitochondries)
```
Quatrième niveau : Recherche spécifique au type cellulaire.
```text
(« organoïde rétinien » OU « organoïde de la rétine ») ET (photorécepteur OU cône OU bâtonnet OU « cellule ganglionnaire rétinienne ») ET (mort OU apoptose OU dégénérescence)
```
Cinquième niveau : Récupération du modèle de maladie.
```text
(« organoïde rétinien » OU « organoïde de la rétine ») ET (maladie OU dégénérescence OU dystrophie OU rétinite OU glaucome)
```
Sixième niveau : Examen/Recherche de renseignements.
```text
("organoïde rétinien" OU "organoïde de la rétine") ET (revue OU protocole OU modèle)
```
2. Quelles méthodes et quels sites web ont été utilisés pour la recherche ?
2.1 Préférence : PubMed / NCBI E-utilities
PubMed est l'outil privilégié pour la recherche de littérature biomédicale. Évitez d'utiliser systématiquement l'extraction de données des pages PubMed. Privilégiez plutôt l'API NCBI E-utilities.
2.1.1 ESearch : Récupération du PMID à l’aide d’une requête
interface:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi
```
paramètre:
```text
db=publié
terme=
retmode=json
retmax=20
trier=pertinence
```
Vous pouvez également trier par date :
```text
trier=publication+date
```
Exemple:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=pubmed&term=(%22retinal%20organoid%22%20OR%20%22retina%20organoid%22)%20AND%20(apoptosis%20OR%20%22cell%20death%22)&retmode=json&retmax=20&sort=relevance
```
Lisez le texte de retour :
```text
esearchresult.idlist
```
Voici la liste des PMID.
2.1.2 ESummary : Obtention des métadonnées de la littérature
interface:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi
```
paramètre:
```text
db=publié
id=PMID1,PMID2,PMID3
retmode=json
```
Champs extraits :
• PMID
• titre
• nom complet du journal
• abréviation de la source/de la revue
• date de publication
• auteurs
• DOI et PMCID dans les identifiants d'articles
• volume, numéro, pages
2.1.3 EFetch : Récupération du résumé et des détails XML
interface:
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/efetch.fcgi
```
paramètre:
```text
db=publié
id=PMID1,PMID2
retmode=xml
rettype=abstrait
```
Champs extraits :
• Titre de l'article
• Texte abstrait
• Titre de la revue
• Abréviation ISO
• ISSN / eISSN
• Date de publication
• DOI
• PMCID
• Termes MeSH
2.1.4 Stratégie de récupération par lots
Processus recommandé :
1. Appelez ESearch pour chaque requête.
2. Pour chaque requête, sélectionnez les 5 à 20 premiers résultats.
3. Fusionner tous les PMID.
4. Utilisez PMID pour supprimer les doublons.
5. Utilisez ESummary / EFetch pour récupérer les métadonnées et les données abstraites par lots.
6. Lors de la phase de sélection initiale, ne lisez que les métadonnées et le résumé ; ne commencez pas par lire le texte intégral.
────────────────
2.2 Deuxième phase : Examen complet des documents PMC/BioC
Le texte intégral ne sera inclus que dans les cas suivants :
• Les utilisateurs demandent à lire attentivement le texte intégral.
• Le résumé est insuffisant pour déterminer le mécanisme.
• Nécessite des graphiques, des méthodes expérimentales, des concentrations, des dosages, IC50, EC50, Kd et Ki.
• Un petit nombre de PMID clés ont été identifiés et nécessitent un examen au cas par cas.
2.2.1 PMID vers PMCID
interface:
```text
https://www.ncbi.nlm.nih.gov/pmc/utils/idconv/v1.0/?ids=
```
Si le PMCID est renvoyé, cela signifie que le PMC peut avoir un accès au texte intégral.
2.2.2 Prioriser le JSON BioC
interface:
```text
https://www.ncbi.nlm.nih.gov/research/bionlp/RESTful/pmcoa.cgi/BioC_json/
```
Avantages : Très structuré, convient à l'extraction des principaux paragraphes du texte.
2.2.3 Essayez PMC XML lorsque BioC n'est pas disponible
interface:
```text
https://www.ncbi.nlm.nih.gov/pmc/articles/
```
Ignorer lors de l'extraction du texte principal :
• références
• bibliographie
• Remerciements
• Contributions des auteurs
• intérêts concurrents
L'examen du texte intégral doit inclure un critère d'arrêt :
• Chaque document n'est scanné qu'une seule fois.
• Par défaut, seuls les paragraphes relatifs à la question sont extraits.
• Si le champ cible ne correspond pas, indiquez « Aucune preuve directe trouvée ».
• Évitez de récupérer des mots-clés de manière répétée.
────────────────
2.3 bioRxiv / medRxiv
Utilisé pour compléter les prépublications les plus récentes.
Vous pouvez utiliser l'API officielle :
```text
https://api.biorxiv.org/details/biorxiv/YYYY-MM-DD/YYYY-MM-DD
https://api.biorxiv.org/details/medrxiv/YYYY-MM-DD/YYYY-MM-DD
```
Vous pouvez également utiliser une recherche classique en complément :
```text
site:biorxiv.org apoptose des organoïdes rétiniens
site:medrxiv.org dégénérescence des organoïdes rétiniens
```
Les prépublications doivent être étiquetées :
```text
Il s'agit d'une prépublication qui n'a pas encore été évaluée par des pairs.
```
────────────────
2.4 Crossref/OpenAlex/Unpaywall
Utilisé pour compléter le DOI, l'adresse d'accès au texte intégral et les informations de publication.
Crossref :
```text
https://api.crossref.org/works?query.title=<title>
```
OpenAlex :
```text
https://api.openalex.org/works?search=
```
Dépaywall :
```text
https://api.unpaywall.org/v2/
```
utiliser:
• Achèvement du DOI.
• Recherche de liens PDF OA.
• Vérification du nom du journal.
• Vérification de l'année de publication.
────────────────
2.5 Page de l'éditeur
N'accédez à la page de l'éditeur que lorsque les informations de l'API sont insuffisantes.
Règles d'accès :
• Chaque URL d'éditeur ne sera testée qu'une seule fois.
• Si vous rencontrez des CAPTCHA, des barrières de connexion, des messages Cloudflare, d'accès refusé ou des barrières d'accès institutionnelles, arrêtez immédiatement.
• Évitez d’actualiser sans cesse, de changer de chemin d’accès au sein du même site ou de rester bloqué dans une boucle.
• Utilisez les métadonnées PubMed, PMC, Crossref, OpenAlex, Unpaywall et DOI comme solution de repli.
3. Comment organiser les informations après leur récupération
3.1 Établir une structure d'enregistrement unifiée
Chaque document est compilé dans un enregistrement unifié.
Champs :
```text
PMID
doi
pmcid
titre
auteurs
journal
abréviation du journal
ISSN
eissn
année
abstrait
source de requête
niveau de preuve
balises de preuve
type_de_papier
URL
```
3.2 Déduplication
Priorité:
1. Déduplication PMID.
2. Utilisez le DOI pour supprimer les doublons si le PMID n'est pas disponible.
3. S'il n'y a pas de DOI, utilisez lower(title) + année + premier_auteur pour supprimer les doublons.
Conservez la source de requête qui a été utilisée la première fois et enregistrez les requêtes qui ont accédé au document.
3.3 Classification des preuves
Il est nécessaire de distinguer :
Preuve directe :
L’espèce cible, le tissu, le type cellulaire, le modèle et les conditions de traitement sont parfaitement alignés.
Preuves indirectes :
Les systèmes adjacents, les modèles similaires et les mécanismes similaires sont pris en charge, mais il ne s'agit pas de systèmes destinés directement à résoudre les problèmes des utilisateurs.
Aucune preuve directe n'a été trouvée :
On ne trouve que des informations générales, des spéculations, des analyses ou des modèles connexes ; il n'existe aucun résultat expérimental direct.
3.4 Étiquetage des types de documents
Il convient au moins de noter les points suivants :
• recherche originale
• revoir
• protocole
• prépublication
• ensemble de données/ressource
• étude clinique
• document de méthodologie
3.5 Règles de tri
Tri recommandé :
1. Recherche originale avec preuves directes.
2. Recherche sur les mécanismes clés.
3. Dernières recherches importantes.
4. Études fondamentales classiques.
5. Avis de haute qualité.
6. Preuve indirecte.
Ne triez pas uniquement selon le facteur d'impact. Le facteur d'impact est un indicateur au niveau de la revue et ne reflète pas la qualité d'un article individuel.
4. Comment organiser les citations dans une réponse
4.1 Format de citation du texte
Toutes les citations textuelles doivent être cliquables.
Format:
```markdown
[[1. **Journal**, Année]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
```
Exemple:
```markdown
Des études antérieures ont observé un stress et une dégénérescence des photorécepteurs liés au stade de développement dans les organoïdes rétiniens humains [[1. **Cell Stem Cell**, 2019]](https://pubmed.ncbi.nlm.nih.gov/xxxxxxx/).
```
Ne l'écrivez pas comme ceci :
```text
[1]
(PMID : xxxxx)
Voir la référence 1
```
4.2 Structure de réponse recommandée
Premier paragraphe : Conclusion directe.
```text
Conclusion : Des rapports pertinents ont été publiés, mais les preuves directes portent principalement sur… ; les preuves directes concernant… font encore défaut.
```
Deuxième paragraphe : Classification des preuves.
```text
Preuve directe :
- Référence A : ...
Preuves indirectes :
- Référence B : ...
Aucune preuve directe n'a été trouvée :
- Non trouvé lors de cette session...
```
Troisième paragraphe : Résumé du mécanisme.
Regrouper par sujet, par exemple :
• voie d'apoptose/caspase
• stress oxydatif
• dysfonctionnement mitochondrial
• Stress des ER
• hypoxie/stress métabolique
• inflammation
• inadéquation du développement
Quatrième paragraphe : Lacune en matière de recherche.
Indiquez clairement les points qui manquent de preuves directes.
Cinquième paragraphe : Inspiration tirée de l'expérience.
Si l'utilisateur a besoin d'un plan expérimental, veuillez fournir le marqueur, le dosage, le point temporel et le contrôle.
5. Liste complète des références à la fin de l'article
Si une référence spécifique est citée dans le texte, une liste complète doit être jointe à la fin de l'article.
Format:
```markdown
## Liste complète des informations de référence
1. Smith J et al., **Nom du journal** (2021), [PMID : 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Qn}*
2. Wang X et al., **Nom de la revue** (2022), [DOI : 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=À vérifier}*
```
Format de l'auteur :
• 1 à 3 auteurs : Veuillez tous les énumérer.
• Plus de 3 auteurs : Premier auteur et al.
Le PMID / DOI / URL doit être cliquable.
6. Vérification et étiquetage du FI
6.1 Tout d’abord, expliquons les limites pratiques des contrôles IF.
Normalement, le facteur d'impact officiel d'une revue est fourni par Clarivate Journal Citation Reports (JCR). Cependant, les organismes externes ne disposent généralement pas de compte Clarivate/JCR ni d'une table JCR locale ; il est donc déconseillé de le vérifier par cette voie.
```
6.2 Méthodes pratiques d'utilisation des compétences en intelligence artificielle
Route principale :
1. Si l'entrée est un PMID, utilisez d'abord les utilitaires électroniques du NCBI pour obtenir les métadonnées PubMed.
- Récupérer le nom complet de la revue. - Récupérer la source/l'abréviation ISO. - Récupérer l'ISSN/eISSN. - Récupérer les champs auxiliaires tels que le titre, l'année et le DOI.
2. Utilisez l'interface mobile JSON iikx/iscience, accessible au public, pour interroger les revues.
API de recherche :
```text
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=
```
API de détails :
```text
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=
```
3. Effectuer une correspondance prudente sur les résultats de la recherche.
- Priorise les correspondances exactes avec les titres normalisés des revues. - Priorise ensuite les correspondances exactes avec les abréviations. - Fait preuve d'une grande prudence avec les termes courts et généraux. - N'accepte pas les erreurs manifestes de correspondance avec des sous-chaînes, comme la confusion entre « Nature » et la série « Nature Reviews ». - Renvoie des résultats ambigus ou introuvables si la correspondance est instable, plutôt que de tenter une estimation.
4. Si PubMed fournit une abréviation, essayez de la développer en nom complet ou en titre alternatif à l'aide du catalogue NLM.
L'interface de recherche du catalogue NLM reste NCBI E-utilities :
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=[Abréviation du titre]&retmode=xml&retmax=1
```
Utilisez ensuite ESummary pour obtenir le titre / le titre alternatif.
5. Lisez les résultats détaillés de iikx :
- Facteur d'impact. - Année IF. - Quartile JCR. - Quartile CAS/CAS, le cas échéant. - URL source. - Niveau de confiance de la correspondance.
6. N’incluez pas l’année IF dans le texte principal lors de l’annotation ; utilisez des annotations concises.
La dernière annotation devrait simplement indiquer :
```text
*{SI=X,Qn}*
```
En cas d'échec :
```text
*{IF=Vérification en attente}*
```
ou:
```text
*{IF=Non détecté}*
```
6.3 Étapes spécifiques
Effectuez la procédure suivante pour chaque document.
Étape 1 : Préparer le nom de la recherche dans la revue.
Prioriser la récupération des métadonnées PubMed :
```text
Nom complet du journal
Abréviation ISO / Source
ISSN
eISSN
```
Si seul un DOI est disponible, utilisez d'abord Crossref ou OpenAlex pour obtenir le nom de la revue.
Crossref :
```text
https://api.crossref.org/works/
```
OpenAlex :
```text
https://api.openalex.org/works/https://doi.org/
```
Étape 2 : Normaliser les noms des revues.
Règles de normalisation :
• Tout en minuscules.
• Décompression HTML.
• Remplacez & par et.
• Supprimez la ponctuation.
• Combiner plusieurs espaces.
• Pour faire des comparaisons, vous pouvez également utiliser la forme compacte, qui supprime tous les espaces.
Exemple de pseudocode :
Python
importer re, html
def norm(s) :
s = html.unescape(s ou '').lower()
s = re.sub(r'&', ' et ', s)
s = re.sub(r'[^a-z0-9]+', ' ', s)
retourner re.sub(r'\s+', ' ', s).strip()
def compact(s) :
retourner norm(s).replace(' ', '')
```
Étape 3 : Interroger l'interface de recherche iikx.
```text
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=
```
Il est recommandé de définir un User-Agent, par exemple :
```text
Mozilla/5.0
```
Si aucune correspondance exacte n'est trouvée sur la première page, vous pouvez feuilleter un nombre limité de pages, par exemple, jusqu'à 8 pages.
Les paramètres de changement de page sont généralement les suivants :
```text
page=2
page=3
```
Étape 4 : Sélectionner les candidats parmi les résultats de la recherche.
Les domaines candidats comprennent généralement :
```text
identifiant
classifié
titre
petit titre
SI ou SI2024
zky2020
URL
```
Règles de correspondance :
• Si compact(query) == compact(candidate.title), accepter.
• Si norm(query) == norm(candidate.title), accepter.
• Si compact(query) == compact(candidate.smalltitle), accepter.
• Si norm(query) == norm(candidate.smalltitle), accepter.
• N’acceptez pas une sous-chaîne à moins que la requête ne soit suffisamment longue et non ambiguë.
• Soyez particulièrement prudent avec les mots courts tels que Nature, Science, Cellule, Cerveau, Vision et Rétine.
Étape 5 : Si aucune correspondance n’est trouvée, utilisez l’abréviation étendue du catalogue NLM.
Par exemple, dans PubMed, la source est :
```text
Biol Médicament des radicaux libres
```
Vous pouvez vérifier :
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=Free%20Radic%20Biol%20Med%5BTitle%20Abbreviation%5D&retmode=xml&retmax=1
```
Après avoir obtenu l'identifiant du catalogue NLM, utilisez-le comme suit :
```text
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi?db=nlmcatalog&id=
```
Lire:
```text
Titre
Titre alternatif
```
Utilisez ensuite ces noms complets pour rechercher iikx.
Étape 6 : Vérifiez l'interface des détails iikx.
Si les résultats de la recherche contiennent :
```text
id=
classid=
```
Appel:
```text
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=
```
Lire les détails :
```text
IF2024, IF2023, IF2022…
SI
zky2020 ou autres champs de quartile JCR
jcr22 / jcr12 ou champ de partition
ISSN
eissn
titre
petit titre
catégorie
```
Étape 7 : Sélectionnez la dernière instruction IF.
Recherchez dans les champs renvoyés toutes les occurrences du formulaire :
```text
IF20xx
```
Par exemple:
```text
IF2024
IF2023
IF2022
```
Choisissez l'année avec le plus grand chiffre significatif.
Si IF20xx est absent, essayez de lire :
```text
SI
valeur_si
```
Si aucune valeur valide n'est trouvée, elle est marquée comme non détectée.
Étape 8 : Afficher le niveau de confiance et l'étiquette.
Si le titre/l'abréviation correspond exactement et que les détails renvoient un IF valide :
```text
*{SI=X,Qn}*
```
Si le match est incertain :
```text
*{IF=Vérification en attente}*
```
Si l'API publique ne renvoie aucun résultat :
```text
*{IF=Non détecté}*
```
6.4 Format d'annotation IF
Format fixe :
```text
*{SI=X,Qn}*
```
Exemple:
```markdown
Smith J et al., **Neuron** (2020), [PMID : 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF = 15,0, Q1}*
```
Avis:
• L’année JCR n’est pas inscrite dans l’annotation IF.
• N’écrivez pas « 2024 JCR IF ».
• N’écrivez pas « JCR 2024 ».
• Seule l'année de publication est conservée.
• Si la valeur IF est 0,0, nulle, a une source instable ou une correspondance instable, le nombre ne sera pas affiché.
6.5 Gestion standard des échecs de vérification IF
Ne devinez pas.
N’utilisez pas le nom de la revue pour renseigner les numéros.
N’utilisez pas de grands modèles pour mémoriser et remplir des instructions IF.
Seuls trois états sont autorisés en cas d'échec :
```text
*{IF=Vérification en attente}*
```
Utilisé pour :
• Les résultats de la recherche sont vagues.
Il existe plusieurs revues similaires.
• Seule l'abréviation a été trouvée, mais le nom complet n'a pas pu être confirmé.
• Le facteur d'impact (FI) fourni par les sources publiques est discutable.
```text
*{IF=Non détecté}*
```
Utilisé pour :
• L'interface publique n'a renvoyé aucun résultat.
• La revue n'est pas indexée dans SCI/JCR.
• Ce nouveau numéro n'a pas encore de condition suspensive.
```text
*{IF=Non vérifiable publiquement}*
```
Utilisé pour :
• L’utilisateur a besoin d’un JCR officiel, mais l’agent actuel ne dispose pas des autorisations Clarivate/JCR.
7. Liste d'auto-vérification finale
À vérifier avant l'expédition :
• Faut-il répondre d'abord aux questions essentielles de l'utilisateur ?
• Faut-il faire une distinction entre preuves directes, preuves indirectes et absence de preuves directes ?
• Toutes les citations textuelles sont-elles cliquables ?
• L’article comporte-t-il une liste complète des références à la fin ?
• Chaque document comporte-t-il une étiquette IF (Entrée/Sortie) ou une étiquette indiquant une vérification en attente/non détectée ?
• Si le PMID/DOI/URL est cliquable.
• Permet-elle d'éviter de substituer des résultats globaux sur les tissus à des conclusions concernant des types cellulaires spécifiques ?
• Cela permet-il d'éviter de substituer l'activation/phosphorylation à une augmentation de l'expression totale ?
• Faut-il indiquer qu'il s'agit d'une prépublication ?
• Spécifie-t-il les limites de la recherche ?
• SI ce n'était pas basé sur la mémoire ou la conjecture.
8. Pseudocode reproductible
Python
requêtes = construire_requêtes(question_utilisateur)
tous_pmids = []
pour la requête dans les requêtes :
pmids = ncbi_esearch(query, retmax=20, sort='relevance')
all_pmids.extend(pmids)
pmids = deduplicate_keep_order(all_pmids)
métadonnées = ncbi_esummary(pmids)
résumés = ncbi_efetch_abstract(pmids)
enregistrements = fusionner_métadonnées_et_résumés(métadonnées, résumés)
enregistrements = étiquette_preuve(enregistrements, question_utilisateur)
enregistrements = rang_enregistrements(enregistrements)
sélectionné = sélectionner_meilleurs_enregistrements(enregistrements)
si besoin_texte_complet :
pour chaque enregistrement dans selected_key_records :
pmcid = idconv_pmid_to_pmcid(record.pmid)
si pmcid :
enregistrement.fulltext = fetch_bioc_or_pmc_xml(pmcid)
Pour enregistrer dans la sélection :
journal_query = record.full_journal_name ou record.journal_abbrev
si_résultat = lookup_if_public_iikx(requête_journal)
si_résultat.confiant :
record.if_annotation = f'*{IF={if_result.if_value},{if_result.quartile}}*'
elif if_result.ambiguous:
record.if_annotation = '*{IF=Vérification en attente}*'
autre:
record.if_annotation = '*{IF=Non détecté}*'
réponse = composer_réponse(
conclusion
groupes de preuves,
citations cliquables_corps,
liste_de_référence_complète_avec_si
)
```
9. Modèle de livraison finale recommandé
```markdown
en conclusion:
...
Niveau de preuve :
Preuve directe :
- ……[[1. **Journal**, Année]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
Preuves indirectes :
- …[[2. **Journal**, Année]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
Aucune preuve directe n'a été trouvée :
- ……
Résumé du mécanisme :
1. ……
2. ……
Limites de recherche :
Cette première phase de recherche a principalement porté sur PubMed, PMC, BioC et bioRxiv ; la sélection initiale s’est basée sur les métadonnées et les résumés, seuls les documents clés ayant fait l’objet d’une vérification du texte intégral. Les annotations d’impact ont été établies à partir de sources publiques ; les documents pour lesquels une correspondance avec certitude était impossible ont été marqués comme étant en attente de vérification ou non détectés.
Liste complète des informations bibliographiques :
1. Smith J et al., **Nom du journal** (2021), [PMID : 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Q1}*
2. Wang X et al., **Nom de la revue** (2022), [DOI : 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=À vérifier}*
```
Compétences associées
Tout voir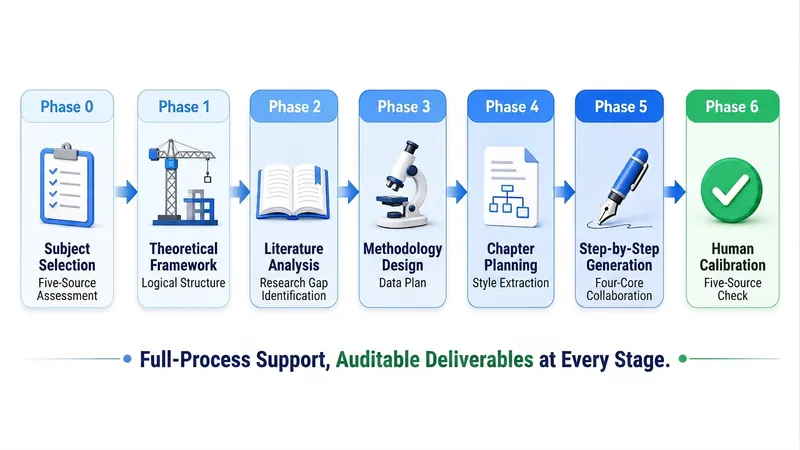
Diagnostic de thèse 5 sources
Avant d'investir des dizaines d'heures dans la rédaction de votre thèse, faites un bilan structuré en dix minutes. 【Cette compétence ne fait qu'une chose】 Diagnostic, pas de rédaction. Elle vous indique si votre sujet tient la route, si les matériaux sont suffisants, ce qui manque, où les compléter, et dans quel ordre, puis vous remet une liste de compléments exécutable et des formules de recherche. Elle ne rédigera pas votre introduction, votre revue de littérature, vos méthodes ou votre discussion. 【Quatre étapes】 1. Diagnostic disciplinaire : classez dans 1A Arts et humanités / 1B Sciences sociales / 2A Sciences et ingénierie / 2B Agriculture, médecine et sciences de la vie, et chargez les normes correspondantes ; la catégorie 2B bloque obligatoirement l'examen éthique. 2. Examen du sujet : vérifiez le sujet selon trois dimensions « potentiel·forme·mots », pour juger si l'unité de recherche est opérationnalisable, si la question de recherche peut être répondue, et si le sujet est déjà épuisé. 3. Examen des matériaux : enregistrez vos références dans une bibliothèque M1/M2…, vérifiez chaque entrée selon quatre éléments (auteur/année/titre/identifiant vérifiable), et calculez le taux de couverture réel. 4. Liste des lacunes et formules de recherche : précisez combien de références et de quels types manquent, quelle preuve fait défaut, et fournissez des formules de recherche directement collables dans les bases de données (avec combinaisons booléennes de mots-clés, plage de temps, critères de filtrage). 【Quand l'utiliser】(déclencheurs) « Aide-moi à faire un bilan de mon sujet », « Ce sujet est-il faisable ? », « Mes références sont-elles suffisantes ? », « Ma proposition a été rejetée », « Je veux vérifier avant de commencer à écrire » — pour les étudiants qui ont défini leur direction mais n'ont pas encore commencé ; ceux dont la proposition a été renvoyée sans savoir où est le problème ; ceux qui ont accumulé des références mais ne sont pas sûrs d'en avoir assez pour commencer ; ceux qui veulent confirmer si le sujet vaut la peine avant de s'investir. 【Livrables】 Un document « Rapport de bilan de proposition » + une carte de score de préparation à cinq sources (chaque niveau a des critères comportementaux, pas une note vague) + une liste priorisée des compléments + des formules de recherche + un code d'archivage. Ce code est compatible avec le « Système complet de rédaction d'articles académiques v4.0 » ; après le bilan, collez-le pour continuer sans avoir à redéfinir la discipline, le sujet ou la revue. 【Ce qui n'est pas fait】 Ne rédige pas le corps du texte, ne génère pas de bibliographie, n'invente pas d'auteurs, d'années, de volumes, de pages ou de DOI. Toute référence trouvée en ligne est marquée ⚠️ à vérifier ; vous devez la vérifier vous-même avant de l'utiliser. Cette compétence ne garantit aucune acceptation ou réussite.
 Recherche
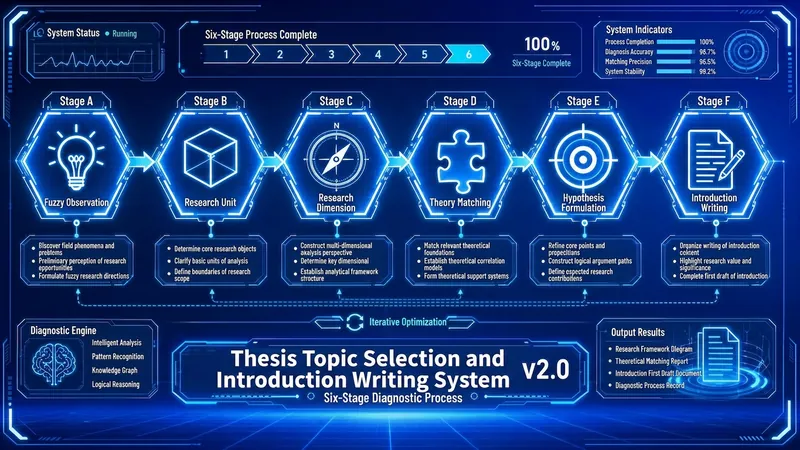
Sujet&Intro v3.2(5sources×AFP)
Compréhensible en 10 secondes : transformez une observation floue en un sujet solide, puis en une introduction recevable. Tout au long, utilisez uniquement vos matériaux réels, ne falsifiez aucun article. Mots déclencheurs : sujet de thèse, choix de sujet, introduction, lacune de recherche, écriture académique, ouverture de mémoire, choix de sujet avant revue de littérature. Convient à : articles de revue / thèses / articles de conférence / travaux de cours, toutes disciplines (sciences humaines, sociales, ingénierie, agriculture, médecine). Prise en main en 3 minutes : identifiez d'abord la discipline et le point de départ → façonnez le sujet couche par couche → contrôle strict de la chaîne de preuves → introduction modulaire → finalisation en cliquet. 【Division du travail avec d'autres compétences】Le bilan vient en premier, la rédaction ensuite, la révision en dernier. Cette compétence couvre la partie intermédiaire : la structuration du sujet et la première ébauche de l'introduction. Elle ne rédige pas le corps complet (c'est le rôle de 《学术论文全流程撰写系统 v4.x》), ni n'affine le langage phrase par phrase (c'est celui de 《学术论文三轨润色系统 v8.x》). 【Les six points de contrôle】1. Classement disciplinaire : 1A Arts et humanités / 1B Sciences sociales / 2A Sciences et ingénierie / 2B Agriculture, médecine et sciences de la vie ; chargez les lignes rouges normatives correspondantes ; pour 2B, l'état de l'examen éthique est systématiquement demandé. 2. Positionnement de l'étape : êtes-vous à une observation floue, avez-vous une unité sans angle, un objet sans théorie, sans méthode, sans point de vue, ou manque-t-il seulement l'introduction ? Partez du point de contrôle correspondant, ne recommencez pas à zéro. 3. Structuration du sujet : unité de recherche → boussole des dimensions → perspective théorique → méthode de recherche → point de vue de recherche ; verrouillez chaque niveau, en vérifiant d'abord que le niveau précédent tient. 4. Contrôle strict de la chaîne de preuves : avant l'introduction, vos références doivent être enregistrées dans une base M1/M2… ; chaque entrée est vérifiée selon quatre éléments : auteur/année/titre/localisateur ; si la position de dialogue compte moins de 3 entrées, le système refuse de générer l'énoncé de lacune de recherche — non pas une réduction, mais un refus. 5. Génération modulaire : l'introduction est produite en cinq modules selon une pyramide inversée ; chaque module doit porter la référence [Mn] ; aucune phrase sans source. 6. Finalisation en cliquet : on n'ajoute des points qu'aux versions déjà validées ; les modules conformes sont verrouillés et ne sont plus modifiés ; le score ne fait que monter. 【Livrables】Document 《[选题关键词]·Sujet et introduction》 + tableau de correspondance des citations traçables phrase par phrase + ⚠️liste à vérifier + code d'archive AFP. Ce code est compatible avec le 开题体检器, le système complet v4.x et le système de polissage à trois voies ; en changeant de compétence, vous n'avez pas à redéfinir la discipline, le sujet, la revue ou la base de références. 【Ce que cette compétence ne fait pas】Elle n'invente pas d'auteurs, d'années, de volumes, de pages ou de DOI ; toute référence trouvée en ligne est marquée ⚠️ à vérifier, vous devez la valider avant de l'inclure dans la bibliographie ; aucune promesse d'acceptation ou de validation. La paternité et la responsabilité vous incombent — veuillez vérifier chaque citation et donnée.
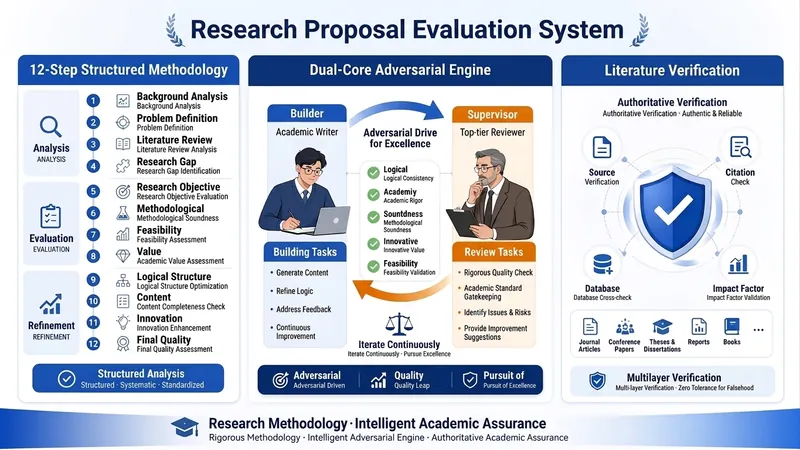
Optimisation de prop. PRO V2.0
🎯 Présentation des fonctionnalités principales Il s'agit d'un système intelligent d'évaluation et d'optimisation conçu spécifiquement pour les propositions de projets CNSF, MEN et provinciaux. Il simule le mode de pensée d'experts évaluateurs ayant 15 ans d'expérience et garantit la rigueur académique et la compétitivité des propositions via trois mécanismes principaux. 🔧 Trois mécanismes principaux 1️⃣ Méthodologie structurée en 12 étapes Couverture complète du cycle de vie de l'évaluation des propositions de projets : Phase 1-3 : Diagnostic de base - Analyse approfondie de l'annonce (orientations de financement, critères d'évaluation, exigences de soumission) - Identification du type interdisciplinaire (8 types précis) - Identification des lacunes de recherche sur 5 dimensions (théorie/méthode/empirique/politique/technique) Phase 4-7 : Évaluation des éléments clés - Analyse du modèle TMAQ pour les questions de recherche (4 dimensions : théorie/méthode/approche/question) - Vérification des objectifs de recherche selon le principe SMART - Évaluation de l'exhaustivité du cadre de contenu de recherche - Mise en correspondance des types d'approche de recherche (6 types) Phase 8-10 : Amélioration profonde de la qualité - Extraction précise des points clés et des difficultés (critères de distinction + voies de percée) - Exploration des points d'innovation sur 7 dimensions - Justification de la faisabilité sur 7 dimensions Phase 11-12 : Optimisation globale - Contrôle qualité sur 9 dimensions (rigueur académique, innovation, faisabilité, etc.) - Recommandations d'optimisation complètes et rapport final 2️⃣ Mécanisme de confrontation dual-core (Builder vs Supervisor) Principe de fonctionnement : - Builder (rédacteur académique) : génère des propositions d'optimisation à partir des matériaux de l'utilisateur - Supervisor (relecteur de revue de premier plan) : remet en question les solutions du Builder selon les critères les plus stricts - Itération par confrontation : 3 cycles de confrontation garantissent que les solutions sont solides Scénarios d'application : - Lors de l'exploration des points d'innovation : Builder propose une innovation → Supervisor remet en question sa nouveauté → itération et optimisation - Lors de la justification de la faisabilité : Builder conçoit un plan → Supervisor remet en question sa faisabilité → justification complémentaire - Lors de la citation des références : Builder cite une référence → Supervisor vérifie l'authenticité → garantit les normes académiques 3️⃣ Mécanisme de vérification de l'authenticité des références Deux modes de fonctionnement : Mode A : Mode avec placeholders (par défaut) - Utilise des marqueurs tels que [Placeholder-réf-001] pour remplacer les références spécifiques - Génère une « Liste des besoins en références » précisant les exigences de recherche pour chaque placeholder - L'utilisateur recherche lui-même et insère les références réelles Mode B : Mode de vérification en temps réel - Utilise Google Scholar pour vérifier en temps réel l'authenticité des références - Génère un « Rapport de vérification des références » (notes d'authenticité, pertinence, autorité) - Garantit que chaque citation est traçable Prévention des hallucinations IA : - Interdiction de fabriquer de toutes pièces des auteurs, revues, DOI - Toutes les références doivent être vérifiées ou marquées comme placeholders - Protège le seuil d'intégrité académique 💡 Valeur principale et scénarios d'application ✅ Problèmes clés résolus 1. Manque de rigueur académique : les contenus générés par IA présentent souvent des références fausses et des failles logiques 2. Innovation insuffisante : difficulté à trouver de véritables points d'innovation académique 3. Faisabilité faible : le plan de recherche manque de justification systématique 4. Difficulté interdisciplinaire : les sujets transdisciplinaires tombent souvent entre deux chaises 🎓 Utilisateurs concernés - Enseignants-chercheurs (sciences sociales, éducation, sciences humaines) - Chercheurs (soumission de projets nationaux, provinciaux et ministériels) - Équipes académiques (nécessitant un processus d'évaluation systématique) 📋 Processus d'utilisation type 1. Saisie : téléchargement de l'annonce du projet + brouillon de la proposition 2. Évaluation : le système effectue une analyse structurée en 12 étapes 3. Confrontation : le mécanisme dual-core optimise itérativement les parties clés 4. Vérification : contrôle de l'authenticité des références 5. Sortie : rapport d'évaluation complet + recommandations d'optimisation + liste des références 🔍 Différence avec l'évaluation traditionnelle | Dimension | Évaluation humaine traditionnelle | Système d'évaluation expert | |----------|---------------------------------|-----------------------------| | Profondeur de l'évaluation | Dépend de l'expérience personnelle | 12 étapes structurées + contrôle qualité 9 dims | | Rigueur académique | Difficile à vérifier complètement | Vérification des références + confrontation dual-core | | Exploration de l'innovation | Jugement subjectif | Analyse systématique sur 7 dimensions | | Justification de la faisabilité | Guidée par l'expérience | Argumentation dimension par dimension sur 7 dimensions | | Cohérence | Varie d'une personne à l'autre | Processus standardisé | | Efficacité | De plusieurs jours à plusieurs semaines | Évaluation initiale en 1-2 heures | L'avantage principal de ce système est de rendre explicite, structurée et reproductible la connaissance tacite d'experts évaluateurs ayant 15 ans d'expérience, permettant à chaque utilisateur d'obtenir un service d'évaluation de niveau expert de premier plan.
Informations
- Version
- v5
- Dernière mise à jour
- Crédits par exécution
- Selon l’utilisation
- Modèles
- Claude Sonnet 4.5
- Fonctionnalités
- Recherche sur le Web