Mosaïque de sous-titres
Créez de longues images avec sous-titres
Mosaïque de sous-titres
Créez de longues images avec sous-titres
Aperçu
Description
Transformez des vidéos locales ou en ligne autorisées en images longues de sous-titres au format 3:4 ou au format d'origine, grâce à la récupération de sources, l'alignement de transcriptions, la sélection de répliques, la capture d'images précise, le rognage, l'assemblage et le contrôle qualité. Deux modes distincts sont pris en charge : le mode natif pour conserver les sous-titres déjà incrustés dans l'image, et le mode script pour dessiner les repères et répliques vérifiés sur les images vidéo réelles. Idéal pour les captures de sous-titres natifs, les mosaïques de cadres, les citations longues de YouTube, les captures de répliques, ou pour ajuster les proportions, la zone de sous-titres et l'espacement.
Recommandé par
Dancang
Pourquoi nous recommandons cette compétence
Cette compétence distingue clairement les sous-titres natifs des sous-titres scriptés, évitant les modifications superflues tout en structurant les dialogues vérifiés en images partageables. Elle intègre également la vérification des locuteurs et le contrôle qualité.
Idéal pour
Idéal pour les créateurs et éditeurs souhaitant transformer les sous-titres ou répliques d'une vidéo en images longues partageables.
Comment utiliser ce Skill
Fournir les éléments
Fournissez une vidéo locale ou en ligne que vous êtes autorisé à traiter, puis indiquez le mode de sous-titres, les repères temporels ou répliques, et le format d'image souhaité.
Lancer le Skill
Sélection et vérification des images et sous-titres, conservation des originaux ou incrustation des répliques validées selon le mode choisi, puis assemblage et contrôle qualité.
Vérifier le résultat
Obtenez une ou plusieurs images longues de sous-titres de vidéos, accompagnées de données temporelles ou de répliques ainsi que d'un aperçu global.
Compétences associées
Tout voir
Assistant de prompts vidéo H3
Confiez une vidéo de référence complète à une IA multimodale pour analyser automatiquement les plans réels, la timeline, les changements visuels et les sons audibles, puis générer des prompts de niveau professionnel, directement utilisables pour la création vidéo. L’outil ne se limite pas aux personnes, aux publicités ou aux films : il convient aussi aux présentations de produits, à l’architecture et aux paysages, aux animaux, à la gastronomie, aux mouvements sportifs, à la danse, aux animations 2D/3D, aux démonstrations d’interface, aux enregistrements d’écran, aux infographies, aux effets visuels et aux images abstraites. Selon la structure des informations de la vidéo, l’assistant peut produire un prompt complet de conversion texte-vidéo, ou générer pour chaque plan les prompts d’image de référence ou de première image nécessaires à la conversion image-vidéo, ainsi qu’une description du mouvement continu, les prompts de dernière image nécessaires et des contraintes de stabilité propres au plan. Lorsque l’image fixe et l’évolution dans le temps sont toutes deux importantes, il peut également fournir les deux versions. Le contenu généré conserve les informations réellement confirmables sur le sujet, la composition, les mouvements de caméra, la logique des actions, les changements structurels, les textes, les dialogues, les sons ambiants et la musique, tout en suivant chaque plan jusqu’à son état final réel. Lorsque les textes, sons, identités, lieux ou méthodes de prise de vue ne peuvent pas être confirmés clairement, l’assistant évite de les compléter arbitrairement. Il distingue également l’image recherchée des éléments externes, comme le filigrane du lecteur ou les éléments de contrôle, afin de réduire les dérives de contenu lors de la génération. Il s’adresse aux créateurs et équipes de production qui souhaitent déduire des prompts de conversion texte-vidéo ou des prompts de plans I2V à partir d’une vidéo de référence, ou préparer des ressources pour la reconstruction vidéo, la reproduction de style et la création de publicités génératives.
 Vidéo
Générateur de vidéos de fables
Transformez rapidement un proverbe, une anecdote traditionnelle ou une fable en storyboard narratif séquentiel, directement utilisable pour générer une vidéo. Qu’il s’agisse de «守株待兔», «掩耳盗铃», «司马光砸缸» ou d’un proverbe saisi directement par l’utilisateur, l’outil restitue le contexte de l’histoire, les relations entre les personnages, les actions clés et la morale, puis les organise en une intrigue claire et rythmée pour une courte vidéo. Deux versions sont proposées par défaut : 15 et 30 secondes. La version de 15 secondes présente rapidement l’intrigue principale, tandis que celle de 30 secondes ajoute davantage de mise en place, de réactions des personnages et d’actions culminantes, pour une histoire plus complète et plus dramatique. Chaque plan précise l’émotion, le type de cadrage, les mouvements de caméra et la narration nécessaire. Les personnages disposent également de caractéristiques visuelles stables afin de rester cohérents d’un plan à l’autre et de s’adapter aux modèles courants de génération vidéo. Toute la narration est rédigée au format voix off ou parole prononcée par les personnages, afin que le modèle vidéo fasse réellement entendre les répliques plutôt que de les afficher à l’écran. Le style par défaut est celui de l’animation en dessin animé. Vous pouvez aussi demander un style à l’encre, en papier découpé, en ombres chinoises, réaliste ou autre, ou choisir une seule durée. Le script final est entièrement rédigé en chinois et comprend l’atmosphère des scènes, l’apparence des personnages, le contenu visuel des plans et les exigences de cohérence. Il convient à la création d’animations de proverbes, de fables, de courts-métrages d’inspiration chinoise et de vidéos sur la culture traditionnelle destinées aux enfants ou au grand public.
 Vidéo
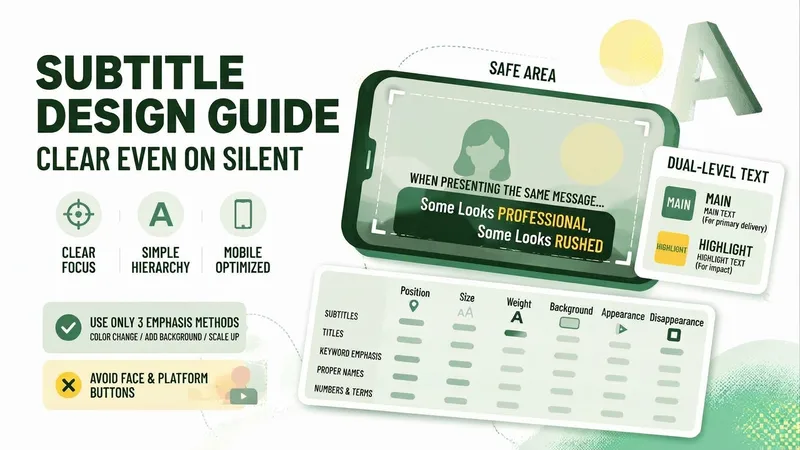
Mise en page des sous-titres
Pour juger si des sous-titres sont réussis, un seul critère compte : sur un téléphone, à taille de pouce et en lecture sans le son, peut-on comprendre la phrase d’un seul coup d’œil ? 【Fiche de mise en page des sous-titres】 commence par trois règles strictes : la zone de sécurité (les marges à laisser en haut, en bas et sur les côtés, avec des indications distinctes pour le format vertical et horizontal), la limite de caractères par ligne (et pourquoi elle existe : le nombre de caractères lisibles en une seconde est limité) et une hiérarchie à deux niveaux seulement (texte principal et texte mis en avant ; un troisième niveau crée forcément de la confusion). Elle fournit ensuite un tableau de paramètres directement utilisable : pour les sous-titres, les titres, les mots-clés mis en avant, les noms de personnes et de lieux, ainsi que les nombres et noms propres, chaque élément reçoit une position, une taille relative, une graisse, l’indication d’un fond ou non, et un moment d’apparition et de disparition ; les zones à éviter autour des visages et des boutons de la plateforme sont également indiquées. Pour mettre en avant un mot-clé, seules trois méthodes sont proposées (changer la couleur, ajouter un fond ou augmenter la taille), avec la consigne de n’en choisir qu’une. S’y ajoutent six pratiques qui donnent le plus une impression d’amateurisme et leurs corrections, ainsi qu’une méthode simple de vérification sur téléphone en mode silencieux. Règles strictes : ne pas rédiger de répliques ni de script, ne pas recommander de fichiers de polices précis, ne pas expliquer comment déformer ou masquer du texte pour contourner la modération d’une plateforme, ne pas juger l’apparence ou l’accent de l’utilisateur et ne pas promettre un taux de visionnage complet.
Informations
- Version
- v4
- Dernière mise à jour
- Crédits par exécution
- Selon l’utilisation
- Modèles
- Automatique
- Cas d’usage
- Images et design
- Ce que vous obtenez
- ImageDonnées