Ricerca Bio/Med approfondita
Ricerca Bio/Med approfondita
Anteprima
Descrizione
Scenario applicativo: completare un ciclo di ricerca di letteratura scientifica biologica/biomedica e fornire all'utente output dettagliati e affidabili. 1. Dopo che l'utente ha avviato la ricerca, il sistema scompone il problema e le parole chiave. 2. Utilizza fonti di dati pubbliche e riproducibili per cercare la letteratura. 3. Esegue deduplicazione, stratificazione, classificazione delle prove e ordinamento dei risultati della ricerca. 4. Nella risposta, utilizza citazioni cliccabili nel testo. 5. Alla fine del testo, elenca le informazioni complete della letteratura una per una e segna l'IF utilizzando percorsi verificabili pubblicamente; se la verifica ad alta confidenza non è possibile, deve essere contrassegnato come 'da verificare' o 'non rilevato'.
Consigliato da
Nico@YouMind
Perché consigliamo questa abilità
Questa abilità è una guida affidabile per la ricerca biomedica, attraverso query strutturate, filtro della letteratura in più fasi e verifica rigorosa dell'IF, garantendo informazioni scientifiche altamente accurate e verificabili.
Istruzioni
Il fulcro di questo processo è: in primo luogo, utilizzare query multiple per eseguire uno screening iniziale riproducibile in PubMed/NCBI E-utilities, quindi utilizzare PMID per la deduplicazione e la valutazione delle prove degli abstract; solo un piccolo numero di documenti chiave entra nella revisione del testo completo di PMC/BioC; le citazioni nel testo devono essere cliccabili; le informazioni bibliografiche complete devono essere elencate alla fine dell'articolo; l'Impact Factor può essere verificato solo in modo conservativo attraverso fonti accessibili al pubblico e non si può presumere che abbia JCR o database locali, non può essere ipotizzato e le corrispondenze a bassa affidabilità non possono essere considerate risultati definitivi.
1. Pre-elaborazione successiva all'avvio di una ricerca da parte dell'utente
1.1 Innanzitutto, analizza la domanda dell'utente.
Dopo aver ricevuto la domanda dell'utente, la domanda in linguaggio naturale viene innanzitutto scomposta in elementi strutturati.
Deve essere identificato:
• Argomenti di ricerca: geni, proteine, farmaci, canali ionici, tipi cellulari, tessuti, malattie e modelli.
• Sistemi biologici: esseri umani, topi, ratti, pesci zebra, organoidi, retina, regioni cerebrali, linee cellulari, ecc.
• Tipi di relazioni: espressione, regolazione, funzione, meccanismo, fenotipo, morte, sopravvivenza, trattamento, tossicità, sviluppo, degenerazione, ecc.
• Requisiti delle prove: se sono necessarie prove dirette, prove meccanicistiche, prove a testo completo, grafici, parametri di dosaggio e metodi sperimentali.
• Intervallo temporale: tempo illimitato, gli ultimi 5 anni, l'ultimo anno, gli ultimi sviluppi e la letteratura classica.
• Tipologie di output: risposta breve, letteratura rappresentativa, riassunto della revisione, suggerimenti per la progettazione sperimentale, tabella delle evidenze, diagramma del meccanismo.
Esempio:
Problema riscontrato dall'utente:
"Vi prego di aiutarmi a trovare della letteratura scientifica relativa alla morte degli organoidi retinici."
Decomposizione strutturata (esempio):
• Modelli principali: organoide retinico, organoide della retina, organoide retinico derivato da hPSC, organoide della coppa ottica.
• Fenotipo: morte cellulare, apoptosi, degenerazione, perdita di sopravvivenza, stress, necrosi.
• Cellule correlate: fotorecettore, cono, bastoncello, cellula gangliare della retina, glia di Müller.
• Possibili meccanismi: stress ossidativo, stress del reticolo endoplasmatico, disfunzione mitocondriale, ipossia, infiammazione, ferroptosi, necroptosi.
• Obiettivi di ricerca: dare priorità agli studi originali che osservano direttamente la morte cellulare/apoptosi/degenerazione negli organoidi retinici umani o animali; quindi cercare la letteratura sui meccanismi indiretti.
1.2 Principi di segmentazione per parole chiave (Esempio)
Non limitarti a scrivere una sola query di ricerca. Prepara almeno tre categorie di termini per ogni concetto.
Categoria 1: Parole precise.
• organoide retinico
• organoide retinico
• organoide retinico umano
• Organoide retinico derivato da hPSC
• Organoide retinico derivato da iPSC
La seconda categoria: sinonimi e iperonimi.
• organoide della coppa ottica
• Coltura retinica 3D
• retina derivata da cellule staminali
• differenziazione retinica
• modello di tessuto retinico
La terza categoria: meccanismi e termini fenotipici.
• apoptosi
• morte cellulare
• degenerazione
• sopravvivenza
• stress
• stress ossidativo
• Stress del reticolo endoplasmatico
• disfunzione mitocondriale
• ipossia
• necroptosi
• ferroptosi
Se l'utente specifica il tipo di cella, aggiungere:
• fotorecettore
• cono
• asta
• cellula gangliare retinica
• Glia di Müller
• cellula bipolare
• cellula amacrina
Se l'utente specifica la specie o l'origine, aggiungere:
• umano
• topo
• ratto
• pesce zebra
• hESC
• cellule staminali pluripotenti indotte (iPSC)
• cellula staminale pluripotente
1.3 Generazione di query di ricerca gerarchiche
Genera almeno 3-6 query. Ogni query corrisponde a un obiettivo di ricerca.
Primo livello: Recupero diretto delle prove.
Utilizzato per trovare la letteratura che corrisponde direttamente al modello e al fenotipo di riferimento.
```testo
("organoide retinico" O "organoide retinico" O "organoide retinico umano") E (apoptosi O "morte cellulare" O degenerazione)
```
Secondo livello: Recupero esteso del modello.
Utilizzato per indicare la letteratura in cui l'autore non usa il termine preciso "organoide retinico", ma che è comunque pertinente.
```testo
("organoide della coppa ottica" OPPURE "coltura retinica 3D" OPPURE "retina derivata da cellule staminali") E (sopravvivenza OPPURE apoptosi OPPURE stress)
```
Il terzo livello: la ricerca specifica del meccanismo.
Utilizzato per verificare percorsi o meccanismi specifici.
```testo
("organoide retinico" O "organoide retinico") E ("stress ossidativo" O "stress del reticolo endoplasmatico" O ipossia O mitocondri)
```
Quarto livello: ricerca specifica per tipo di cellula.
```testo
("organoide retinico" O "organoide retinico") E (fotorecettore O cono O bastoncello O "cellula gangliare retinica") E (morte O apoptosi O degenerazione)
```
Quinto livello: recupero del modello di malattia.
```testo
("organoide retinico" O "organoide retinico") E (malattia O degenerazione O distrofia O retinite O glaucoma)
```
Sesto livello: Revisione/ricerca preliminare.
```testo
("organoide retinico" O "organoide retinico") E (revisione O protocollo O modello)
```
2. Quali metodi e siti web sono stati utilizzati per la ricerca?
2.1 Preferito: PubMed / Servizi elettronici NCBI
PubMed è lo strumento preferito per la ricerca nella letteratura biomedica. Non affidatevi esclusivamente allo scraping delle pagine di PubMed. Utilizzate invece l'API NCBI E-utilities.
2.1.1 ESearch: Recupero del PMID tramite una query
interfaccia:
```testo
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi
```
parametro:
```testo
database=pubmed
termine=
retmode=json
retmax=20
ordinamento=pertinenza
```
È possibile ordinare anche per periodo di tempo:
```testo
sort=pub+date
```
Esempio:
```testo
Italiano: https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=pubmed&term=(%22retinal%20organoid%22%20OR%20%22retina%20organoid%22)%20AND%20(apoptosis%20OR%20%22cell%20death%22)&retmode=json&retmax=20&sort=relevance
```
Leggi il resoconto:
```testo
esearchresult.idlist
```
Questo è l'elenco PMID.
2.1.2 Riepilogo: Acquisizione dei metadati della letteratura
interfaccia:
```testo
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi
```
parametro:
```testo
database=pubmed
id=PMID1,PMID2,PMID3
retmode=json
```
Campi estratti:
• PMID
• titolo
• nome completo della rivista
• abbreviazione della fonte/rivista
• data di pubblicazione
• autori
• DOI e PMCID negli articoli
• volume, numero, pagine
2.1.3 EFetch: Recupero del riepilogo e dei dettagli XML
interfaccia:
```testo
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/efetch.fcgi
```
parametro:
```testo
DB=pubmed
id=PMID1,PMID2
retmode=xml
rettype=abstract
```
Campi estratti:
• Titolo dell'articolo
• Testo astratto
• Titolo della rivista
• Abbreviazione ISO
• ISSN / eISSN
• Data di pubblicazione
• DOI
• PMCID
• Termini MeSH
2.1.4 Strategia di recupero batch
Procedura consigliata:
1. Richiamare ESearch per ogni query.
2. Per ogni query, seleziona i primi 5-20 risultati.
3. Unire tutti i PMID.
4. Utilizzare PMID per rimuovere i duplicati.
5. Utilizzare ESummary/EFetch per recuperare metadati e dati astratti in batch.
6. Nella fase di screening iniziale, leggere solo i metadati e l'abstract; non iniziare leggendo il testo completo.
────────────────
2.2 Seconda fase: revisione completa dei documenti PMC/BioC
Il testo completo verrà incluso solo nei seguenti casi:
• Gli utenti chiedono di leggere attentamente il testo completo.
• L'abstract non è sufficiente a determinare il meccanismo.
• Richiede grafici, metodi sperimentali, concentrazioni, dosaggi, IC50, EC50, Kd e Ki.
• È stato identificato un piccolo numero di PMID chiave che richiedono una revisione caso per caso.
2.2.1 Da PMID a PMCID
interfaccia:
```testo
https://www.ncbi.nlm.nih.gov/pmc/utils/idconv/v1.0/?ids=
```
Se viene restituito PMCID, significa che PMC potrebbe avere accesso al testo completo.
2.2.2 Assegnare priorità ai file JSON di BioC
interfaccia:
```testo
https://www.ncbi.nlm.nih.gov/research/bionlp/RESTful/pmcoa.cgi/BioC_json/
```
Vantaggi: Altamente strutturato, adatto all'estrazione dei paragrafi principali del testo.
2.2.3 Prova PMC XML quando BioC non è disponibile
interfaccia:
```testo
https://www.ncbi.nlm.nih.gov/pmc/articles/
```
Salta durante l'estrazione del testo principale:
• riferimenti
• bibliografia
• Ringraziamenti
• contributi dell'autore
• interessi concorrenti
La revisione del testo completo deve includere un criterio di arresto:
• Ogni documento viene scansionato una sola volta.
• Per impostazione predefinita, vengono estratti solo i paragrafi relativi alla domanda.
• Se il campo di destinazione non corrisponde, contrassegnarlo come "Nessuna prova diretta trovata".
• Evitare di estrarre ripetutamente le parole chiave.
────────────────
2.3 bioRxiv / medRxiv
Utilizzato per integrare le ultime versioni preliminari.
È possibile utilizzare l'API ufficiale:
```testo
https://api.biorxiv.org/details/biorxiv/YYYY-MM-DD/YYYY-MM-DD
https://api.biorxiv.org/details/medrxiv/YYYY-MM-DD/YYYY-MM-DD
```
È possibile utilizzare anche una ricerca standard come complemento:
```testo
sito:biorxiv.org apoptosi degli organoidi retinici
sito:medrxiv.org degenerazione organoide della retina
```
I preprint devono essere etichettati:
```testo
Si tratta di una versione preliminare e non è stata sottoposta a revisione paritaria.
```
────────────────
2.4 Crossref/OpenAlex/Unpaywall
Utilizzato per completare il DOI, l'indirizzo per aprire il testo completo e le informazioni sulla pubblicazione.
Crossref:
```testo
https://api.crossref.org/works?query.title=<title>
```
OpenAlex:
```testo
https://api.openalex.org/works?search=
```
Unpaywall:
```testo
https://api.unpaywall.org/v2/
```
utilizzo:
• Completamento del DOI.
• Ricerca di link PDF ad accesso aperto.
• Verifica del nome della rivista.
• Verifica dell'anno di pubblicazione.
────────────────
2.5 Pagina dell'editore
Accedi alla pagina dell'editore solo se le informazioni API sono insufficienti.
Regole di accesso:
• Ogni URL dell'editore verrà tentato una sola volta.
• Se riscontri CAPTCHA, problemi di accesso, Cloudflare, accesso negato o barriere di accesso istituzionali, interrompi immediatamente.
• Evita di aggiornare ripetutamente la pagina, di cambiare percorso all'interno dello stesso sito o di rimanere in un ciclo infinito.
• Utilizzare PubMed, PMC, Crossref, OpenAlex, Unpaywall e i metadati DOI come alternativa.
3. Come organizzare le informazioni dopo il recupero
3.1 Stabilire una struttura di registrazione unificata
Ciascun documento viene raccolto in un record unificato.
Campi:
```testo
pmid
doi
pappagallo
titolo
autori
diario
abbreviazione di rivista
ISSN
eissn
anno
astratto
origine_di_query
livello di evidenza
etichette di evidenza
tipo di carta
URL
```
3.2 Deduplicazione
Priorità:
1. Deduplicazione del PMID.
2. Utilizzare il DOI per rimuovere i duplicati se il PMID non è disponibile.
3. Se non è presente un DOI, utilizzare lower(title) + year + first_author per rimuovere i duplicati.
Conserva la query_source che è stata raggiunta la prima volta e registra quali query hanno raggiunto il documento.
3.3 Classificazione delle prove
È necessario distinguere:
Prove dirette:
La specie bersaglio, il tessuto, il tipo di cellula, il modello e le condizioni di trattamento vengono abbinati direttamente.
Prove indirette:
Sistemi adiacenti, modelli simili e meccanismi analoghi sono supportati, ma non costituiscono sistemi diretti per la risoluzione dei problemi degli utenti.
Non sono state trovate prove dirette:
Si possono trovare solo informazioni di base, speculazioni, recensioni o modelli correlati; non ci sono risultati sperimentali diretti.
3.4 Etichettatura del tipo di documento
Almeno quanto segue andrebbe notato:
• ricerca originale
• revisione
• protocollo
• preprint
• set di dati/risorsa
• studio clinico
• documento metodologico
3.5 Regole di ordinamento
Ordinamento consigliato:
1. Ricerca originale con prove dirette.
2. Ricerca sui meccanismi chiave.
3. Le più recenti ricerche importanti.
4. Studi fondamentali classici.
5. Recensione di alta qualità.
6. Prove indirette.
Non basate la vostra selezione esclusivamente sull'Impact Factor (IF). L'IF è un indicatore a livello di rivista e non corrisponde alla qualità del singolo articolo.
4. Come organizzare le citazioni in una risposta
4.1 Formato di citazione del testo
Tutte le citazioni nel testo devono essere cliccabili.
Formato:
```markdown
[[1. **Rivista**, Anno]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
```
Esempio:
```markdown
Studi precedenti hanno osservato stress e degenerazione dei fotorecettori correlati allo stadio di sviluppo negli organoidi retinici umani [[1. **Cell Stem Cell**, 2019]](https://pubmed.ncbi.nlm.nih.gov/xxxxxxx/).
```
Non scriverlo in questo modo:
```testo
[1]
(PMID: xxxxx)
Vedi riferimento 1
```
4.2 Struttura di risposta consigliata
Primo paragrafo: Conclusione diretta.
```testo
Conclusione: sono state pubblicate segnalazioni pertinenti, ma le prove dirette si concentrano principalmente su...; mancano ancora prove dirette riguardanti...
```
Secondo paragrafo: Classificazione delle prove.
```testo
Prove dirette:
- Riferimento A: ...
Prove indirette:
- Riferimento B: ...
Non sono state trovate prove dirette:
- Non trovato in questo giro...
```
Terzo paragrafo: Riepilogo del meccanismo.
Raggruppa per argomento, ad esempio:
• via apoptotica/caspasi
• stress ossidativo
• disfunzione mitocondriale
• Stress del reticolo endoplasmatico
• ipossia/stress metabolico
• infiammazione
• disallineamento dello sviluppo
Quarto paragrafo: Lacuna nella ricerca.
Indicare chiaramente quali questioni non dispongono di prove dirette.
Quinto paragrafo: Ispirazione tratta dall'esperimento.
Se l'utente necessita di un progetto sperimentale, deve fornire il marcatore, il test, il punto temporale e il controllo.
5. Elenco completo delle fonti bibliografiche alla fine dell'articolo
Se nel testo viene citato un riferimento specifico, è necessario allegare un elenco completo alla fine dell'articolo.
Formato:
```markdown
## Elenco completo delle informazioni di riferimento
1. Smith J et al., **Nome della rivista** (2021), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Qn}*
2. Wang X et al., **Nome della rivista** (2022), [DOI: 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=Da verificare}*
```
Formato immagine:
• 1–3 autori: Elencarli tutti.
• Più di 3 autori: Primo autore e altri.
Il PMID / DOI / URL deve essere cliccabile.
6. Verifica e etichettatura IF
6.1 Innanzitutto, spieghiamo i limiti pratici dei controlli IF.
Normalmente, il fattore di impatto ufficiale di una rivista proviene da Clarivate Journal Citation Reports (JCR). Tuttavia, gli enti esterni in genere non dispongono di un account Clarivate/JCR o di una tabella JCR locale, quindi è sconsigliabile verificarlo tramite questo canale.
```
6.2 Metodi pratici per l'utilizzo delle competenze IF
Percorso principale:
1. Se l'input è PMID, utilizzare innanzitutto NCBI E-utilities per ottenere i metadati PubMed.
- Recupera il nome completo della rivista. - Recupera l'abbreviazione sorgente/ISO. - Recupera l'ISSN/eISSN. - Recupera i campi ausiliari come titolo, anno e DOI.
2. Utilizzare l'interfaccia JSON mobile iikx/iscience, disponibile pubblicamente, per interrogare le riviste.
API di ricerca:
```testo
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=
```
Dettagli API:
```testo
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=
```
3. Eseguire una corrispondenza conservativa sui risultati della ricerca.
- Dà priorità alle corrispondenze esatte dei titoli delle riviste normalizzati. - In secondo luogo, dà priorità alle corrispondenze esatte delle abbreviazioni. - Presta molta attenzione ai termini brevi e generici. - Non accetta evidenti discrepanze nelle sottostringhe, come ad esempio la corrispondenza errata tra "Nature" e la serie "Nature Reviews". - Restituisce risultati ambigui/non trovati se la corrispondenza è instabile, anziché procedere per tentativi.
4. Se PubMed fornisce un'abbreviazione, prova ad espanderla al nome completo o al titolo alternativo utilizzando il catalogo NLM.
L'interfaccia di ricerca del catalogo NLM rimane NCBI E-utilities:
```testo
Italiano: https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=[Abbreviazione del titolo]&retmode=xml&retmax=1
```
Quindi usa ESummary per ottenere il titolo / il titolo alternativo.
5. Leggere i risultati dettagliati di iikx:
- Fattore di impatto. - Anno IF. - Quartile JCR. - Quartile CAS/CAS, se applicabile. - URL di origine. - Affidabilità della corrispondenza.
6. Non includere l'anno IF nel testo principale durante l'annotazione; utilizzare annotazioni compatte.
L'annotazione finale dovrebbe solo indicare:
```testo
*{SE = X, Qn}*
```
Se non funziona:
```testo
*{IF=Verifica in corso}*
```
O:
```testo
*{IF=Non rilevato}*
```
6.3 Passaggi specifici
Eseguire la seguente procedura per ciascun documento.
Passaggio 1: Preparare il nome per la ricerca nella rivista.
Dare priorità al recupero dei metadati da PubMed:
```testo
Nome completo della rivista
Abbreviazione ISO / Fonte
ISSN
eISSN
```
Se è disponibile solo un DOI, utilizzare innanzitutto Crossref o OpenAlex per ottenere il nome della rivista.
Crossref:
```testo
https://api.crossref.org/works/
```
OpenAlex:
```testo
https://api.openalex.org/works/https://doi.org/
```
Fase 2: Standardizzare i nomi delle riviste.
Regole di standardizzazione:
• Tutto in minuscolo.
• Codifica HTML.
• Sostituire & con and.
• Rimuovere la punteggiatura.
• Unire più spazi.
• Quando si effettuano confronti, è possibile utilizzare anche la forma compatta, che elimina tutti gli spazi.
Esempio di pseudocodice:
Pitone
import re, html
norma(e) di riferimento:
s = html.unescape(s o '').lower()
s = re.sub(r'&', ' e ', s)
s = re.sub(r'[^a-z0-9]+', ' ', s)
restituisci re.sub(r'\s+', ' ', s).strip()
def compact(s):
restituisci norma(s).sostituisci(' ', '')
```
Passaggio 3: Interrogare l'interfaccia di ricerca di iikx.
```testo
https://m.iikx.com/api/restfull/?m=sci&c=index&a=info&keyword=
```
Si consiglia di impostare uno User-Agent, ad esempio:
```testo
Mozilla/5.0
```
Se nella prima pagina non viene trovata una corrispondenza esatta, è possibile sfogliare un numero limitato di pagine, ad esempio fino a 8 pagine.
I parametri per il cambio pagina sono generalmente i seguenti:
```testo
pagina=2
pagina=3
```
Passaggio 4: Selezionare i candidati dai risultati della ricerca.
I campi di candidatura tipici includono:
```testo
id
classificato
titolo
titolo piccolo
IF o IF2024
zky2020
URL
```
Regole di abbinamento:
• Se compact(query) == compact(candidate.title), accetta.
• Se norm(query) == norm(candidate.title), accetta.
• Se compact(query) == compact(candidate.smalltitle), accetta.
• Se norm(query) == norm(candidate.smalltitle), accetta.
• Non accettare una sottostringa a meno che la query non sia sufficientemente lunga e non ambigua.
• Prestare particolare attenzione alle parole brevi come Natura, Scienza, Cellula, Cervello, Vista e Retina.
Passaggio 5: Se non viene trovata alcuna corrispondenza, utilizzare l'abbreviazione estesa del catalogo NLM.
Ad esempio, in PubMed, la fonte è:
```testo
Biomedicina dei Radicali Liberi
```
Puoi controllare:
```testo
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esearch.fcgi?db=nlmcatalog&term=Free%20Radic%20Biol%20Med%5BTitle%20Abbreviation%5D&retmode=xml&retmax=1
```
Dopo aver ottenuto l'ID del catalogo NLM, utilizzarlo nel modo seguente:
```testo
https://eutils.ncbi.nlm.nih.gov/entrez/eutils/esummary.fcgi?db=nlmcatalog&id=
```
Leggere:
```testo
Titolo
Titolo alternativo
```
Quindi usa questi nomi completi per cercare iikx.
Passaggio 6: Verificare l'interfaccia dei dettagli di iikx.
Se i risultati della ricerca contengono:
```testo
id=
classid=
```
Chiamata:
```testo
https://m.iikx.com/api/restfull/?m=sci/index/detail&id=
```
Leggi attentamente i dettagli:
```testo
IF2024, IF2023, IF2022 ...
SE
zky2020 o altri campi del quartile JCR
jcr22 / jcr12 o campo di partizione
ISSN
eissn
titolo
titolo piccolo
categoria
```
Passaggio 7: Selezionare l'istruzione IF più recente.
Cerca nei campi restituiti tutte le occorrenze del modulo:
```testo
IF20xx
```
Per esempio:
```testo
IF2024
IF2023
IF2022
```
Scegli l'anno con la cifra significativa più alta.
Se IF20xx non è presente, tentare di leggere:
```testo
SE
valore se
```
Se non viene trovato alcun valore valido, viene contrassegnato come non rilevato.
Passaggio 8: Visualizzare il livello di confidenza e l'etichetta.
Se il titolo/abbreviazione corrisponde esattamente e il dettaglio restituisce un IF valido:
```testo
*{SE = X, Qn}*
```
Se l'esito della partita è incerto:
```testo
*{IF=Verifica in corso}*
```
Se l'API pubblica non restituisce risultati:
```testo
*{IF=Non rilevato}*
```
6.4 Formato di annotazione IF
Formato fisso:
```testo
*{SE = X, Qn}*
```
Esempio:
```markdown
Smith J et al., **Neuron** (2020), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=15.0, Q1}*
```
Avviso:
• L'anno JCR non è scritto all'interno dell'annotazione IF.
• Non scrivere "2024 JCR IF".
• Non scrivere "JCR 2024".
• Viene conservato solo l'anno di pubblicazione.
• Se l'IF è 0.0, nullo, ha una sorgente instabile o una corrispondenza instabile, il numero non verrà visualizzato.
6.5 Gestione standard per gli errori di controllo IF
Non fare supposizioni.
Non utilizzare il nome della rivista per inserire i numeri.
Non utilizzare modelli di grandi dimensioni per memorizzare e compilare istruzioni IF.
In caso di fallimento sono consentiti solo tre stati:
```testo
*{IF=Verifica in corso}*
```
Utilizzato per:
• I risultati della ricerca sono vaghi.
Esistono diverse riviste simili.
• È stata trovata solo l'abbreviazione, ma non è stato possibile confermare il nome completo.
• L'IF (Indice di Fattore) fornito da fonti pubblicamente disponibili è discutibile.
```testo
*{IF=Non rilevato}*
```
Utilizzato per:
• L'interfaccia pubblica non ha restituito alcun risultato.
• La rivista non è indicizzata da SCI/JCR.
• Il nuovo numero non ha ancora un IF.
```testo
*{IF=Non verificabile pubblicamente}*
```
Utilizzato per:
• L'utente necessita di un JCR ufficiale, ma l'agente corrente non dispone delle autorizzazioni Clarivate/JCR.
7. Autovalutazione finale
Da verificare prima della spedizione:
• È opportuno rispondere prima alle domande principali dell'utente?
• Se distinguere tra prove dirette, prove indirette e assenza di prove dirette.
• Tutte le citazioni nel testo sono cliccabili?
• L'articolo contiene un elenco completo delle fonti bibliografiche?
• Ogni documento include un'etichetta IF (Input/Output) o un'etichetta che indica "in attesa di verifica/non rilevato"?
• Se il PMID/DOI/URL è cliccabile.
• Evita di sostituire i risultati complessivi sul tessuto con conclusioni relative a specifici tipi di cellule?
• Evita di sostituire l'attivazione/fosforilazione con un aumento dell'espressione totale?
• Indicare se si tratta di una pre-pubblicazione.
• Specifica i limiti della ricerca?
• Se non si basava sulla memoria o su supposizioni.
8. Pseudocodice riproducibile
Pitone
query = build_queries(user_question)
tutti_pmid = []
per la query nelle query:
pmids = ncbi_esearch(query, retmax=20, sort='relevance')
tutti_pmids.estend(pmids)
pmids = deduplicate_keep_order(all_pmids)
metadati = ncbi_esummary(pmids)
abstract = ncbi_efetch_abstract(pmids)
record = unisci_metadati_e_abstract(metadati, abstract)
record = tag_evidence(record, user_question)
record = record_classifica(record)
selezionati = select_top_records(records)
se è necessario_testo_completo:
per record in selected_key_records:
pmcid = idconv_pmid_to_pmcid(record.pmid)
se pmcid:
record.fulltext = fetch_bioc_or_pmc_xml(pmcid)
Per la registrazione nei selezionati:
journal_query = record.full_journal_name or record.journal_abbrev
if_result = lookup_if_public_iikx(journal_query)
se_risultato_fiducioso:
record.if_annotation = f'*{IF={if_result.if_value},{if_result.quartile}}*'
elif if_result.ambiguous:
record.if_annotation = '*{IF=In attesa di verifica}*'
altro:
record.if_annotation = '*{IF=Not Detected}*'
risposta = componi_risposta(
conclusione
gruppi di evidenza,
citazioni cliccabili nel corpo del testo,
elenco_di_riferimento_completo_con_if
)
```
9. Modello di consegna finale consigliato
```markdown
Insomma:
...
Livello di evidenza:
Prove dirette:
- ……[[1. **Rivista**, Anno]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
Prove indirette:
- …[[2. **Rivista**, Anno]](https://pubmed.ncbi.nlm.nih.gov/PMID/)
Non sono state trovate prove dirette:
- ……
Riepilogo del meccanismo:
1. ……
2. ……
Limiti di ricerca:
Questa fase di ricerca ha coinvolto principalmente PubMed, PMC, BioC e bioRxiv; lo screening iniziale si è basato su metadati e abstract, e solo i documenti chiave sono stati sottoposti a verifica del testo completo. Le annotazioni dell'Impact Factor si basavano su fonti accessibili al pubblico; i documenti che non potevano essere abbinati con elevata affidabilità sono stati contrassegnati come in attesa di verifica o non rilevati.
Elenco completo delle informazioni bibliografiche:
1. Smith J et al., **Nome della rivista** (2021), [PMID: 12345678](https://pubmed.ncbi.nlm.nih.gov/12345678/). *{IF=X,Q1}*
2. Wang X et al., **Nome della rivista** (2022), [DOI: 10.xxxx/xxxxx](https://doi.org/10.xxxx/xxxxx). *{IF=Da verificare}*
```
Abilità correlate
Vedi tutto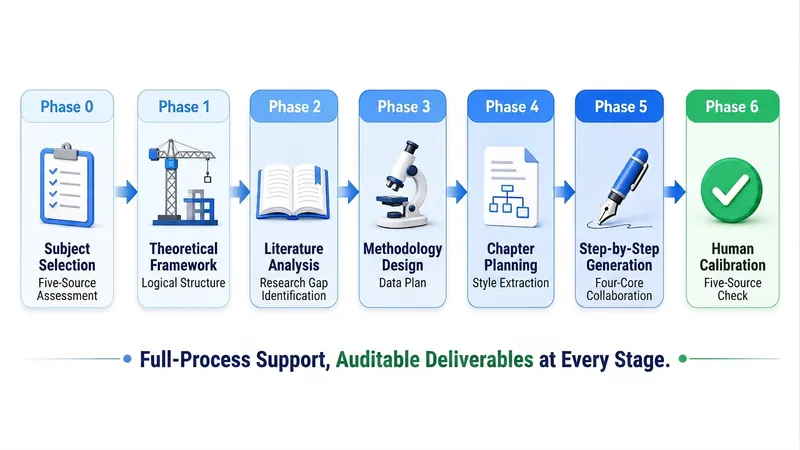
Check-up di tesi
Prima di dedicare decine di ore alla scrittura della tesi, dedica dieci minuti a un check-up strutturato. 【Questa skill fa solo una cosa】 Diagnosi, non scrive per te. Ti dice: se l'argomento regge, se i materiali bastano, cosa manca, dove recuperarli, in che ordine integrarli, e poi ti consegna una lista di integrazione eseguibile e stringhe di ricerca. Non scrive per te introduzione, revisione della letteratura, metodologia o discussione. 【Quattro fasi】 1. Diagnosi disciplinare: classifica in 1A Arti e umanistiche / 1B Scienze sociali / 2A Scienze e ingegneria / 2B Agraria, medicina e scienze della vita, caricando le corrispondenti linee rosse normative; per la categoria 2B, la revisione etica viene bloccata obbligatoriamente. 2. Check del tema: esamina il tema da tre dimensioni «slancio·forma·parole», per capire se l'unità di ricerca può essere operazionalizzata, se la domanda di ricerca può trovare risposta e se l'argomento è già stato sfruttato. 3. Check dei materiali: registra la tua bibliografia in una libreria di materiali M1/M2…, verifica per ogni voce i quattro elementi (autore/anno/titolo/localizzatore verificabile) e calcola il tasso di copertura reale. 4. Elenco delle lacune e stringhe di ricerca: chiarisce quanti e quali tipi di documenti mancano, quale anello di prove è assente, e fornisce stringhe di ricerca da incollare direttamente nei database (con combinazioni booleane di parole chiave, intervallo temporale, criteri di selezione). 【Quando usarla】(frasi trigger) «Aiutami a fare il check-up della proposta di tesi» «Questo argomento si può fare?» «Ho abbastanza letteratura?» «La mia proposta di tesi è stata respinta» «Prima di iniziare a scrivere voglio verificare» — Studenti post-laurea che hanno appena definito la direzione ma non hanno ancora iniziato a scrivere; quelli a cui è stata respinta la proposta ma non sanno qual è il problema; quelli che hanno accumulato una montagna di letteratura ma non sono sicuri se basta per iniziare; chi vuole verificare se l'argomento merita di essere approfondito prima di impegnarsi seriamente. 【Risultati】 Un documento «Rapporto di check-up della proposta di tesi» + una scheda di valutazione della prontezza a cinque fonti (ogni livello ha criteri di valutazione comportamentali, non punteggi vaghi) + un elenco prioritario di integrazione + stringhe di ricerca + un codice di archiviazione. Il codice di archiviazione è compatibile con il 《学术论文全流程撰写系统 v4.0》, quindi dopo il check-up puoi incollarlo direttamente e continuare a scrivere senza dover ridefinire disciplina, argomento o rivista. 【Cosa non fa】 Non scrive il testo principale, non genera elenchi di riferimenti, non inventa autori, anni, volumi, pagine o DOI. I documenti trovati online sono sempre contrassegnati con ⚠️ da verificare; devi verificarli tu stesso prima di usarli. Questa skill non garantisce alcun esito di accettazione o superamento.
 Ricerca
Sistema argomento e intro v3.2
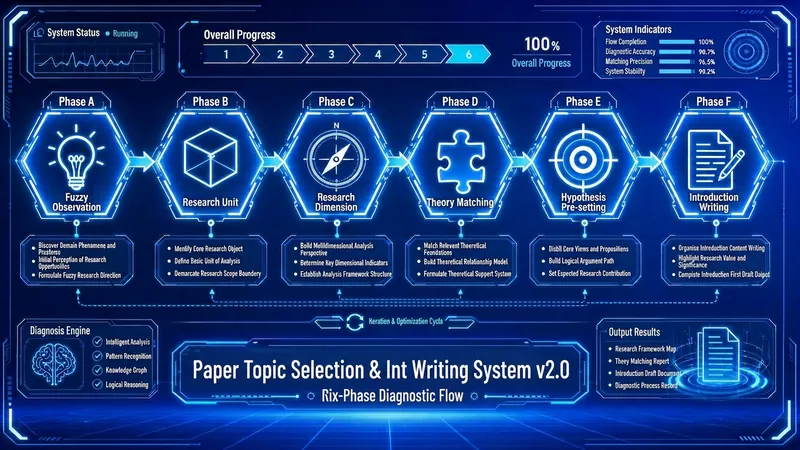
10 secondi per capire: trasforma un'osservazione vaga in un argomento solido, poi in un'introduzione approvabile. Usa solo i tuoi materiali reali, non inventa nessuna referenza. Parole chiave: selezione argomento, argomento, introduzione, gap di ricerca, scrittura accademica, proposta di tesi, selezione prima della revisione della letteratura. Si applica a: articoli di giornale / tesi di laurea / paper di conferenza / paper di corso, tutte le discipline umanistiche e scientifiche. 3 minuti per iniziare: fissa disciplina e punto di partenza → forma l'argomento a strati → porta di controllo della catena di prove → introduzione a moduli → ratchet finale. [Divisione del lavoro con altre skill] La valutazione viene prima, la scrittura dopo, la rifinitura alla fine. Questa skill si occupa della parte centrale: formazione dell'argomento + bozza dell'introduzione. Non fa l'intero corpo del testo (quello è 《学术论文全流程撰写系统 v4.x》), né la rifinitura frase per frase (quello è 《学术论文三轨润色系统 v8.x》). [Sei porte di controllo] 1. Classificazione disciplinare: 1A Arti e discipline umanistiche / 1B Scienze sociali / 2A Scienze e ingegneria / 2B Agricoltura, medicina e scienze della vita, quattro categorie, carica le corrispondenti linee guida normative; per la categoria 2B, lo stato di revisione etica è obbligatorio. 2. Posizionamento di fase: sei in osservazione vaga, hai un'unità ma manca l'angolo, hai un oggetto ma manca la teoria, manca il metodo, manca il punto di vista, o manca solo l'introduzione — parti dalla porta corrispondente, non ricominciare da capo. 3. Formazione dell'argomento: unità di ricerca → bussola dimensionale → prospettiva teorica → metodo di ricerca → punto di ricerca, blocca a strati, prima di bloccare ogni strato verifica se quello precedente è solido. 4. Porta di controllo rigida della catena di prove: prima dell'introduzione, forza la registrazione della tua letteratura come biblioteca M1/M2…, verifica di volta in volta autore/anno/titolo/identificatore; se ci sono meno di 3 voci, il sistema rifiuta di generare la dichiarazione del gap di ricerca — non è una riduzione, è un rifiuto. 5. Generazione a moduli: l'introduzione è prodotta in cinque moduli a piramide rovesciata, ogni modulo deve avere il numero di citazione [Mn], senza fonte non si può formare una frase. 6. Ratchet finale: si aggiunge solo a versioni già approvate, i moduli conformi vengono bloccati e non modificati, il punteggio sale solo. [Consegne] Documento «[Parola chiave argomento]·Argomento e introduzione» + mappa delle citazioni tracciabile frase per frase + elenco ⚠️ da verificare + un codice di archiviazione AFP. Il codice di archiviazione è comune con 开题体检器, v4.x 全流程 e 三轨润色系统, quindi non devi ripetere disciplina, argomento, giornale o biblioteca quando cambi skill. [Cosa non facciamo] Non inventiamo autori, anni, volumi, pagine, DOI; i riferimenti trovati online sono sempre contrassegnati ⚠️ da verificare, devono essere verificati da te prima di essere inseriti nella bibliografia; non promettiamo alcun risultato di accettazione o approvazione. La paternità e la responsabilità sono tue — assicurati di verificare ogni citazione e dato.
Revisione proposta PRO V2.0
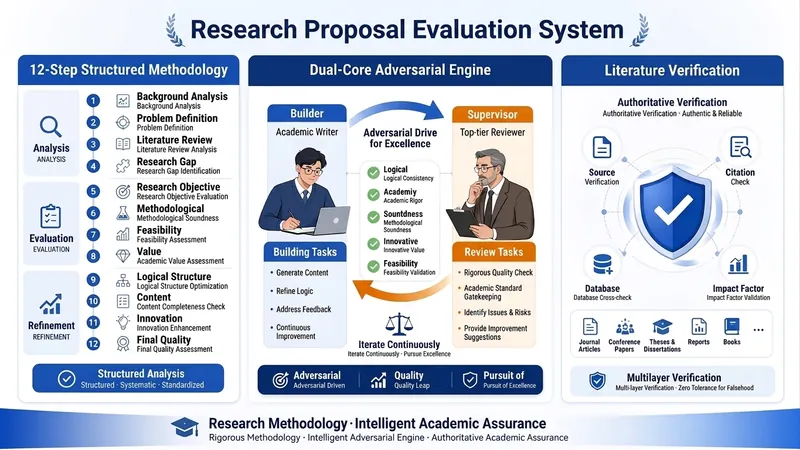
🎯 **Panoramica delle funzionalità** Questo è un sistema intelligente di revisione e ottimizzazione progettato per richieste di progetti del Fondo Nazionale per le Scienze Sociali, del Ministero dell'Istruzione e a livello provinciale. Simula il modello di pensiero di un esperto revisore con 15 anni di esperienza, garantendo il rigore accademico e la competitività della proposta attraverso tre meccanismi fondamentali. 🔧 **Tre meccanismi fondamentali** 1️⃣ **Metodologia strutturata in 12 fasi** Copre l'intero ciclo di vita della revisione della proposta: **Fase 1-3: Diagnosi di base** - Analisi approfondita del bando (orientamento dei finanziamenti, criteri di revisione, requisiti di presentazione) - Identificazione del tipo di disciplina interdisciplinare (riconoscimento preciso di 8 tipi) - Identificazione del GAP di ricerca in 5 dimensioni (teoria/metodo/empirico/politica/tecnologia) **Fase 4-7: Valutazione degli elementi chiave** - Analisi del problema di ricerca con il modello TMAQ (teoria/metodo/approccio/problema) - Verifica degli obiettivi di ricerca secondo il principio SMART - Valutazione della completezza della struttura del contenuto di ricerca - Abbinamento del tipo di approccio di ricerca (6 tipi) **Fase 8-10: Miglioramento della qualità approfondita** - Individuazione precisa dei punti critici (distinzione standard + percorso di soluzione) - Esplorazione dei punti di innovazione in 7 dimensioni - Argomentazione della fattibilità in 7 dimensioni **Fase 11-12: Ottimizzazione complessiva** - Controllo qualità su 9 dimensioni (rigore accademico, innovatività, fattibilità, ecc.) - Suggerimenti di ottimizzazione integrati e report finale 2️⃣ **Meccanismo di confronto dual-core (Builder vs Supervisor)** Principio di funzionamento: - Builder (scrittore accademico): genera un piano di ottimizzazione basato sui materiali dell'utente - Supervisor (revisore di top journal): sfida il piano del Builder con i criteri più severi - Iterazione del confronto: 3 cicli di confronto per garantire che il piano sia valido Scenari applicativi: - Durante l'esplorazione dei punti di innovazione: Builder propone punti di innovazione → Supervisor ne mette in dubbio la novità → iterazione di ottimizzazione - Durante l'argomentazione della fattibilità: Builder progetta il piano → Supervisor ne sfida la fattibilità → integrazione dell'argomentazione - Durante la citazione della letteratura: Builder cita la letteratura → Supervisor ne verifica l'autenticità → garanzia di norme accademiche 3️⃣ **Meccanismo di verifica dell'autenticità della letteratura** Due modalità operative: **Modalità A: Modalità placeholder (predefinita)** - Utilizza marcatori come [Placeholder-letteratura-001] al posto di riferimenti specifici - Output: "Elenco dei fabbisogni di letteratura", specifica i requisiti di ricerca per ogni placeholder - L'utente cerca e inserisce la letteratura reale **Modalità B: Modalità di verifica in tempo reale** - Richiama Google Scholar per verificare in tempo reale l'autenticità della letteratura - Genera un "Report di verifica della letteratura" (punteggi di autenticità/rilevanza/autorevolezza) - Garantisce che ogni citazione sia tracciabile Prevenzione delle allucinazioni AI: - Vietata la creazione fittizia di autori, riviste, DOI - Tutta la letteratura deve essere verificata o contrassegnata come placeholder - Garanzia del limite di integrità accademica 💡 **Valore principale e scenari applicativi** ✅ **Punti critici risolti** 1. Scarsa accuratezza accademica: i contenuti generati dall'AI spesso presentano letteratura falsa, lacune logiche 2. Innovatività insufficiente: difficile individuare veri punti di innovazione accademica 3. Fattibilità debole: i piani di ricerca mancano di argomentazione sistematica 4. Difficoltà interdisciplinare: i temi interdisciplinari rischiano di essere "a metà" 🎓 **Utenti target** - Docenti universitari (scienze sociali, educazione, discipline umanistiche) - Ricercatori (che presentano richieste per progetti nazionali e provinciali) - Team accademici (che necessitano di un processo di revisione sistematico) 📋 **Flusso di utilizzo tipico** 1. Input: caricare bando del progetto + bozza della proposta 2. Valutazione: il sistema esegue un'analisi strutturata in 12 fasi 3. Confronto: il meccanismo dual-core itera e ottimizza le parti chiave 4. Verifica: controllo dell'autenticità della letteratura 5. Output: report di revisione completo + suggerimenti di ottimizzazione + elenco letteratura 🔍 **Differenze rispetto alla revisione tradizionale** | Dimensione | Revisione tradizionale | Sistema di revisione esperto | |------------|------------------------|------------------------------| | Profondità di revisione | Dipende dall'esperienza personale | 12 fasi strutturate + 9 dimensioni qualità | | Rigore accademico | Difficile verifica completa | Verifica letteratura + confronto dual-core | | Individuazione innovatività | Giudizio soggettivo | Analisi sistematica in 7 dimensioni | | Argomentazione fattibilità | Guidata dall'esperienza | Argomentazione dettagliata in 7 dimensioni | | Coerenza | Variabile da persona a persona | Processo standardizzato | | Efficienza | Da giorni a settimane | Valutazione iniziale in 1-2 ore | Il vantaggio principale di questo sistema è: rendere esplicita, strutturata e replicabile la conoscenza tacita di un esperto revisore con 15 anni di esperienza, consentendo a ogni utente di ottenere un servizio di revisione di livello esperto.
Informazioni
- Versione
- v5
- Ultimo aggiornamento
- Crediti per esecuzione
- In base all’utilizzo
- Modelli
- Claude Sonnet 4.5
- Funzionalità
- Ricerca sul web