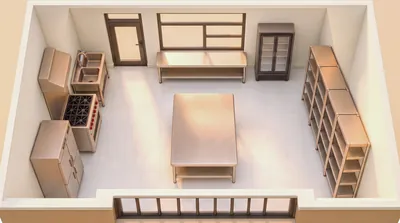
Modellazione 3D a parole
Modella in Blender tramite YM
Modellazione 3D a parole
Modella in Blender tramite YM
Anteprima
Descrizione
Tramite Blender MCP, controlla direttamente Blender per modellare e verificare lo spazio della scena, e ottimizza in modo iterativo i prompt AI per la generazione di immagini. È pensato per utenti che non conoscono software 3D: l'AI gestisce autonomamente modellazione, risoluzione dei problemi di rendering, verifica dell'illuminazione e ingegneria dei prompt. L'obiettivo finale è mantenere la coerenza della scena durante la creazione di video animati 3D — Blender costruisce la scena + controlla la telecamera + trasmette i riferimenti di inquadratura al modello di generazione video.
Abilità correlate
Vedi tutto
Prompt video AI e storyboard
Trasforma trame, schede dei personaggi o prompt video già esistenti in storyboard professionali per corti pensati per la generazione video con l’AI e in prompt per inquadrature pronti all’uso. Che si tratti di ambientazioni contemporanee, storiche, thriller, romantiche o di rivalsa, definisce in modo chiaro, in base alle relazioni tra i personaggi, al ritmo della trama e ai ganci emotivi, tipo di inquadratura, posizione della camera, punto di vista, movimenti di macchina, composizione, luci e ombre, suoni ambientali e dialoghi, così che ogni scena abbia un focus visivo chiaro e azioni realizzabili. La Skill presta particolare attenzione alla coerenza dei personaggi e alla continuità delle ambientazioni, aiutando a definire aspetto, logica degli abiti, identità, stato e dettagli distintivi, riducendo i rischi di cambiamenti del volto, deriva visiva, confusione spaziale e movimenti poco chiari durante la generazione. Anche lo sguardo, le espressioni, la respirazione e le reazioni delle mani e del corpo vengono trasformati in variazioni visibili della recitazione, per intensificare il conflitto, il senso di oppressione, i colpi di scena e la progressione emotiva del corto. Puoi partire da una trama completa oppure fornire asset dei personaggi, storyboard o prompt già esistenti da ottimizzare in modo mirato; quando l’identità del personaggio è già definita, può essere riutilizzata senza riprogettarla. Infine, l’intera sequenza di inquadrature può essere organizzata in segmenti di massimo 15 secondi, adatti alla generazione scena per scena con i principali modelli video AI, mantenendo le informazioni su immagini, suoni e durata per facilitarne la copia, l’uso e il montaggio successivo.
Prompt video H3 multimodale
Affida un video di riferimento completo a un'AI multimodale per scomporre automaticamente gli shot reali, la timeline, i cambiamenti visivi e i suoni udibili, generando prompt di livello professionale pronti per la creazione video. Non si limita a persone, pubblicità o materiali cinematografici: è adatto anche a presentazioni di prodotti, architettura e paesaggi, animali, cibo, azioni sportive, danza, animazioni 2D/3D, demo di interfacce, registrazioni dello schermo, infografiche, effetti visivi e immagini astratte. In base alla struttura informativa del video, l'assistente può produrre un prompt completo per la generazione video da testo oppure, per ogni Shot, i prompt per l'immagine di riferimento o il primo fotogramma necessari alla generazione video da immagine, la descrizione del movimento continuo, gli eventuali prompt necessari per il fotogramma finale e i vincoli di stabilità a livello di shot. Quando sono importanti sia l'immagine statica sia l'evoluzione nel tempo, può fornire entrambe le versioni. Il contenuto generato conserva le informazioni effettivamente verificabili, tra cui soggetto, composizione, movimento della fotocamera, rapporto causa-effetto delle azioni, cambiamenti strutturali, testo, dialoghi, suoni ambientali e musica, seguendo ogni shot fino al suo reale stato finale. Per testi, suoni, identità, luoghi o modalità di ripresa che non possono essere confermati con chiarezza, l'assistente evita di completarli arbitrariamente. Distingue inoltre l'immagine desiderata dagli elementi esterni, come filigrane del lettore e livelli di controllo, riducendo le variazioni indesiderate durante la generazione. È adatto a creator e team di produzione che devono ricavare prompt per video da testo, prompt per shot I2V o organizzare materiali per la ricostruzione video, la replica dello stile e la produzione di pubblicità generativa.
Regia video IA coerente
Trasforma le descrizioni in linguaggio naturale di scene video o immagini in prompt strutturati di livello registico, adatti a strumenti di generazione come Seedance 2.0 / Runway / Luma / Pika / Kling / Stable Diffusion. Questo Skill deve essere attivato quando l’utente parla di "generare un video", "prompt video", "storyboard video", "continuare una scena", "mantenere la coerenza dei personaggi", "Seedance", "Runway", "Kling", "Luma" o descrive una scena video o un’immagine che desidera generare. Va attivato anche quando l’utente dice semplicemente "aiutami a generare una scena di XX" o "un video di una scena XX".
Informazioni
- Versione
- v6
- Ultimo aggiornamento
- Crediti per esecuzione
- In base all’utilizzo
- Modelli
- Automatico
