Puzzle sottotitoli video
Crea immagini lunghe con sottotitoli
Puzzle sottotitoli video
Crea immagini lunghe con sottotitoli
Anteprima
Descrizione
Trasforma video locali o online autorizzati in immagini lunghe con i sottotitoli in formato 3:4 o nelle proporzioni originali, tramite estrazione, individuazione del testo, selezione delle frasi, cattura precisa dei fotogrammi, ritaglio compatto, unione e controllo qualità. Supporta due modalità di output distinte: la modalità sottotitoli nativi, che conserva quelli già presenti nel video, e la modalità sottotitoli script, che disegna i punti temporali e le battute verificate sui fotogrammi reali. Da usare quando si richiedono schermate di sottotitoli nativi, puzzle di fotogrammi, immagini di citazioni da YouTube, schermate di battute, nessun ridisegno dei sottotitoli, battute personalizzate o la regolazione del rapporto dell'immagine principale, dell'area dei sottotitoli, dell'intervallo delle battute e dell'estetica.
Consigliato da
Dancang
Perché consigliamo questa abilità
Questa skill si distingue perché separa nettamente i sottotitoli nativi dai sottotitoli script post-prodotti, evitando modifiche accidentali al contenuto originale e organizzando dialoghi verificati in immagini verticali ideali per la condivisione. Include inoltre la verifica dei parlanti, la selezione di fotogrammi stabili e il controllo visivo per risultati più affidabili.
Ideale per
Ideale per creatori di contenuti ed editor che devono trasformare sottotitoli o battute in immagini lunghe da condividere.
Come usare questo Skill
Fornisci i dati
Fornisci un video locale o online di cui hai l'autorizzazione, specifica la modalità con sottotitoli nativi o script, i timestamp o le battute e le preferenze per il formato.
Esegui lo Skill
Seleziona e verifica i fotogrammi del video e il testo, mantieni i sottotitoli originali o disegna le battute confermate, quindi uniscili in un'immagine controllandoli uno a uno.
Controlla il risultato
Ottieni una o più immagini lunghe con i sottotitoli del video, accompagnate da dati su timestamp o battute e da una panoramica in anteprima.
Abilità correlate
Vedi tutto
Prompt video H3 multimodale
Affida un video di riferimento completo a un'AI multimodale per scomporre automaticamente gli shot reali, la timeline, i cambiamenti visivi e i suoni udibili, generando prompt di livello professionale pronti per la creazione video. Non si limita a persone, pubblicità o materiali cinematografici: è adatto anche a presentazioni di prodotti, architettura e paesaggi, animali, cibo, azioni sportive, danza, animazioni 2D/3D, demo di interfacce, registrazioni dello schermo, infografiche, effetti visivi e immagini astratte. In base alla struttura informativa del video, l'assistente può produrre un prompt completo per la generazione video da testo oppure, per ogni Shot, i prompt per l'immagine di riferimento o il primo fotogramma necessari alla generazione video da immagine, la descrizione del movimento continuo, gli eventuali prompt necessari per il fotogramma finale e i vincoli di stabilità a livello di shot. Quando sono importanti sia l'immagine statica sia l'evoluzione nel tempo, può fornire entrambe le versioni. Il contenuto generato conserva le informazioni effettivamente verificabili, tra cui soggetto, composizione, movimento della fotocamera, rapporto causa-effetto delle azioni, cambiamenti strutturali, testo, dialoghi, suoni ambientali e musica, seguendo ogni shot fino al suo reale stato finale. Per testi, suoni, identità, luoghi o modalità di ripresa che non possono essere confermati con chiarezza, l'assistente evita di completarli arbitrariamente. Distingue inoltre l'immagine desiderata dagli elementi esterni, come filigrane del lettore e livelli di controllo, riducendo le variazioni indesiderate durante la generazione. È adatto a creator e team di produzione che devono ricavare prompt per video da testo, prompt per shot I2V o organizzare materiali per la ricostruzione video, la replica dello stile e la produzione di pubblicità generativa.
 Video
Video di favole e idiomi
Trasforma rapidamente un idioma, un aneddoto o una favola in uno storyboard narrativo continuo, pronto per la generazione di video. Che si tratti di 《守株待兔》, 《掩耳盗铃》, 《司马光砸缸》 o di un idioma inserito direttamente dall’utente, ricostruisce il contesto della storia, i rapporti tra i personaggi, le azioni chiave e la morale, organizzandoli in una trama chiara e compatta per video brevi. Per impostazione predefinita sono disponibili due versioni: 15 e 30 secondi. La versione da 15 secondi è adatta a presentare rapidamente gli elementi essenziali della trama, mentre quella da 30 secondi aggiunge l’ambientazione, le reazioni dei personaggi e le azioni culminanti, rendendo la storia più completa e ricca di tensione narrativa. Ogni inquadratura indica chiaramente emozioni, tipo di campo, movimento della camera ed eventuale narrazione, definendo inoltre caratteristiche visive stabili per i personaggi. In questo modo l’aspetto dei protagonisti rimane coerente nelle inquadrature successive ed è compatibile con i più comuni modelli di generazione video. Tutte le narrazioni sono scritte in formato da doppiaggio (voce fuori campo o battute pronunciate dai personaggi), così il modello video legge davvero le battute invece di trasformarle in testo sullo schermo. Lo stile predefinito è l’animazione cartoonesca, ma puoi specificare anche stili visivi a inchiostro, ritaglio di carta, teatro d’ombre, realistico o altri, oppure richiedere una sola delle due durate. Lo script finale è interamente in cinese e include atmosfera della scena, aspetto dei personaggi, immagini delle inquadrature e requisiti di coerenza. È adatto per realizzare animazioni di idiomi, favole, cortometraggi d’ispirazione cinese e video sulla cultura tradizionale destinati a bambini o al grande pubblico.
 Video
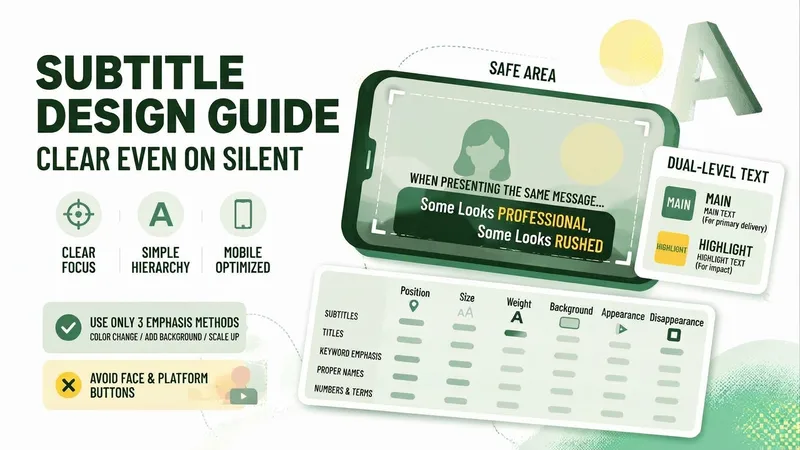
Guida layout sottotitoli
Per giudicare se i sottotitoli sono efficaci c’è un solo criterio: su uno smartphone, anche con il video ridotto alle dimensioni di un pollice e senza audio, la frase si capisce ancora a colpo d’occhio?【Guida layout sottotitoli】 parte da tre regole ferree: l’area sicura (quanto spazio lasciare sopra, sotto, a destra e a sinistra, con indicazioni diverse per formato verticale e orizzontale), il limite massimo di caratteri per riga (e il motivo: esiste un limite al numero di caratteri leggibili in un secondo) e una gerarchia di soli due livelli (testo principale e testo in evidenza; con tre livelli si crea inevitabilmente confusione). Offre poi una tabella dei parametri di impaginazione da compilare seguendo l’esempio: per sottotitoli, titoli, parole chiave in evidenza, nomi di persona e luogo, numeri e nomi propri vengono indicati posizione, dimensione relativa, peso del carattere, presenza o assenza di sfondo e momento di comparsa e scomparsa, specificando anche le aree da evitare per non coprire volti e pulsanti della piattaforma. Per evidenziare le parole chiave propone solo tre metodi (cambiare colore, aggiungere uno sfondo o ingrandire il testo) e spiega che se ne deve scegliere uno solo. Include inoltre sei soluzioni per gli errori più amatoriali e un metodo semplice per controllare il video da smartphone senza audio. Regole tassative: non scrive battute né copioni, non consiglia file di font specifici, non insegna metodi per deformare o coprire il testo allo scopo di eludere i controlli della piattaforma, non giudica l’aspetto o l’accento dell’utente e non promette un tasso di completamento della visione.
Informazioni
- Versione
- v4
- Ultimo aggiornamento
- Crediti per esecuzione
- In base all’utilizzo
- Modelli
- Automatico
- Casi d’uso
- Immagini e design
- Cosa otterrai
- ImmagineDati