「世界とは、成立している事態の総体である。」 — ルートヴィヒ・ウィトゲンシュタイン、
論理哲学論考
、1921年
世界は言葉でできているわけではない。
以前のエッセイで、私たちは空間知能が AI の次のフロンティアであり、世界モデルがその道筋であると主張しました。このエッセイでは、World Labs のチームと私がさらに深く掘り下げます。現在構築され「世界モデル」と呼ばれている多くのものの中で、実際にその能力を構成する機能的な要素は何か、そしてそれぞれの役割は何か、という問いです。
言語モデルは、概念、語彙、推論において機械に驚くべき能力を与えました。しかし、物理世界(仮想であれ現実であれ)は、異なる基盤の上で動作しています。言語モデルがテキストの統計的構造を学習するのに対し、世界モデルは空間と時間の統計的構造を学習します。つまり、光がどのように表面に落ちるか、どのカメラも捉えたことのない角度から庭がどう見えるか、物体が力にどう反応し、物理法則に従うかを学習します。
このことが、「世界モデル」という用語を、今日の AI において最も重要でありながら、最も過剰に使われている用語の一つにしています。コンピュータビジョン、ロボティクス、強化学習、生成 AI の各分野が、それぞれ世界モデルを構築していると主張し、それぞれがまったく異なるものを意味しています。見事だが物理的に不可能な炎を生成する動画モデル、プレイ可能なゲームを即興で作る言語モデル、燃焼を忠実にシミュレートする物理エンジンは、すべて同じ名前で呼ばれています。
古代ギリシャ人は、世界が何でできているか(火、水、それとも分割不可能な原子か)について決して合意できませんでした。「世界」が決して単一のものではなかったからです。それは常に、特定の思想家が推論する必要のあるあらゆる全体性の代役でした。AI は、まさにこの分野が精密さを必要としているまさにその瞬間に、同じ問題を引き継いでいます。
分類法の根底にあるループ
この混乱を断ち切るには、議論されているどのテクノロジーよりも古い図式から始める必要があります。強化学習の教科書(サットン&バートの名著を含む)は、エージェントが世界とどのように相互作用するかを説明するために、何十年もの間同じ図のバージョンを使用してきました。この図の正式な名称は、部分観測マルコフ決定過程(POMDP)であり、「世界モデル」という用語の本来の定義はこの伝統に属します。
エージェント(人間、ロボット、ソフトウェアシステムのいずれか)は行動を起こします。その行動は世界の状態に影響を与えます。エージェントは状態を直接見ることはありません。エージェントに届くのは観測です。つまり、網膜に当たる光子、センサーの読み取り値、ビデオフレームのピクセルです。新しい観測が新しい行動に情報を提供し、ループが続きます。
「状態」という言葉は、分野によって意味が変わるため、説明が必要です。これは化学者のいう状態(固体、液体、気体の違い)ではありません。これは物理学者やロボット工学者のいう状態です。つまり、ある瞬間に世界で起こっていることの完全な記述であり、すべての物体、位置、速度、特性を含みます。状態は世界の根底にある現実であり、原理的には完全ですが、内部にいるエージェントから直接見ることは決してできません。観測は、その現実に対するエージェントの部分的な見方です。行動は、それに応じてエージェントが行うことです。
このループ(エージェント→行動→状態→観測→エージェント)こそが、現代の「世界モデル」という用語に技術的な意味を与えた構造です。このフレーズ自体はさらに古く、1943 年にケネス・クレイクが、心は現実の「小規模モデル」を実行することで推論するという提案にまで遡り、1980 年代後半から 1990 年代前半にかけてニューラルネットワークに取り入れられました。そして、このループは、今日人々がこの用語で意味するものも説明します。現在、世界モデルと呼ばれているさまざまなものは、実際にはこの同じループの異なる投影です。それぞれが、ループの異なる部分を出力します。
世界モデルの 3 つの機能
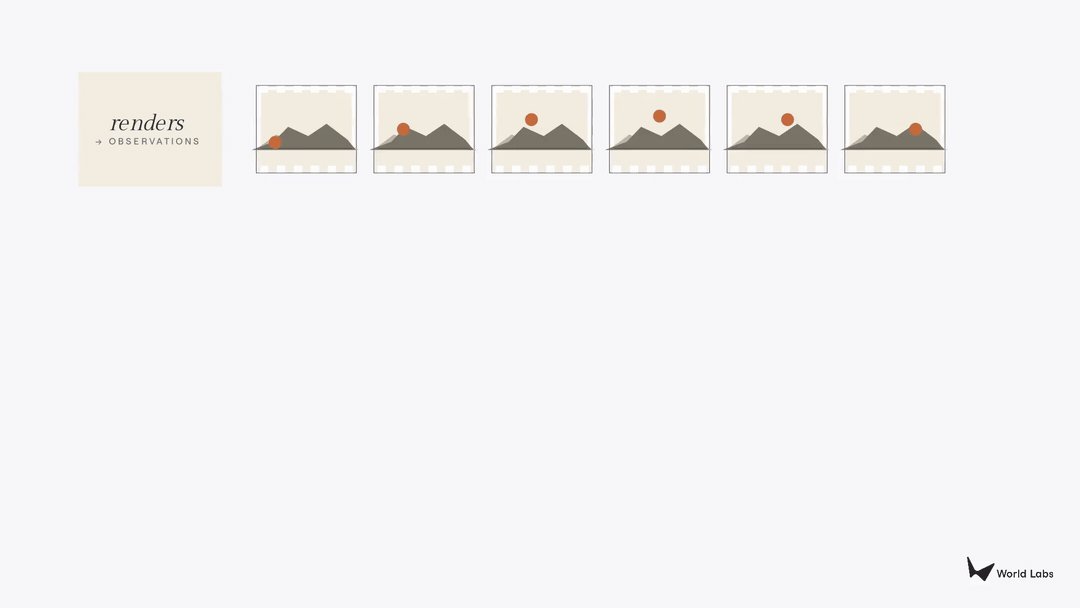
第一の種類の世界モデルは、レンダラーです。 レンダラーは、人間の目に向けたピクセルの形で観測を出力し、最も重要な品質は視覚的な忠実度です。 テキストプロンプトを映画のようなドローンショットに変換する動画モデルはレンダラーです。Google の Genie 3 や World Labs の RTFM のような、ユーザー入力に基づいてリアルタイムでフレームを生成するインタラクティブシステムも同様です。モデルは 3D 構造の明示的な理解を持ちません。見る人が目にするもの、つまり実際にあるものではなく、見えるものを生成します。ドローンショットの建物は上から見ると完璧に見えるかもしれませんが、下の街を車で通り抜けようとすると崩れてしまいます。
第二の種類は、シミュレーターです。シミュレーターは状態を出力します。つまり、人間とコンピュータプログラムの両方が計算し、対話できる、幾何学的、物理的、または動的に忠実な世界の表現です。 レンダラーの契約が純粋に視覚的であるのに対し、シミュレーターの契約は構造的であり、検査に耐える幾何学、ニュートンの法則を尊重する物理、そして物理法則に照らして世界が従う必要がある動きを要求します。シミュレーターは同時に 2 つの消費者にサービスを提供します。建築家、デザイナー、映画製作者、ゲーム開発者などの人間の専門家は、視覚的なもっともらしさを超えた正確さを必要とします。強化学習エージェント、ロボットコントローラー、自動運転車などのコンピュータプログラムは、現実では実行するには危険、高価、または不可能なシナリオをテストしながら、規模を拡大して世界と対話できる訓練場としてシミュレーターを使用します。
第三の種類は、プランナーです。プランナーは行動を出力します。 観測と目標が与えられると、プランナーはエージェントが次に何をすべきかという問いに答えます。これは、多くの点でレンダラーの逆です。レンダラーが行動を入力として受け取り観測を生成するのに対し、プランナーは観測を入力として受け取り行動を生成し、知覚-行動ループを閉じます。Vision-Language-Action モデル、モデルベースシステム、新しい波である World Action Models はすべて、プランナーの試みであり、非構造化世界でロボットが何をすべきかを決定できるシステムです。
これら 3 つのカテゴリは、現在実際に出荷されているもののほとんどを説明しており、それらの区別は実際に役立ちます。しかし、これらのカテゴリは根本的に分離しているわけではありません。世界がどのように機能するかという同じ基礎知識(幾何学、物理学、動力学)が、それらすべての根底にあります。任意の角度からカップをレンダリングできるモデルは、原理的には、カップを押したときに何が起こるかをシミュレートし、カップを拾うための手の動作を計画できるはずです。ますます、最も興味深い研究は、意図的にこれら 3 つの境界を曖昧にしています。
GIF
なぜシミュレーションが要なのか
3 つのカテゴリのうち、シミュレーターは最も注目されておらず、最も重要なものです。このエッセイは、この非対称性に対処します。
レンダラーは、断然、商業的に最も成熟しています。 画像生成やテキストから動画への変換を行う製品の多くが、消費者市場やエンタープライズ市場で急速に拡大しています。Google の Nano Banana モデルは、レンダラーレベルの画像生成を、潜在的に数億人のユーザーの手に届くようにしました。このテクノロジーは現実のものであり、市場も現実のものです。しかし、レンダラーは物理的な正確性よりも視覚的なもっともらしさを最適化しており、その限界は重要です。出力は美しいですが、建物の設計やロボットの訓練を任せることはできません。
プランナーは最も興味深く、最も初期段階にあり、 急速に進化するロボット学習の分野と密接に関連しています。この分野では、過去 2 年間に、動画では印象的に見えるロボットのデモが生み出されてきましたが、それらのデモが実際に何を示しているかについて、率直である必要があります。ほとんどすべてが、狭いオブジェクトセットと短いタスク期間を持つ、高度に制約された実験室のセットアップに限定されています。現実世界の展開が要求する複雑さ、変動性、または持続時間で検証されたものはありません。魅力的なデモリールと、キッチン、倉庫、または手術室で確実に動作するロボットとの間のギャップは、依然として大きいです。それでも、商業的な賭けは多大です。豊富な資金を得た参入企業の波が、汎用プランニングシステムの出荷を競っています。一方、最大のインフラストラクチャ企業は、プランニングをより広範なシミュレーションスタックの上位に位置づけています。計画できるロボットは作業できるロボットであり、業界全体が最初にそれを実現しようと競争しています。
シミュレーションは、この 2 つの間の架け橋です。 言語が世界の抽象化であり、ピクセルがその投影であるならば、幾何学、物理学、動力学こそが世界そのものです。シミュレーターは、そのレベルで機能しなければなりません。つまり、視覚的な外観(レンダラー向け)と行動の結果(プランナー向け)の両方を導き出すことができる構造的な基盤でなければなりません。
シミュレーションを習得したモデルは、その理解を、人間が消費するためのピクセルと、具現化されたエージェントのための行動予測の両方に投影できます。レンダリングのみ、またはプランニングのみを習得したモデルは、どちらもできません。商業的な表面積は巨大です。NVIDIA の Omniverse だけでも、同社が推定する工場、倉庫、サプライチェーン、デジタルツインにおいて 1 兆ドル以上のアドレス可能な市場をターゲットにしています。ロボット訓練、自動運転車テスト、建築ビジュアライゼーション、エンジニアリング、創薬はすべて、シミュレーションの形に依存しています。
この分野で最も難しい未解決問題もそこにあります。明示的な幾何学、材料特性、物理的注釈を持つ 3D データは、レンダラーが訓練するインターネット動画よりも桁違いに希少です。シミュレーションでの動作と現実での動作の差であるシミュレーションから現実へのギャップ(Sim-to-Real ギャップ)は依然として存在します。生成シミュレーターは、その上に新たなリスクをもたらします。AI によって生成された幾何学は、正しく見えても、自己交差や誤ったスケールを含み、無意味な物理を生み出す可能性があります。剛体、変形可能物体、流体、布地がすべて相互作用する大規模なマルチフィジックスシミュレーションは、単一ドメインのシミュレーションよりも桁違いにコストがかかります。
World Labs では、Marble がこの領域への最初の動きです。マルチモーダルプロンプト(テキスト、画像、動画、空間スケッチ)を受け取り、探索可能な 3D 環境を生成し、視覚的探索のためのガウシアンスプラッティングと、物理エンジンが操作できる衝突メッシュを出力します。しかし、Marble は、レンダリング、シミュレーション、プランニングの境界が崩れ始めるにつれて、この分野全体で書かれているはるかに長いアークの最初の章にすぎません。
境界が崩壊しつつある場所と次に来るもの
しかし、さらに多くのことが待っています。現在この分野で最も重要なパターンは、3 つのカテゴリが互いに融合し始めていることです。共通の洞察は、世界をレンダリングし、シミュレートし、その中で行動するために必要な知識は、ほぼ同じであるということです。先ほどの例を続けると、カップがテーブルの上にどのように置かれているか(その幾何学、材料特性、力への応答など)を真に理解しているモデルは、そのカップを任意の角度からレンダリングし、カップを押したときに何が起こるかをシミュレートし、手がカップを拾うための計画を立てることができるはずです。3 つのカテゴリは、単一の根底にある理解の 3 つの投影です。
例えば、さまざまなロボット工学研究所からの小規模ながらも増加している最近の研究は、少なくとも概念的に、事前学習済みの動画レンダラーを、世界と行動の共同予測のためのバックボーンとして使用できることを実証しており、レンダラーとプランナーの間に橋渡しを示唆し、1 つのモデルに何が起こるかと何をすべきかを想像させます。World Labs の Marble は、単一のモデルからガウシアンスプラッティングと衝突メッシュをすでに出力しており、レンダラーとシミュレーターの境界を溶解しています。すべてのレベルがパッシブ出力からインタラクティブシステムへと移行しており、 レンダラーは行動条件付きになり、シミュレーターはより制御可能で編集可能な世界を生成し、プランナーは単に反応するだけでなく熟考するようになっています。
論理的な終着点は、統合された世界モデル、つまり、フォトリアリスティックなビューをレンダリングし、物理的に正確な構造を生成し、行動シーケンスを計画し、ダウンストリームコンシューマーのニーズに応じて出力モダリティを切り替えることができる、1 つの基盤モデルです。 私たちはまだ、いくつかの困難な課題に直面しています。データ状況は不均一であり、レンダラーはインターネット動画に溢れている一方で、シミュレーターとプランナーは 3D アセットとロボットデモの深刻な不足に直面しています。視覚的な美しさの最適化は、ロボットや高忠実度シミュレーションが必要とする精度を犠牲にする可能性があります。これらの緊張を単一のアーキテクチャ内で調整することは、今日の世界モデル研究における決定的な未解決問題であり、World Labs が Marble を進化させ続ける中で取り組もうとしていることです。
GIF
しかし、方向性は明確です。1980 年代後半からこの分野が賭けてきた同じ賭け、つまり「十分に豊かな世界モデルがあれば、エージェントは世界を見て、構築し、その中で行動するために必要なすべてである」という賭けが、今や研究の全世代を動かしています。この「大きな賭け」に重みを与えているのは、すでに進行中の収束です。それぞれが独自に数十億ドル規模の産業を牽引し形成してきた 3 つのスレッドが、別々の研究プログラムとして始まりながら、まるで 1 つであるかのように振る舞い始めています。それらを総合すると、それらの間の境界が崩壊するにつれて、それらはより大きなもの、つまり機械知能とそれが存在する物理世界との関係、すなわち空間知能の長い弧を再形成するでしょう。
言語は機械に、その世界について語る方法を与えました。世界モデルは、機械がついにそれを理解し、想像し、推論し、対話するための方法です。


