シーン絵コンテ&プロンプト
イメージを保つショット設計
シーン絵コンテ&プロンプト
イメージを保つショット設計
コンテンツ紹介
説明
英語名: Storyboard to Prompts — Consistency-Locked Shot Prompts。ロシア語名: シーンの絵コンテをイメージ保持プロンプトに変換。 シーン、シーンのビート、または完成したショットリストを入力すると、Skillが絵コンテとプロンプトを返します。キャラクターやプロップのモデルシートを作成し、各ショットにそのまま貼り付けられる一貫した表現をまとめます。プロンプトを固定コアと可変部分に分け、ショットサイズ、カメラの動き、照明、カラーパレットの共通語彙を定義します。さらに、シーン全体で使うネガティブプロンプトを1つ作成し、キャラクターの見た目が崩れないよう再生成の記録を管理します。出力は、Seedance、Veo、Klingでそのまま使えるショットとプロンプトの表に加え、画面内の左右関係マップに基づくシーン全体のコンティニュイティチェックです。 このSkillは、各シーンについて2つの問いに答えます。プロンプトにそのまま繰り返し入れるものは何か、ショットごとに変えるものは何か。シーンを改めて演出したり、ドラマを創作したりするのではなく、すでに決まっている内容を受け取り、生成ツールで再現できる形にします。解決する主な問題は、キャラクターの見た目が崩れることです。クリップごとに顔、髪型、衣装、プロップが変わり、キャラクターの左右関係が混乱し、物が似た別のものに置き換わることで、動画が美しいだけの画像の集まりになってしまう問題を防ぎます。 このSkillは「ミザンセーヌとブロッキング」の直接的な続編です。前者が「シーンをどう配置するか」に答えるのに対し、こちらは「キャラクターとプロップが同じままのショットをどう作るか」に答えます。Seedance、Veo、Klingなどのツールで一貫性のある動画を制作するAIディレクター、クリエイター、インディーアニメーター、マーケター、エージェンシーに適しています。出力形式は、プロンプトと画面内の左右関係マップを備えたショット表で、すぐに制作へ使えます。 タグ: 絵コンテ、動画プロンプト、キャラクターの一貫性、イメージ保持、プロップとコンティニュイティ、モデルシート、ネガティブプロンプト、Seedance、Veo、Kling。英語名: Storyboard to Prompts — Consistency-Locked Shot Prompts。
こんな方におすすめ
一貫性のある動画シーンを作るAIディレクター、アニメーション制作者、マーケティングチーム、エージェンシー向け。
この Skill の使い方
入力を用意する
シーン、シーンのビート、または完成したショットリストに加え、キャラクター、プロップ、ロケーション、照明、フォーマットの情報を入力してください。
Skill を実行する
承認済みの素材をショットごとの絵コンテに変換し、固定する人物・物の要素と、ショットごとに変わるパラメーターを分けます。
結果を確認する
キャラクターやプロップの外見、画面内の左右関係を保つための、プロンプト付きショット表とコンティニュイティマップが得られます。
関連スキル
すべて表示シーンの対話とサブテキスト
English: Dialogue & Subtext — Scene to Dialogue Score. 日本語タイトル:シーンの対話とサブテキスト — セリフから対話の音響スコアへ。 セリフのあるシーンを入力すると、Skillはショットごとに使える対話の音響スコアを作成します。登場人物が文字どおり何を言い、本当は何を意図しているのかを分析し、言葉にされていないものを拾い上げます。各セリフについて、言葉で伝える部分、動作に置き換える部分、間に委ねる部分を判断し、言葉より沈黙が強くなる箇所を見つけます。セリフをショットごとに割り振り、画面外のセリフや無言の返答も含めます。声を生成するのではなく、画面内の行動を通して抑揚を設計します。また、物音や生活音がセリフの代わりになる箇所や、音楽が不要な場所とその理由も示します。出力はショットごとの表で、セリフ、間、沈黙、生活音、聞こえるもの、響かせないものを整理します。 Skillは各シーンについて、「登場人物は本当は何を言っているのか」「言葉だけでなく意味を伝えるために、どうショットへ分解するか」という2つの問いに答えます。セリフのあるシーン、または最初の2つのSkillで作成したshot listを受け取り、音のドラマトゥルギーを扱います。基本原則は、音声による読み上げそのものは手法ではないということです。このSkillが提供するのは、何を黙らせ、何を響かせ、どこに間と沈黙を置くかという演出的な判断であり、音声生成のボタンではありません。 シリーズの3番目のSkillとして、「シーンのミザンセーヌとブロッキング」および「画の一貫性を保つシーンの絵コンテからプロンプトへ」を引き継ぎます。1つ目はシーンを設計し、2つ目はショット間の画を維持し、3つ目は登場人物が本当は何を言い、何が言葉にならずに残るのかを分析します。1つ目のSkillの音響レイヤーとは重複しません。そこでは技術的な「何が聞こえるか」を扱い、ここでは対話の意味とサブテキスト、つまり「それが何を意味するか」を扱います。ショット数と順序はshot listから引き継ぎ、変更しません。 Seedance、Veo、Klingを使うAIディレクターやクリエイター、インディーアニメーター、脚本家、マーケターに適しています。出力形式は、すぐに制作へ使えるショットごとの対話スコアです。 タグ:対話とサブテキスト、音響スコア、間と沈黙、画面外のセリフ、無言の返答、物音、行動による抑揚。英語タイトル:Dialogue & Subtext — Scene to Dialogue Score。
ミザンセーヌとブロッキング
Mise-en-Scène & Blocking — Scene to Shot List(英語名)。 シーンを入力すると、Skillが演出プランと生成プロンプトへの変換を返します。シーンをアクションのビートに分解し、登場人物を空間に配置し、画面内で誰が何を望んでいるのかを明確にします。登場人物同士の関係の変化からブロッキングの動きを導き、場面の意味に合う画角とアングルを選び、視線のラインと180度軸を確認します。さらに、カメラを動かす必要があるか、動かすならその理由は何かを判断し、光と時間帯を意味を担う要素として読み取り、シーンの音響レイヤーを設計します。最終的には、音声欄とお使いの生成モデル向けの完成済みプロンプトを含む、ショット単位のショットリストを作成します。 このSkillは、各シーンについて「現場で何を配置・演出するか」と「生成モデルにそれを再現させるため、プロンプトに何を書くか」という2つの問いに答えます。「どんなショットがあるか」を説明するのではなく、具体的なシーンに対応します。別のブロックでは、AI動画の大きな課題であるキャラクターの一貫性とクリップのような不自然さに対応します。リファレンス画像の固定、表現の統一、ショットの順序、seed、避けるべき要素のリストを扱います。 Seedance、Veo、Klingなどのツールで動画を制作するAIディレクターやクリエイター、インディーアニメーター、マーケター、エージェンシーに適しています。出力形式は、すぐに使えるショット表とプロンプトリストです。 タグ:ミザンセーヌ、ブロッキング、ショットリストと絵コンテ、AI動画、シーン演出、視線のラインと軸、動画生成プロンプト、映画的なショット。英語名:Mise-en-Scène & Blocking — Scene to Shot List。
 画像
キャラクターシート
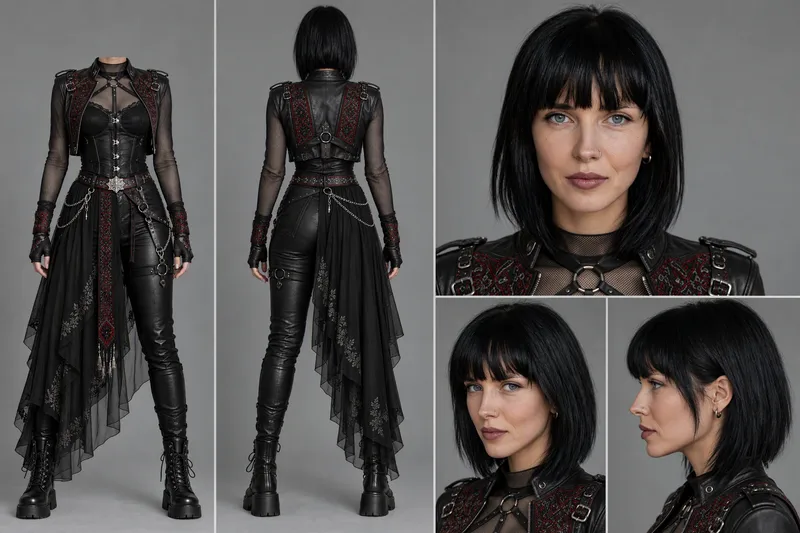
キャラクターの顔写真をベースに、プロ仕様のキャラクターリファレンスシートを作成します。まずシートの用途を確認します(動画用は正面・背面なしの全身、背面、アップの3カット、画像や写真用は全身2カットと正面・3/4・横顔のポートレート3カット)。次に1〜3枚の顔写真の添付を求め、服装の変更が必要か(写真のまま維持、服装リファレンスで変更、言葉で説明)を確認した上で、必要に応じて服装のリファレンスを求めます。その後、厳格なテンプレートに基づいてプロンプトを組み立て、GPT Image 2.5を使用してニュートラルなグレーの背景上でシートを生成し、元のキャラクターの外見、スタイル、プロパティ、素材感を維持します。
情報
- バージョン
- v2
- 最終更新
- 実行クレジット
- 使用量に応じて消費
- モデル
- 自動選択
- 活用シーン
- 文章・コンテンツ制作動画・音声
- 得られるもの
- 文書プロンプト
