チャウ・シンチー風街角喜劇
実写コメディ向け中英画像プロンプトを生成
チャウ・シンチー風街角喜劇
実写コメディ向け中英画像プロンプトを生成
コンテンツ紹介
説明
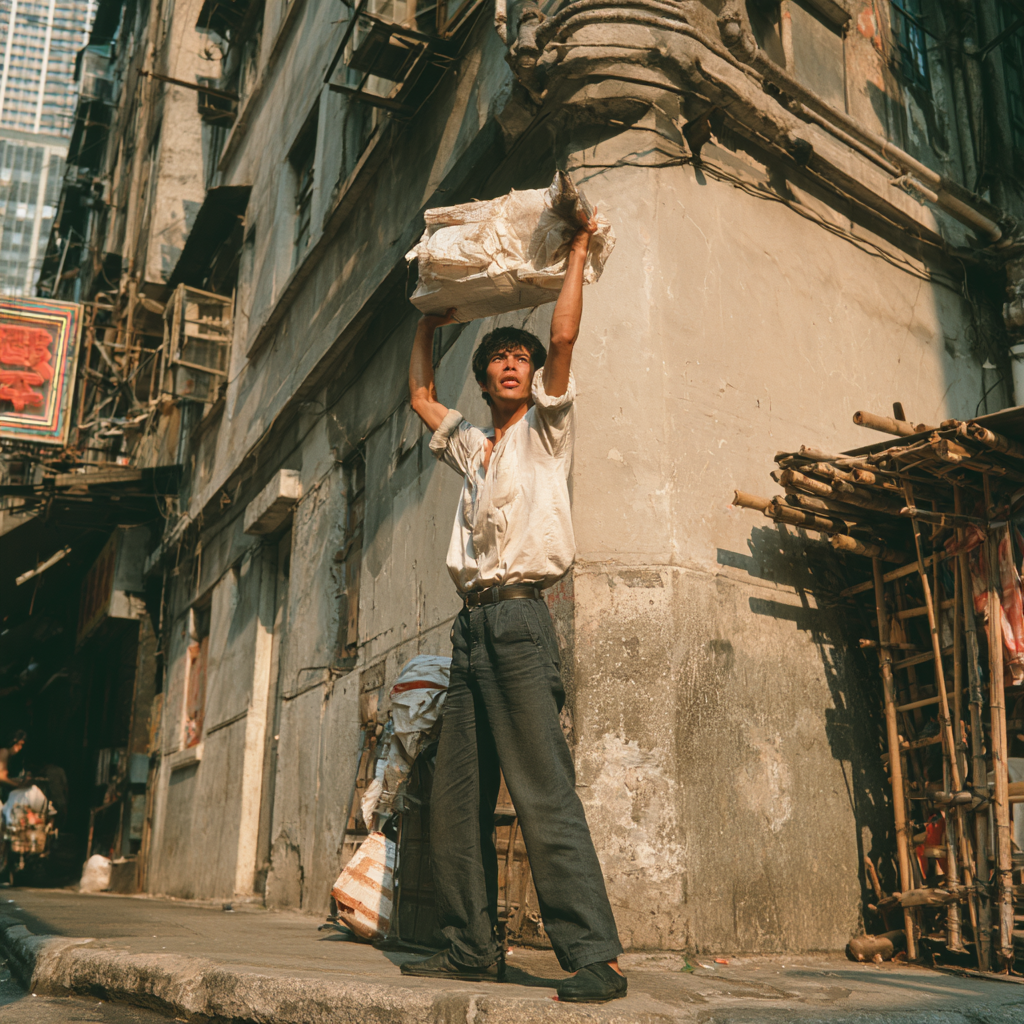
画面の構想や、役割分担が明確な参考画像を、中文ImageGenと英文Midjourneyで使える実写マンガ風コメディの静止画プロンプトに変換します。明るくリアルな街角の空間に焦点を当て、中景からワイド、または全身構図で、人物の動作、足元、道具との関係、集団の反応を分かりやすく表現します。日常的な場面とのギャップや、誇張されていても説得力のある身体表現に適しており、二次元マンガ、俳優の物まね、奇怪な人体変形を目指すものではありません。 主体、人数、動作、参考キャラクター、画面比率の要件に応じて、一般的な建物、古い壁、木製の道具、控えめながら生き生きとした生活感のある色彩を保ちます。さらに、姿勢の反復、集団同士の間隔、わずかな遠近感の変化によって、コメディのリズムを強めます。抱える、寄りかかる、取り囲んで見物するといった動作では、力のかかり方や物体の構造をできるだけ明確にし、人物のコラージュ化、道具のめり込み、不自然な遠近感を避けます。 1枚のコンセプト画像、連続した場面、参考画像からのキャラクターや構図の移行など、いずれの場合も各プラットフォームにそのままコピーして使える対応プロンプトを作成できます。対象プラットフォームを指定するだけで、適切なバージョンを出力します。
おすすめした人
淡苍
このスキルをおすすめする理由
市井の空間を、重心・接触・集団配置・道具の遠近まで整えた、信頼感のある誇張表現へ変換します。
こんな方におすすめ
街角の実写コメディの構想を、画像生成プロンプトに整理したいクリエイターに最適です。
この Skill の使い方
入力を用意する
画面の構想、または役割分担が明確な参考画像を提示し、対象プラットフォーム、人数、動作、画面比率を指定してください。
Skill を実行する
主体、動作、空間の関係、参考構図をもとに、明るくリアルで見やすい街角コメディの画像プロンプトに整理します。
結果を確認する
各プラットフォームにそのままコピーして使える静止画用画像プロンプトが得られます。
関連スキル
すべて表示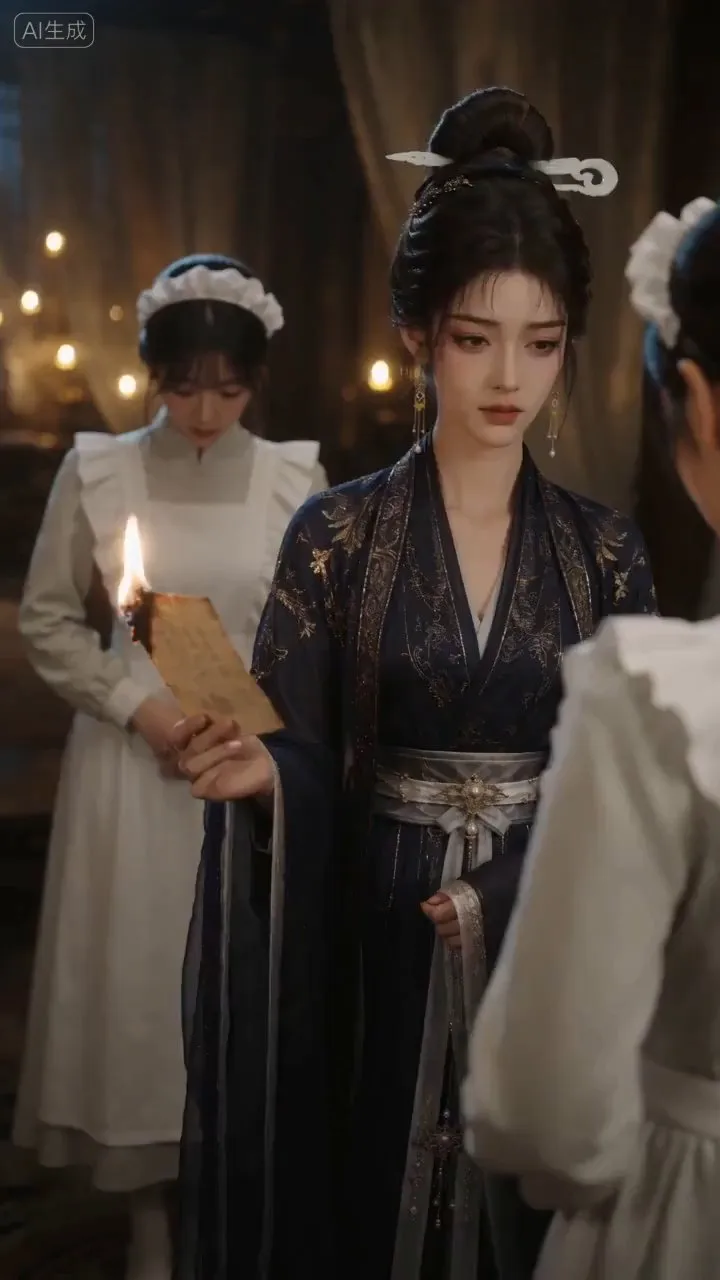
AI動画・絵コンテプロンプト生成
あらすじ、キャラクター設定、既存の動画プロンプトを、AI動画生成に適した本格的な短編ドラマの絵コンテと、そのまま使えるショット用プロンプトに変換します。現代劇、時代劇、ミステリー、恋愛、爽快系のシーンなど、人物関係、物語のテンポ、感情のフックを軸に、ショットサイズ、カメラ位置、視点、カメラワーク、構図、光と影、環境音、セリフを明確化。各ショットに、視覚的な焦点と実行可能なアクションを持たせます。 キャラクターの一貫性とシーンの連続性にも重点を置き、人物の外見、衣装の整合性、身分や状態、特徴的なディテールを固定することで、顔の変化、外見のぶれ、空間の混乱、曖昧な動作などの生成リスクを抑えます。キャラクターの視線、表情、呼吸、手元、身体の反応も目に見える演技の変化として落とし込み、短編ドラマの対立、緊迫感、どんでん返し、感情の高まりを強化します。 完成したあらすじから始めることも、既存のキャラクター素材、絵コンテ、プロンプトを指定して最適化することもできます。設定済みのキャラクターがある場合はそのまま活用し、重複した設計を避けられます。最後に、完成したショットを主要なAI動画モデルで1本ずつ生成しやすい15秒以内のクリップに整理し、映像、音声、長さの情報も保持。コピーして使いやすく、後編集にも役立ちます。
 画像
ストリート直射フラッシュプロンプト
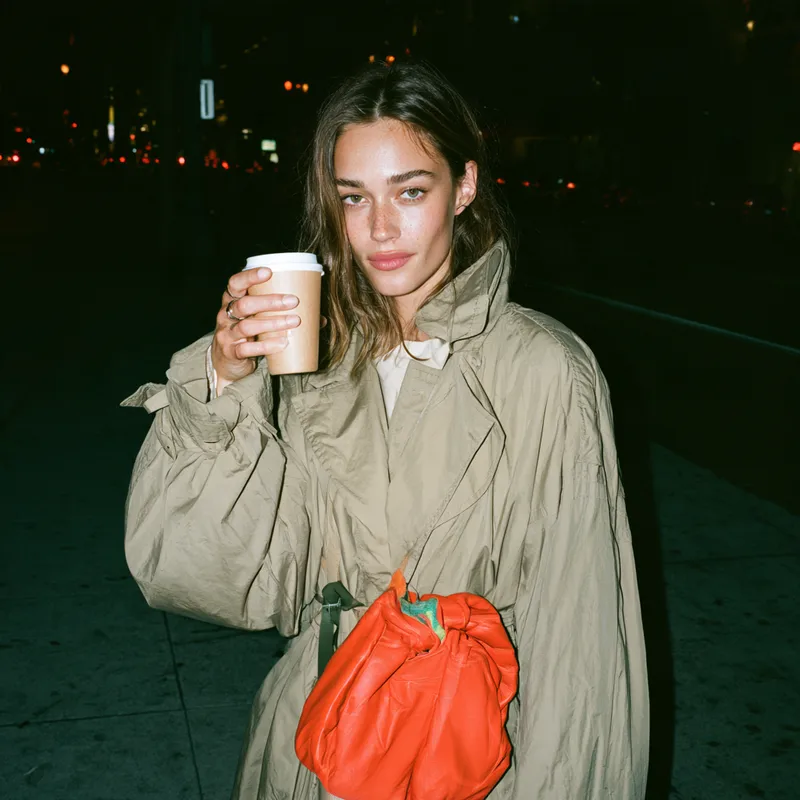
ストリートファッション、バッグ、シューズなどのアクセサリー向けに、近距離で直射フラッシュを焚いたような臨場感のある画像プロンプトを生成します。商品をくっきり目立たせながら、リアルな街角での自然なポーズと、瞬間を切り取ったような雰囲気を残します。ブランドビジュアル、SNSコンテンツ、ファッション・アクセサリーのコンセプト画像を初期生成するのに適しており、整いすぎた硬いスタジオ撮影や、過度に作り込まれた広告ビジュアルには仕上げません。 単体の商品、人物のコーディネート、具体的な使用シーンを入力し、色、素材、数量、持ち方、画角の要望を指定できます。近距離の正面フラッシュ、短く硬い影、やや暗くても判別できる環境露出、ナチュラルグレー・白・ダークネイビーなどのストリート背景を軸に構成し、手持ち、斜め掛け、テーブルに置くといった関係性に応じて構図を調整します。バッグ本体、持ち手、靴底、衣服のディテールも見えやすくなります。 デフォルトでは、個別の16:9構図案と、Midjourneyおよび中国語版ImageGenですぐ使えるプロンプトを出力します。どちらか一方の形式だけが必要な場合も、指定に応じて生成できます。複数枚のシリーズでは、商品の特徴とビジュアルスタイルを統一したまま、シーンやポーズを変えることもでき、まとまりのあるストリートファッション画像シリーズの制作に適しています。
 画像
アジア美女ポートレート指示役
このスキルは、AI画像生成プラットフォーム向けに高品質な人物ポートレートのプロンプトを作成したい方のために設計されています。アジアの美意識を取り入れた、成熟した自然な女性像を求めるクリエイターやデザイナーに特に適しています。アイデアを具体的で実行可能なプロンプトへ変換し、生成画像の美しさとプラットフォームへの対応性を高めます。 主な機能は、説明内容に基づき、Midjourney、SDXL、Flux、GPT Image、豆包、即梦、ComfyUIなど、さまざまな主要AI画像モデルに対応したプロンプトを生成することです。高リスクな語句を自動的に識別して書き換え、幼く見える表現、低俗な表現、身体の一部を過度に強調する表現を避けながら、プロンプトが各プラットフォームの安全基準に沿うようにします。また、ショートカット指示で、リアルな自撮り、商業誌のグラビア、高級Cosplay、サイバーパンク、中国風の古典スタイルなど、さまざまな画像スタイルをすばやく切り替えられます。生成に失敗した場合は、そのフィードバックに基づくプロンプト修正にも対応します。 ファッション誌の表紙、映画のようなポートレート、3D CGキャラクターデザインなど、目的にかかわらず、正確な言語表現とパラメーターの提案を提供します。最終的なプロンプトは選択したプラットフォームに合わせて最適化されます。たとえば、Midjourneyには自然で流れるような英語の長文、SDXL/Fluxには明確なポジティブ・ネガティブキーワード群、ComfyUIには詳細なモジュール式パラメータ欄を用意し、期待どおりのAI人物作品を効率よく生成できるよう支援します。
情報
- バージョン
- v2
- 最終更新
- 実行クレジット
- 使用量に応じて消費
- モデル
- 自動選択
- 活用シーン
- 画像・デザイン
- 得られるもの
- プロンプト