Cerebras Wafer Scale Engine 와 GPU 를 함께 배포하여 대규모 환경에서도 초고속 토큰을 제공합니다
세상은 초고속 토큰에 목말라 있습니다. 2026 년, Cerebras 는 자사 추론 클라우드와 파트너 채널 모두에서 빠른 추론에 대한 폭발적인 수요를 확인했습니다. 이러한 수요에 대응하기 위해 우리는 분리형 추론(disaggregated inference) 개발에 착수했습니다. GPU 가 프롬프트 처리(prefill)를 담당하고, Cerebras 시스템이 출력 생성(decode)을 담당하는 방식입니다.
이 솔루션은 현재 상용화되어, Cerebras 특유의 초고속 속도를 그대로 유지하면서 메가와트당 5 배 더 많은 토큰을 제공합니다.
이제 Cerebras Inference Cloud 를 통해 시장의 수요를 충족할 수 있는 훨씬 더 많은 초고속 토큰을 제공할 수 있게 되었습니다. 인프라 파트너 역시 Cerebras 의 분리형 솔루션을 활용해 자체 데이터센터에서 더 많은 초고속 토큰을 확보할 수 있습니다.
최근 발표한 CS-4, 대폭 확대된 생산 역량, 그리고 계획 중인 700MW 규모의 데이터센터 용량과 맞물려, 분리형 추론은 2027 년 이후 Cerebras 와 파트너들이 훨씬 더 많은 초고속 토큰을 제공할 수 있는 기반이 될 것입니다. 이 블로그에서는 다음 내용을 다룹니다.
- 초고속 추론 용량 확충의 필요성
- 디코딩(decode) 영역에서 Cerebras 가 갖는 강점
- Cerebras 분리형 추론의 상용 환경 성과
- 인프라 파트너를 위한 Cerebras 분리형 추론
빠른 추론 용량이 더 필요한 이유
Muse, Copilot, Codex 같은 에이전틱 애플리케이션은 빠르게 확장되고 있으며, 사용자의 몰입을 유지하려면 고도의 상호작용성을 갖춘 추론이 필요합니다. 전력 공급이 제한된 환경에서 이러한 애플리케이션의 증가하는 수요를 충족하려면, 우리 업계는 메가와트당 훨씬 더 많은 추론 용량을 제공하면서도 애플리케이션을 실질적으로 유용하게 만들어 줄 응답 속도를 달성해야 합니다.

출처: Goldman Sachs Research, “AI Agents Forecast to Boost Tech Cash Flow as Usage Soars(사용량 급증에 따라 AI 에이전트가 기술 기업 현금흐름을 개선할 전망)”, 2026 년 5 월 20 일; Investing.com 에 보도된 Goldman Sachs 데이터센터 용량 추정치
이것이 바로 Cerebras 가 분리형 아키텍처에 투자한 이유입니다. 프롬프트 처리용 prefill 가속기와 응답 생성용 Cerebras 시스템을 결합하면, Cerebras 의 초고속 생성 속도를 그대로 유지하면서도 메가와트당 토큰 처리량을 높일 수 있습니다. 추론 서비스 제공업체 입장에서는 동일한 전력 예산으로 고객에게 제공할 수 있는 용량이 늘어나고 매출 잠재력도 커진다는 것을 의미합니다.
디코딩에서 Cerebras 가 유리한 이유
추론 요청은 크게 두 단계로 나뉩니다. prefill 이라고 불리는 프롬프트 처리 단계에서는 입력을 처리해 중간 모델 상태를 생성합니다. decode 라고 불리는 응답 생성 단계에서는 그 상태를 활용해 출력 토큰을 생성합니다. draft–target, attention–FFN 등 추론 워크로드를 분할하는 방법은 다양하지만, 고도로 상호작용적인 추론을 목표로 할 때는 prefill 과 decode 를 분리하는 것이 독보적으로 유리합니다.

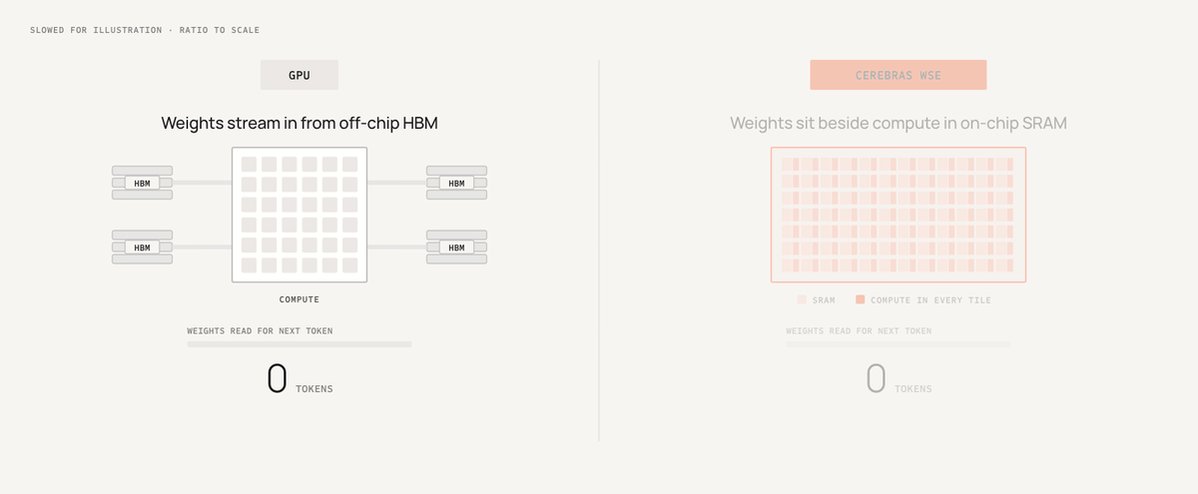
Decode 는 자기회귀(autoregressive) 방식으로 동작합니다. 즉, 모델이 한 번에 하나의 토큰을 생성하며, 생성된 각 토큰을 다음 토큰 생성을 위한 입력으로 사용합니다. 매 단계마다 메모리에서 모델 데이터를 다시 읽어야 하므로 메모리 대역폭이 매우 중요합니다. 초고속 추론 영역에서는 SRAM 중심 칩이 유리합니다. 데이터를 칩 내부에 유지하면서 훨씬 빠르게 읽어올 수 있기 때문입니다. Cerebras 는 이를 웨이퍼 스케일로 구현했습니다. 단일 칩에 수십 기가바이트의 SRAM 과 초당 수십 페타바이트의 메모리 대역폭을 탑재해, 일반적인 GB300 GPU 대비 350 배의 SRAM 용량과 5,400 배의 메모리 대역폭을 제공합니다. 덕분에 Cerebras 시스템은 더 많은 동시 요청과 모델 레이어를 칩 위에 직접 적재할 수 있으며, CS-3, CS-4, CS-5 는 매력적인 처리량 수준에서 초고속 성능을 달성할 수 있습니다.
GIF
Cerebras 분리형 추론의 상용 환경 성과
초고속 디코딩에 최적화된 Cerebras 시스템과 AMD Instinct GPU 처럼 prefill 의 연산 요구사항에 적합한 가속기를 결합하면, 대규모 환경에서도 막대한 양의 초고속 추론을 제공할 수 있습니다. Cerebras Inference Cloud 의 실제 운영 환경에서는 AMD Instinct GPU 가 프롬프트를 처리하고 Cerebras CS-3 시스템이 응답을 생성합니다. 프롬프트 처리를 GPU 로 넘김으로써 Cerebras 시스템은 서비스 용량 전체를 응답 생성에 집중할 수 있습니다. 우리가 측정한 운영 환경에서 이 조합은 CS-3 단독 구성 대비 메가와트당 5 배의 처리량을 기록했으며, 토큰 생성 속도 저하도 전혀 없었습니다.

출처: Cerebras Inference Cloud 를 통해 제공되는 11 월 14 일자 공유 GPT-OSS-120B 엔드포인트 기준, 분리형 추론 적용 전후의 메가와트당 처리량 (통합 추론 베이스라인(1×) 기준 정규화).
우리는 2027 년 말까지 Cerebras Inference Cloud 및 파트너 배포 환경에서 수백 메가와트 규모로 분리형 추론을 폭넓게 도입할 계획입니다. 목표는 고객이 활용할 수 있는 초고속 추론 용량을 확대하는 것입니다.
인프라 파트너를 위한 Cerebras 분리형 추론
Cerebras 분리형 추론 솔루션은 파트너사가 쉽게 도입할 수 있도록 설계되었습니다. 인프라 파트너는 Cerebras 가 제공하는 레퍼런스 아키텍처를 기반으로 분리형 추론 클러스터를 구축하고, 선택한 prefill 가속기와 Cerebras 시스템을 단일 네트워크 안에 통합 배치할 수 있습니다. 소프트웨어 연동의 경우, 파트너는 Cerebras 의 엔드투엔드 분리형 소프트웨어 스택 또는 디코드 전용 SDK 중 하나를 선택해 연동할 수 있습니다.
- 엔드투엔드 분리형 소프트웨어 스택은 출시 기간 단축을 최우선으로 하는 파트너에게 가장 적합합니다. 구성 요소는 다음과 같습니다.
- prefill 풀과 decode 풀 간에 요청을 라우팅하고 복제본 용량 및 상태를 관리하는 분리형 추론 프레임워크
- vLLM, SGLang 같은 오픈소스 추론 엔진을 사용해 프롬프트를 처리하는 prefill 엔진
- Cerebras 시스템에서 응답 생성을 담당하는 Cerebras decode 엔진
- RDMA 를 통해 키-값 캐시를 포함한 중간 모델 상태를 prefill 엔진과 decode 엔진 간에 전송하는 인터페이스인 KV Portal 소프트웨어
디코드 전용 SDK 는 제어 권한을 극대화하려는 파트너에게 가장 적합합니다. 디코드 전용 SDK 를 사용하면 파트너가 자체 추론 프레임워크와 prefill 엔진을 Cerebras decode 엔진 및 KV Portal 소프트웨어와 연결할 수 있습니다. 또한 디코드 전용 SDK 는 모의(mock) Cerebras decode 복제본, 오픈소스 분리형 추론 프레임워크 및 prefill 엔진과의 레퍼런스 연동 예시 등 개발 지원 도구도 제공합니다.

Amazon Web Services, Fireworks AI, Gimlet Labs, General Compute 를 비롯한 얼리 액세스 파트너들은 이미 자체 배포 환경에서 Cerebras 분리형 솔루션을 활용하고 있습니다. 이제 우리는 고객에게 대규모 초고속 추론을 제공하고자 하는 추가 파트너들로 접근 범위를 넓혀가고 있습니다.
성과, 솔루션 또는 배포 기회에 대해 더 자세히 논의하고 싶으시다면 여기로 문의해 주세요.


