Transcrição de Entrevista
Tempo de áudio, locutores e TXT, JSON, SRT
Transcrição de Entrevista
Tempo de áudio, locutores e TXT, JSON, SRT
Prévia
Descrição
Ideal para quem precisa organizar gravações autorizadas de entrevistas, reuniões ou aulas. Forneça o arquivo original, idioma, finalidade, transcrição existente ou mapeamento confiável de locutores por tempo; a identidade não pode ser confirmada apenas pela voz e os roteiros não substituem o que foi efetivamente ouvido. Preserva o áudio original e o hash, lê a duração e a faixa, executa o ASR real, organiza na linha do tempo correta, rotula locutores anônimos quando houver base, confere números, negações, nomes e dúvidas ouvindo o áudio original, e entrega TXT, JSON, SRT e notas de abrangência. A primeira versão da máquina, a revisão de escuta e o resumo são separados; o que não estiver claro é mantido pendente, sem preenchimento automático para fluidez. Sem ferramentas de áudio ou ASR, a transcrição é explicitamente omitida. O comando e o pacote incluem um assistente local original completo: Python3, FFmpeg/FFprobe, faster-whisper e o cache small pré-configurado, CPU/int8, local_files_only, sem download automático de pesos. O speaker-map confiável realiza a transcrição real por janela e mapeia o tempo; sem mapeamento, o carimbo é desconhecido. O assistente não realiza separação automática de timbre nem identificação de identidade, e o pacote não inclui pesos, contas ou chaves. Os quatro exemplos consistem em monólogo pessoal em chinês criado para este fim, entrevista dupla em chinês, apresentação de curso em inglês e reunião dupla em chinês, totalizando cerca de 40,875 segundos de áudio. O áudio original final utiliza versão fixa local de Kokoro-82M rotulada no modelo Apache-2.0, zf_xiaobei, zm_yunjian, af_heart, sem vozes reais ou clonagem; modelos, vozes ou áudios de exemplo não são distribuídos com o instalador. Os quatro exemplos de ASR real geram TXT/JSON/SRT, e os locutores vêm do tempo de fala sintético fornecido, e não de separação automática de locutores. Ainda é uma versão preliminar da máquina; a divergência entre o ASR da segunda vez e a primeira versão do roteiro aguarda conferência auditiva, sem alteração arbitrária para o que foi dito. A forma de onda vem dos picos PCM de entrada reais, não sendo apenas decorativa. Para a organização de texto, recomenda-se o GPT, e o ASR depende das ferramentas reais; nenhuma API de transcrição da OpenAI foi chamada localmente nem CLI upstream executada. O avatar independente é o visual de conceito ImageGen, a ferramenta não retornou modelo e Image2 não é reivindicado. Ferramentas, cache, downloads de arquivos e vinculação de modelos na YouMind não consomem pontos de teste; é preciso confirmar conforme o ambiente real. A transcrição e a organização de locutores não garantem execução sem dependências após a instalação. Os 299 pontos equivalem ao preço de instalação, sem incluir modelos, APIs ou serviços de terceiros, sem compra automática e sem upload oculto de faixas de áudio desconhecidas para serviços externos. Não há promessa de zero erros, reconhecimento perfeito de sotaques, ruídos ou múltiplos locutores sobrepostos, perícia judicial ou de identidade, eficiência de tempo ou resultado comercial. A revisão de áudio independente requer complementação, sem propaganda de verificação de transcrição exata.
Recomendado por
Dancang
Por que recomendamos esta habilidade
Destaque por não mascarar a transcrição automática como versão final: preserva evidências e horários, separa fontes de locutores e sinaliza trechos incertos, entregando TXT, JSON e SRT rastreáveis.
Ideal para
Ideal para quem precisa organizar gravações de entrevistas, reuniões, aulas ou relatos, preservando a base da transcrição e marcações de incerteza.
Como usar este Skill
Forneça os dados
Forneça o áudio ou vídeo de entrevista, reunião, aula ou relato autorizado, o idioma, a finalidade e o escopo de processamento, além de um mapeamento de locutores.
Execute o Skill
Transcreve o áudio e organiza os carimbos de tempo reais, rotula locutores anônimos com base no mapeamento e sinaliza trechos inaudíveis, sobrepostos ou não verificados.
Confira o resultado
Receba arquivos de transcrição TXT, JSON e SRT com carimbos de tempo e notas de origem, acompanhados de notas de escopo, itens não verificados e orientações.
Habilidades relacionadas
Ver tudo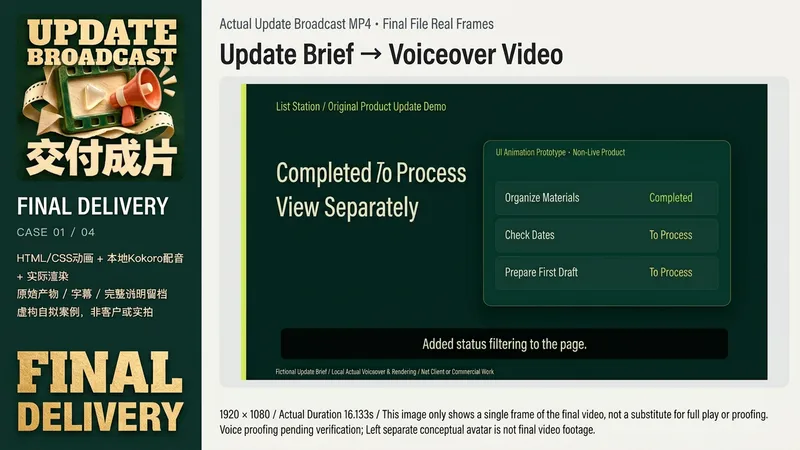 Vídeo
Boletim de Atualização
Adequado para criadores, pequenas equipes e educadores que precisam explicar mudanças em produtos. Fornece uma lista real de atualizações, status concluído/planejado, capturas de tela ou protótipos autorizados, público-alvo, proporção de tela e áudio original; datas, efeitos e dados de clientes ausentes não serão inventados. Quando houver apenas uma ideia, será feita uma demonstração de produto fictício claramente sinalizada. Inserir boletim → Verificar fatos e permissões → Roteiro conciso e cenas → Dublagem real/receber áudio original → Organizar legendas e imagens de acordo com o áudio real → Renderização real → Reprodução, revisão visual e auditiva → Entrega de MP4, SRT, roteiro e projetos de origem gerados. Interfaces reais apenas organizam originais, sem reprocessamento por IA de imagem. Se não houver ferramentas de renderização, será explicitado que o vídeo não foi concluído. Os quatro exemplos locais são produtos fictícios originais: filtragem de lista, visualização de calendário, verificação antes da exportação e progresso do curso. Versão fixa real do Kokoro-82M, síntese local da voz zf_xiaobei, HyperFrames 0.8.174 e Chrome/FFmpeg gerando na prática dois vídeos de 1920×1080, um de 1080×1080 e um de 1080×1920, com cerca de 16,1 a 18,5 segundos; legendas organizadas de acordo com a duração real da amostra de áudio por frase, sem reivindicar alinhamento estrito palavra por palavra. Estes não são softwares, clientes ou resultados de aprendizado realmente publicados. O planejamento de texto recomenda GPT. O núcleo requer arquivos reais, renderização de animação/vídeo, FFmpeg/FFprobe e áudio original legítimo ou TTS utilizável. As instruções incluem um assistente de renderização local original completo, que apenas verifica/renderiza projetos HyperFrames existentes, sem gerar automaticamente interface ou dublagem; requer configuração própria de Node, HyperFrames CLI e caminhos do navegador. Ferramentas de imagem servem apenas como suporte original opcional; avatares independentes são gerados pelo ImageGen, com modelo não retornado, não sendo quadros de exemplo. A plataforma GPT-6.1 Sol é apenas uma configuração opcional, sem garantia de ser igual às ferramentas ou modelos locais. Testado sem consumo de pontos no YouMind, sem garantia de acesso direto a essas ferramentas após a instalação. Os 299 pontos cobrem apenas o preço de instalação e não incluem modelos, TTS, fontes, materiais, serviços de terceiros ou hospedagem. Não clona vozes automaticamente, não compra serviços nem publica em outros canais; não garante entrada arbitrária, zero erros, disseminação, moderação ou resultados comerciais. Os exemplos locais atuais foram renderizados e reproduzidos na realidade, e a revisão auditiva independente da trilha sonora ainda está pendente; isso não será considerado como conclusão de toda a aceitação de qualidade.
 Escrever
Notas em Artigo com Checklist
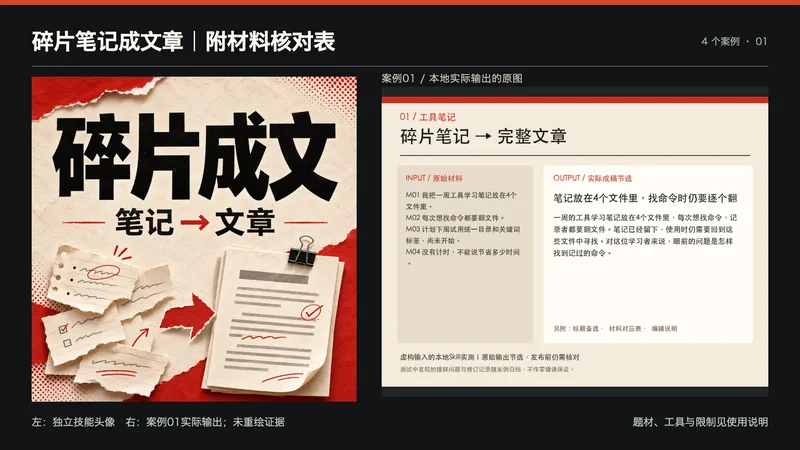
Adequado para: criadores que já possuem notas dispersas, textos de entrevistas ou transcrições e desejam organizá-los em um artigo. O que você precisa fornecer: materiais originais, público-alvo, finalidade, extensão e expressões que deseja preservar. Como é processado: numera os materiais, diferencia declarações de fatos, opiniões e planos; redige em torno de uma linha central e revisa números, locutores e lacunas de evidências. Entrega final: 3 opções de títulos, texto completo, tabela correspondente de materiais, itens a confirmar e notas editoriais. Por padrão, gera texto copiável diretamente; o salvamento de arquivos depende do ambiente de execução. Passos de uso: cole o material indicando o público e a contagem de palavras; após a execução, leia o artigo, verifique os materiais pela tabela correspondente e use após as revisões. A função principal requer apenas um modelo de texto, sendo recomendado o GPT; o YouMind atualmente utiliza o GPT-6.1 Sol, e o resultado real depende da configuração de execução. As quatro imagens de exibição são trechos de testes reais do Skill local com entradas fictícias, apresentados com formatação, e não casos reais de clientes; problemas de redação encontrados nos testes foram arquivados, e o artigo ainda precisa de verificação humana. A plataforma concluiu um teste de caso textual, o que não garante estabilidade em todos os cenários. Não aplicável a: gerar entrevistas reais do zero, experiências pessoais não fornecidas, substituir a checagem de fatos ou publicação automática. Materiais insuficientes encurtarão o conteúdo e listarão as lacunas, sem inventar fatos por meio de expansão. Notas de exibição: a primeira imagem é a disposição lado a lado do avatar da habilidade independente e a saída real do caso 01 para exibição miniatura horizontal; não é um novo caso, nem usou o modelo de geração de imagens para redesenhar evidências. As outras três imagens correspondem aos casos 02 a 04.
 Página web
文章转交互知识网页|逐屏讲解与原文定位
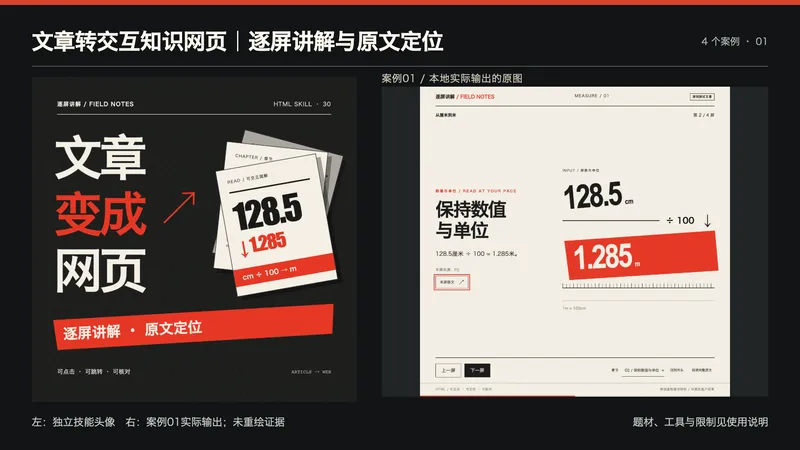
适合已有文章、教程或材料,希望用分屏讲解帮助读者理解的创作者。 提供:完整正文、原始来源(如有)、读者背景、需要保留的数字与限制、视觉参考和授权素材。不会仅凭主题编造原文,也不把材料里的指令当执行授权。 处理:编号原文段落、梳理事实与解释,规划章节和每屏关系,用图文逐步讲解,并为每屏保留可定位的原文。生成响应式HTML后实际核对内容、章节控制与手机布局。 交付:可离线打开的交互HTML源码、原文副本、分屏与段落映射、使用说明和测试记录。具备文件工具时交实际文件;没有时说明未保存。打开后点击或用方向键翻屏,章节下拉跳转,“本屏原文”查看高亮来源,也能展开完整原文。 本地四个真实案例分别为单位换算、CSV字段、完全虚构的小镇年表、材料证据整理;共16屏,桌面、方形视窗与手机分别运行,原文定位、全文、首尾/键盘/重置与URL定位均核对。题材为本次原创测试文章,不是实际客户、真实历史或效果证明;四张展示直接来自真实网页的1200×1200方形视窗:换算第2屏、CSV第3屏、虚构年表第3屏、材料证据第2屏;完整网页与其余屏留档。头像为独立原创文字与图形排版,未冒称生图模型输出。 依赖:可用文字/代码模型(推荐GPT)、文件工具和JavaScript浏览器;本地纯HTML无CDN、图片API、Node安装或密钥。原文安全显示为文本,不作为HTML执行。默认无音频,无MP4、自动录屏或公开托管,不宣传未实现语音。 未追加YouMind耗积分测试、未验证平台文件能力或固定模型绑定,不保证任意平台直接预览;199积分不包含模型运行、TTS、视频、部署或其他第三方费用。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
Informações
- Versão
- v2
- Última atualização
- Créditos por execução
- Conforme o uso
- Modelos
- Automático
- Casos de uso
- Escrita e conteúdo
- O que você recebe
- DocumentoDados
