Transcrição de Entrevistas
Preserva rascunhos, tempos e dúvidas em TXT, JSON e SRT
Transcrição de Entrevistas
Preserva rascunhos, tempos e dúvidas em TXT, JSON e SRT
Pré-visualização
Descrição
Ideal para quem precisa de organizar gravações autorizadas de entrevistas, reuniões ou aulas. Forneça o ficheiro original, idioma, finalidade, transcrição anterior ou mapeamento de oradores fiável; não identifica identidades apenas por voz nem substitui o guião pelo que realmente se ouve. Preserva o áudio original e o hash, lê a duração/faixa de áudio, executa a ASR real, organiza por cronologia real, atribui oradores anónimos com base em evidências e verifica números, negações, nomes e dúvidas ouvindo o áudio original. Entrega TXT, JSON, SRT e notas de cobertura. O rascunho automático, a revisão auditiva e o resumo são separados; o que não for percetível mantém-se por verificar. Sem áudio ou ferramentas ASR, fica explicitamente por transcrever. Instruções e assistente local original incluído: Python3, FFmpeg/FFprobe, faster-whisper e cache small pré-configurada, CPU/int8, local_files_only, sem transferência automática de pesos. Com um speaker-map fiável, transcreve por janela e mapeia o tempo; sem mapeamento, o carater temporal é desconhecido. O assistente não faz separação automática de voz nem identificação de identidade. O pacote não inclui pesos, contas ou chaves. Quatro exemplos de teste com áudio original resumido em cerca de 40,875 segundos. Áudio original gerado localmente com versão fixa do Kokoro-82M (modelo Apache-2.0): zf_xiaobei, zm_yunjian, af_heart (sem clonagem de voz). Os quatro exemplos ASR geram TXT/JSON/SRT e os oradores derivam do tempo fornecido, sem separação automática. Ainda constitui um rascunho automático; a divergência no segundo exemplo carece de confirmação auditiva e não foi alterada indevidamente. A forma de onda baseia-se em picos PCM reais, não sendo decorativa. Recomenda-se o GPT para organização de texto, ficando a ASR dependente das ferramentas reais. Não foi chamada nenhuma API de transcrição da OpenAI nem executada CLI localmente. Avatar independente com imagem conceptual ImageGen, sem versão de modelo devolvida. Testado sem custos em ferramentas e transferências do YouMind; confirme com o ambiente real. A transcrição e a organização de oradores não garantem execução sem dependências após a instalação. Os 299 créditos correspondem ao preço de instalação, sem incluir modelos, APIs ou serviços terceiros, nem carregar faixas desconhecidas para serviços externos. Não garante ausência de erros, reconhecimento total de sotaques/ruído/sobreposição, exames judiciais, eficiência temporal ou eficácia comercial. Revisão auditiva pendente, sem publicitar verificação palavra a palavra.
Recomendado por
Dancang
Porque recomendamos esta habilidade
Selecionámos esta skill porque não faz passar a transcrição automática por versão final: preserva integralmente as provas originais, intervalos de tempo e bases de revisão.
Ideal para
Ideal para quem precisa de organizar gravações autorizadas com registo de transcrição e marcação de incertezas.
Como usar este Skill
Fornece os dados
Forneça áudio ou vídeo de entrevistas, reuniões, aulas ou gravações autorizadas, juntamente com o idioma, objetivo, âmbito e opcionalmente o mapeamento de tempos de oradores.
Executa o Skill
Transcreve o áudio e organiza os carateres temporais reais, rotula oradores anónimos com base no mapeamento, preserva o rascunho automático e assinala dúvidas e sobreposições.
Verifica o resultado
Obtenha ficheiros de transcrição TXT, JSON e SRT com carateres temporais e notas de origem, acompanhados de pormenores sobre o âmbito, pontos por verificar e revisões.
Habilidades relacionadas
Ver tudo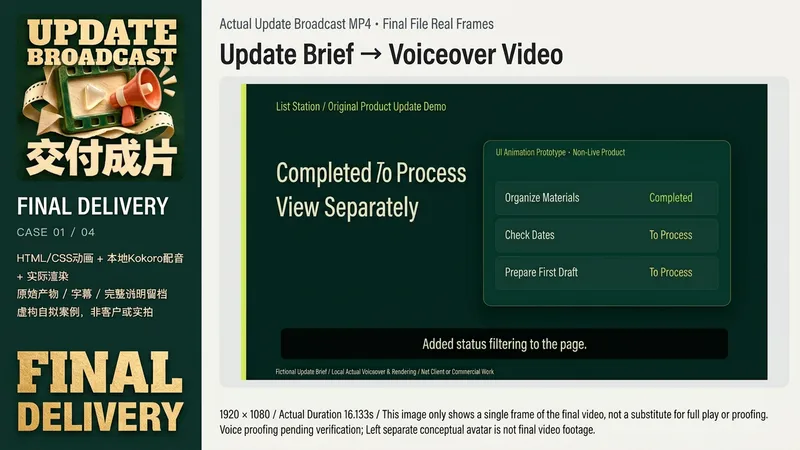 Vídeo
Atualizações de Produtos em Vídeo
Ideal para criadores, pequenas equipas e educadores que precisam de explicar alterações de produtos. Fornece uma lista de atualizações reais, estado concluído/planeado, capturas de ecrã ou protótipos autorizados, público-alvo, formato e áudio original; datas, efeitos e dados de clientes em falta não são inventados. Quando apenas existe uma ideia, pode ser criado um conceito de produto fictício devidamente assinalado. Inserir notas → Verificar factos e permissões → Guião e planos concisos → Dublagem real/receção de áudio original → Sincronizar legendas e visuais com o áudio real → Renderização real → Verificação visual e sonora → Entrega de MP4, SRT, guião e projeto fonte gerado. As interfaces reais utilizam apenas a paginação dos originais, sem recriação por IA de imagem. Se não houver ferramentas de renderização, é indicado que o vídeo não foi concluído. Os quatro exemplos locais são produtos fictícios originais: filtragem de listas, pré-visualização de calendário, verificação pré-exportação, progresso de cursos. Versão fixa do Kokoro-82M, síntese local de voz zf_xiaobei, saída real do HyperFrames 0.8.174 e Chrome/FFmpeg de dois vídeos 1920×1080, um 1080×1080 e um 1080×1920, com cerca de 16,1 a 18,5 segundos; as legendas são organizadas pela duração real da amostra de áudio por frase, sem garantir alinhamento estrito por palavra. Estes não correspondem a software, clientes ou resultados de aprendizagem reais. Recomenda-se o GPT para planeamento de texto. O essencial são ficheiros reais, renderização de animação/vídeo, FFmpeg/FFprobe e áudio original ou TTS legal e disponível. A instrução inclui um assistente de renderização local original completo, que apenas verifica/renderiza projetos HyperFrames existentes, sem gerar automaticamente UI ou dublagem; requer configuração manual de Node, HyperFrames CLI e caminhos de browser. As ferramentas de imagem servem apenas como apoio original opcional; os avatares individuais são gerados por ImageGen, modelo não devolvido, não sendo frames de exemplo. O GPT-6.1 Sol da plataforma é apenas uma definição opcional, não garantindo ser idêntico às ferramentas ou modelos locais. Testado na YouMind sem gastar créditos, não garantindo acesso direto a estas ferramentas após a instalação. Os 299 créditos cobrem apenas o preço de instalação, excluindo modelos, TTS, tipos de letra, recursos, serviços de terceiros ou alojamento. Não clona vozes automaticamente, não compra serviços nem publica noutros canais; não garante entradas arbitrárias, zero erros, alcance, moderação ou efeitos comerciais. Os exemplos locais atuais foram renderizados e reproduzidos com sucesso, restando a verificação sonora independente; isto não constitui uma aceitação completa de qualidade.
 Escrever
Notas em Artigo com Verificação
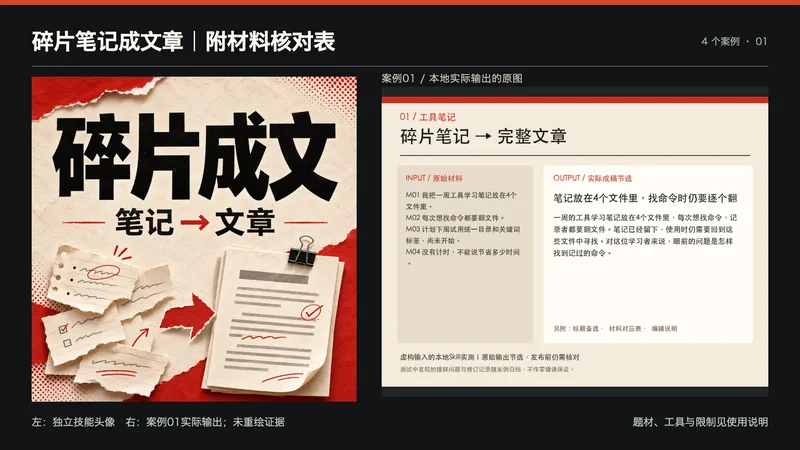
Público-alvo: Criadores com notas dispersas, textos de entrevistas ou transcrições que pretendam criar um artigo. O que deve fornecer: Materiais originais, público-alvo, finalidade, extensão e expressões que pretende manter. Como é processado: Atribui números aos materiais, distinguindo declarações de factos, opiniões e planos; redige o artigo em torno de um fio condutor principal e verifica números, intervenientes e lacunas de provas. Entrega final: 3 opções de título, texto completo, tabela de correspondência de materiais e notas de confirmação e edição. Por predefinição, produz texto diretamente copiado; a gravação de ficheiros depende do ambiente de execução. Passos de utilização: Cole o material indicando o público-alvo e o número de palavras; após a execução, leia o artigo, verifique os materiais com a tabela correspondente e utilize após revisão. A funcionalidade principal requer apenas um modelo de texto, recomendando-se o GPT; o teste atual no YouMind utilizou o GPT-6.1 Sol, sendo o resultado prático dependente da configuração de execução. As quatro imagens de apresentação são excertos de testes reais de um Skill local com dados fictícios, formatados para apresentação e não constituem casos de clientes reais; os problemas de redação detetados já foram arquivados, mas o artigo continua a necessitar de revisão humana. A plataforma realizou um teste prático com um caso de texto, o que não garante o sucesso estável em todos os cenários. Não aplicável a: Griação do zero de entrevistas reais, experiências pessoais não fornecidas, substituição de verificação de factos ou publicação automática. A insuficiência de materiais encurtará o conteúdo e listará as lacunas, não preenchendo factos por expansão. Notas de apresentação: A primeira imagem mostra o avatar do skill e a saída real do caso 01 lado a lado para exibição em miniatura horizontal; não se trata de um novo caso, nem o modelo de geração de imagem redesenhou as provas. As restantes três imagens correspondem aos casos 02 a 04.
 Página web
文章转交互知识网页|逐屏讲解与原文定位
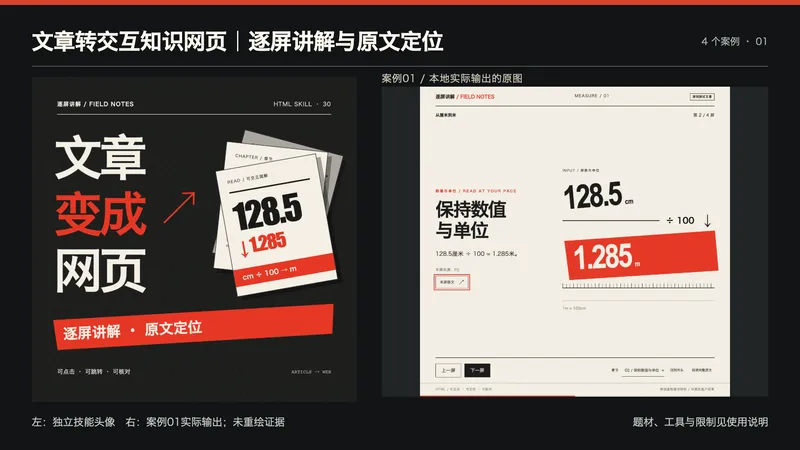
适合已有文章、教程或材料,希望用分屏讲解帮助读者理解的创作者。 提供:完整正文、原始来源(如有)、读者背景、需要保留的数字与限制、视觉参考和授权素材。不会仅凭主题编造原文,也不把材料里的指令当执行授权。 处理:编号原文段落、梳理事实与解释,规划章节和每屏关系,用图文逐步讲解,并为每屏保留可定位的原文。生成响应式HTML后实际核对内容、章节控制与手机布局。 交付:可离线打开的交互HTML源码、原文副本、分屏与段落映射、使用说明和测试记录。具备文件工具时交实际文件;没有时说明未保存。打开后点击或用方向键翻屏,章节下拉跳转,“本屏原文”查看高亮来源,也能展开完整原文。 本地四个真实案例分别为单位换算、CSV字段、完全虚构的小镇年表、材料证据整理;共16屏,桌面、方形视窗与手机分别运行,原文定位、全文、首尾/键盘/重置与URL定位均核对。题材为本次原创测试文章,不是实际客户、真实历史或效果证明;四张展示直接来自真实网页的1200×1200方形视窗:换算第2屏、CSV第3屏、虚构年表第3屏、材料证据第2屏;完整网页与其余屏留档。头像为独立原创文字与图形排版,未冒称生图模型输出。 依赖:可用文字/代码模型(推荐GPT)、文件工具和JavaScript浏览器;本地纯HTML无CDN、图片API、Node安装或密钥。原文安全显示为文本,不作为HTML执行。默认无音频,无MP4、自动录屏或公开托管,不宣传未实现语音。 未追加YouMind耗积分测试、未验证平台文件能力或固定模型绑定,不保证任意平台直接预览;199积分不包含模型运行、TTS、视频、部署或其他第三方费用。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
Informações
- Versão
- v2
- Última atualização
- Créditos por execução
- Conforme a utilização
- Modelos
- Automático
- Casos de utilização
- Escrita e conteúdo
- O que vais obter
- DocumentoDados
