ส่งออกSRTและถอดความคำบรรยายB站
แก้ปัญหาการถอดความของ B站 ที่ใช้ไม่ได้
ส่งออกSRTและถอดความคำบรรยายB站
แก้ปัญหาการถอดความของ B站 ที่ใช้ไม่ได้
พรีวิวเนื้อหา
คำอธิบาย
ในกรณีที่สามารถดึงคำบรรยายและสร้างไฟล์ srt ได้สำเร็จ โหมด AUTO มีค่าใช้จ่าย【ต่ำสุด】ที่【77】เครดิต ---————————————————————————————————————————————————---- ปัจจุบัน ym ยังถอดความวิดีโอ B站 ได้ไม่ดีนัก จะค้างโดยตรง (ดังรูปที่ 3) ก่อนการปรับปรุงอย่างเป็นทางการ SKILL นี้สามารถรับคำบรรยาย AI อย่างเป็นทางการจากวิดีโอ B站 (ลิงก์ / หมายเลข BV / ไฟล์วิดีโอ YouMind) โดยใช้เบราว์เซอร์ที่เข้าสู่ระบบแล้ว สร้างเอกสารถอดความที่อ่านได้ และส่งออกไฟล์คำบรรยาย SRT มาตรฐานตามที่เลือก (ไฟล์ .srt ในเครื่อง + เอกสาร YouMind) มีการสอบเทียบ cid และตรวจสอบความสอดคล้องของคำบรรยายในตัว เพื่อหลีกเลี่ยงคำบรรยายที่ผิดหรือหมดอายุ ขั้นตอนการทำงานได้ถูกทำให้เรียบง่ายที่สุดแล้ว ตามคำแนะนำของ SKILL ใน【เมื่อจำเป็น (ดูตัวอย่าง】ให้คลิกที่คำบรรยาย AI ในหน้าเว็บวิดีโอ B站 ที่เปิดอยู่ เลือกภาษาจีน จากนั้นจะสามารถดึงข้อมูลได้ วิธีนี้เป็นวิธีที่เสถียรที่สุดในปัจจุบัน คำบรรยายที่วิดีโอมีมาให้ส่วนใหญ่จะไม่สามารถจดจำได้ ไฟล์จะถูกดาวน์โหลดไปยัง (~.download; ระบบ Mac. Windows ไม่ทราบ) ในมุมมองทีละบรรทัด คลิกอัปโหลด ---————————————————————————————————————————————————--- ปัญหาที่อาจพบในปัจจุบัน【ที่แก้ไขได้】มีดังนี้: 1. เมื่อเพิ่มลิงก์ B站 ในไฟล์ ym อาจเกิดการดึงข้อมูลล้มเหลว ในกรณีนี้ ให้คลิกที่ 【...】ที่มุมขวาบน จะมีตัวเลือกให้ดึงข้อมูลใหม่ หลังจากคลิกแล้วโอกาสสูงที่หน้าจอจะปรากฏปกติ แต่ไม่มีหน้าต่างวิดีโอขนาดเล็ก แต่จากนั้นให้เพิ่มลิงก์ใหม่อีกครั้งก็จะสามารถดึงข้อมูลได้สำเร็จ หรือ ปิดหน้าทั้งหมดแล้วเปิดใหม่ / คลิกลิงก์ที่แชร์จาก B站 (ไม่ใช่ลิงก์หน้าเว็บ) เพื่อลองใหม่ 2. ในระหว่างการทำงานของ SKILL อาจเกิดข้อผิดพลาดในการดึงคำบรรยายเป็นครั้งคราว อาจเกิดจากความสัมพันธ์ของวิดีโอที่ต้องเสียเงิน/ฟรี ให้ AI ซ่อมแซมงานโดยอัตโนมัติก็ได้ โดยทั่วไปหากทำตามขั้นตอนจะไม่มีปัญหานี้ ---————————————————————————————————————————————————--- บันทึกการตอบกลับอย่างเป็นทางการดังนี้: 1. วิดีโอ B站 นี้ไม่มีไฟล์คำบรรยาย เมื่อเราบันทึกลิงก์ B站 โดยค่าเริ่มต้นจะพยายามดึงไฟล์คำบรรยายนี้ แต่ไม่สำเร็จ จึงแสดงผลว่างเปล่า 2. งานดึงคำบรรยายเริ่มต้นโดย AI AI จะพยายามดึงสตรีมวิดีโอเพื่อถอดความ แต่ B站 ไม่รองรับวิธีนี้ จึงเกิดการหมุนวนตลอดเวลา ซึ่งจริงๆ แล้วล้มเหลวแล้ว ------ แนวทางแก้ไข 1. ลองดูว่ามีวิดีโอที่เกี่ยวข้องบน YouTube และ TikTok หรือไม่ วิดีโอจากทั้งสองเว็บไซต์นี้รองรับการดึงสตรีมวิดีโอเพื่อถอดความ การใช้วิธีที่สองข้างต้นจะสำเร็จ ------ การปรับปรุงในอนาคต: 1. เราจะปรับปรุงพฤติกรรมของ AI ในการ grabFileTranscript เพื่อหลีกเลี่ยงการดึงคำบรรยายจาก B站 เพื่อไม่ให้เกิดสถานการณ์นี้ ———————————————————————————————————————————————————————————————— หวังว่าจะมีการรองรับอย่างเป็นทางการในอนาคต ก่อนหน้านั้นสามารถใช้สิ่งนี้เป็นตัวกลาง สะสมเครดิตเล็กน้อยเพื่อชดเชย ขอบคุณทุกท่าน หากมีปัญหาสามารถ @火腿人肖恩 ในกลุ่มได้
ทักษะที่เกี่ยวข้อง
ดูทั้งหมด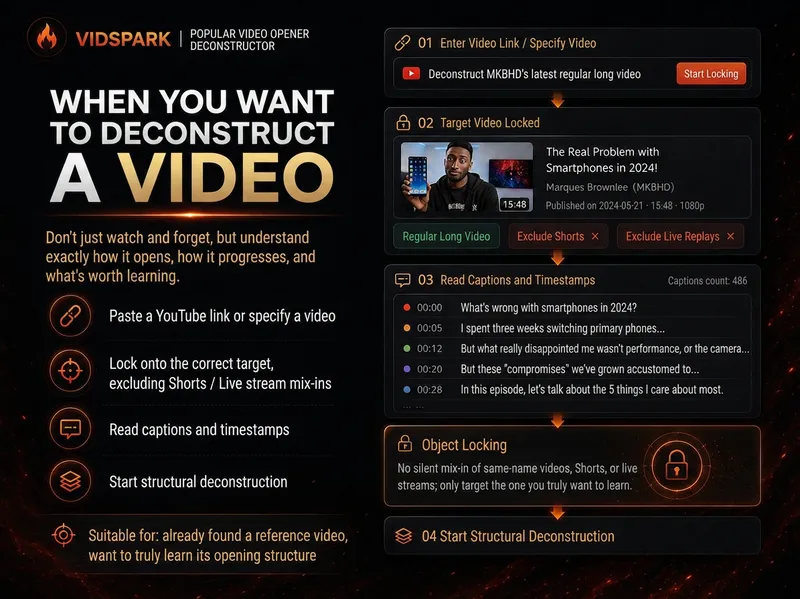 วิจัย
ประกายไฟ|แยกโครงสร้างคลิปฮิต
เมื่อเตรียมทำวิดีโอ เรามักเจอสถานการณ์ที่มองออกว่าวิดีโออ้างอิงบางคลิป “เล่าเก่งมาก” แต่พอถึงคราวทำเองกลับทำได้เพียงเลียนแบบตามความรู้สึก 「ประกายไฟ|แยกโครงสร้างคลิปฮิต」สร้างมาเพื่อขั้นตอนนี้โดยเฉพาะ เพียงส่งวิดีโอ YouTube ที่ระบุชัดเจนให้ระบบ ระบบจะยืนยันว่าเป็นวิดีโอใดและอ่านคำบรรยายที่ตรวจสอบได้ จากนั้นจะแยกสิ่งที่มักถูกนำมาปะปนกันออกเป็น 3 ส่วน: Literal 30s: สิ่งที่เกิดขึ้นจริงในวิดีโอช่วง 0:00–0:30 Intro: ช่วงเปิดเรื่องทั้งหมดก่อนเข้าสู่เนื้อหาหลัก Hook / Re-hook: หนึ่งจังหวะหรือหลายจังหวะเชิงโครงสร้างที่ทำหน้าที่ดึงผู้ชมให้อยู่ต่ออย่างแท้จริง ดังนั้น ระบบจะไม่ตีความช่วง 30 วินาทีแรกของทุกวิดีโอให้เป็น Hook เพียงเพราะ “ทุกคนบอกว่า 30 วินาทีแรกสำคัญที่สุด” หาก Hook ที่แท้จริงอยู่หลังนาทีแรก ระบบก็จะแจ้งตามนั้นอย่างตรงไปตรงมา และหากคำบรรยายหรือข้อมูลเวลาไม่เพียงพอ ระบบจะแสดงช่องว่างของหลักฐานอย่างชัดเจน แทนการเติมคำตอบที่ดูเป็นมืออาชีพแต่ไม่มีหลักฐานรองรับ หลังแยกโครงสร้างช่วงเปิดเรื่องแล้ว ระบบจะใช้โครงร่างเพื่อถอดโครงสร้างเนื้อหาของวิดีโอทั้งคลิปต่อไป: วิดีโอเดินเรื่องด้วยไทม์ไลน์ การทดลอง ขั้นตอน การเปรียบเทียบ เรื่องราว ลำดับคำถาม หรือกลไกการจัดเนื้อหาแบบอื่น? จากนั้นจึงสกัดโครงสร้างเหล่านี้ออกมาเป็นเทมเพลต [ช่อง] เทมเพลตจะคงลำดับและหน้าที่ของโครงสร้างไว้ ไม่ใช่ประสบการณ์ ถ้อยคำ แบรนด์ ตัวเลข มุมมอง หรือสถานะความน่าเชื่อถือของผู้สร้างต้นฉบับ สิ่งที่คุณได้รับจึงไม่ใช่เพียงสรุปวิดีโอ แต่คือ Hook Outline + เทมเพลตโครงสร้างทั้งคลิปที่สามารถส่งต่อให้ขั้นตอนการสร้างสรรค์ถัดไปใช้งานได้ สิ่งที่ระบบไม่ทำ ระบบจะไม่: เขียน Hook ใหม่ฉบับสุดท้ายแทนคุณโดยตรง ใช้ BRENS ให้คะแนนหรือเขียนช่วงเปิดเรื่องของคุณใหม่ ค้นหาตัวอย่างอ้างอิงจำนวนมากทั่วทั้งหมวดหมู่หรือช่อง สร้างสคริปต์ฉบับเต็ม สร้างภาพอธิบาย สื่อประกอบ แอนิเมชัน หรือภาพขนาดย่อ การค้นหาตัวอย่างอ้างอิงจำนวนมากเป็นหน้าที่ของ 「ประกายไฟ|นักวิจัยคอนเทนต์ YouTube」 ซึ่งเป็น Skill ในขั้นตอนก่อนหน้า ส่วนการขัดเกลา Hook ของคุณเองเป็นหน้าที่ของ Skill ที่เกี่ยวข้องในขั้นตอนถัดไป
 วิจัย
ถอดเสียงสัมภาษณ์และจัดเรียงผู้พูด
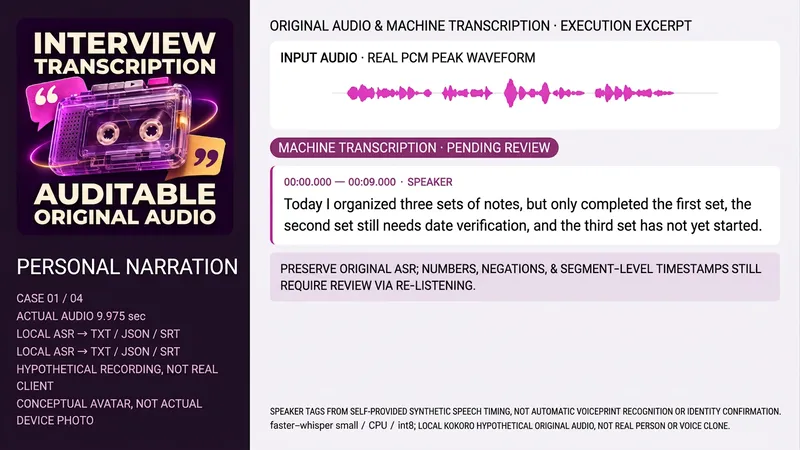
เหมาะสำหรับผู้ที่ต้องการจัดการบันทึกเสียงการสัมภาษณ์ การประชุม หรือหลักสูตรที่ได้รับอนุญาต ระบุไฟล์ต้นฉบับ ภาษา วัตถุประสงค์ บันทึกย่อที่มีอยู่ หรือการแมปเวลาผู้พูดที่เชื่อถือได้ โดยไม่สามารถยืนยันตัวตนจากเสียงได้เพียงอย่างเดียว และจะไม่ถือว่าสคริปต์เป็นเนื้อหาที่ได้ยินจริง เก็บรักษาเสียงต้นฉบับและแฮช อ่านระยะเวลา/แทร็กเสียง การถอดเสียงจริง จัดเรียงตามไทม์ไลน์จริง ติดป้ายกำกับผู้พูดนิรนามเมื่อมีหลักฐาน ตรวจสอบตัวเลข/คำปฏิเสธ/ชื่อและจุดสงสัยย้อนหลังจากเสียงเดิม ส่งมอบ TXT, JSON, SRT และคำอธิบายการครอบคลุม แยกฉบับร่างของเครื่อง การตรวจสอบการฟัง และสรุปออกจากกัน ส่วนที่ฟังไม่ชัดจะยังคงรอการตรวจสอบและจะไม่ถูกเติมคำเพื่อให้ลื่นไหล หากไม่มีเครื่องมือเสียง/ASR จะระบุว่ายังไม่ได้ถอดเสียงอย่างชัดเจน คำสั่งและแพ็กเกจมีตัวช่วยท้องถิ่นดั้งเดิมที่สมบูรณ์ ได้แก่ Python3, FFmpeg/FFprobe, faster-whisper และแคช small ที่กำหนดค่าไว้ล่วงหน้า, CPU/int8, local_files_only และไม่ดาวน์โหลดน้ำหนักโดยอัตโนมัติ เมื่อมีการระบุตัวแมปผู้พูดที่น่าเชื่อถือพร้อมเวลาเริ่มต้น-สิ้นสุดและป้ายกำกับนิรนาม ระบบจะทำการถอดเสียงและแมปเวลาตามหน้าต่างจริง หากไม่มีการแมป เวลาจะถูกระบุว่าไม่ทราบ ผู้ช่วยไม่มีการแยกเสียงหรือระบุตัวตนอัตโนมัติ และในแพ็กเกจไม่มีน้ำหนัก/บัญชี/คีย์ ตัวอย่างสี่รายการ ได้แก่ การบอกเล่าส่วนตัวภาษาจีน การสัมภาษณ์สองคนภาษาจีน คำอธิบายหลักสูตรภาษาอังกฤษ และการประชุมสองคนภาษาจีน รวมเสียงต้นฉบับประมาณ 40.875 วินาที เสียงต้นฉบับสุดท้ายใช้รุ่น Kokoro-82M ที่ระบุในโมเดลการ์ด Apache-2.0 สังเคราะห์ในเครื่อง ได้แก่ zf_xiaobei, zm_yunjian, af_heart ซึ่งไม่ใช่คนจริงหรือการโคลนเสียง และไม่มีการแจกจ่ายโมเดล เสียง หรือเสียงตัวอย่างพร้อมแพ็กเกจการติดตั้ง การถอดเสียงจริงทั้ง 4 รายการสร้าง TXT/JSON/SRT โดยผู้พูดมาจากไทม์ไลน์การพูดสังเคราะห์ที่ให้ไว้ ไม่ใช่การแยกผู้พูดอัตโนมัติ ปัจจุบันยังคงเป็นฉบับร่างของเครื่อง โดยความแตกต่างระหว่างการถอดเสียง "ร่างออก" และ "ร่าง" ของสคริปต์ในตัวอย่างที่สองรอการฟังซ้ำเพื่อยืนยัน และไม่มีการเปลี่ยนแปลงเป็นคำพูดจริงโดยพลการ รูปคลื่นมาจากพีค PCM ที่ป้อนจริง ไม่ใช่คลื่นเสียงประดับ แนะนำให้ใช้ GPT สำหรับการจัดระเบียบข้อความ และให้เครื่องมือ ASR เป็นหลัก ไม่มีการเรียกใช้ API ถอดเสียงของ OpenAI หรือรัน CLI ต้นน้ำในท้องถิ่น รูปโปรไฟล์อิสระเป็นภาพแนวคิด ImageGen เครื่องมือไม่ส่งคืนรุ่นและไม่ประกาศ Image2 เครื่องมือใน YouMind แคช การดาวน์โหลดไฟล์ และการผูกโมเดลไม่มีการใช้คะแนนในการทดสอบ ซึ่งจำเป็นต้องยืนยันตามสภาพแวดล้อมจริง การถอดเสียงและการจัดเรียงผู้พูดไม่ได้รับประกันว่าจะทำงานได้โดยไม่มีการพึ่งพาหลังการติดตั้ง 299 คะแนนคือราคาติดตั้ง ไม่รวมโมเดล/API หรือบริการของบุคคลที่สาม ไม่มีการซื้ออัตโนมัติ และไม่มีการอัปโหลดแทร็กเสียงที่ไม่รู้จักไปยังบริการอื่นโดยแอบแฝง ไม่รับประกันข้อผิดพลาดเป็นศูนย์ การระบุสำเนียง/เสียงรบกวน/การทับซ้อนของหลายคนอย่างสมบูรณ์ การระบุทางกฎหมาย/ตัวตน ประสิทธิภาพเวลา หรือผลลัพธ์ทางธุรกิจ การตรวจสอบการฟังอิสระรอการเติมเต็ม และไม่มีการโฆษณาว่ามีการตรวจสอบข้อความทีละคำ
ถอดโครงสร้างคอนเทนต์
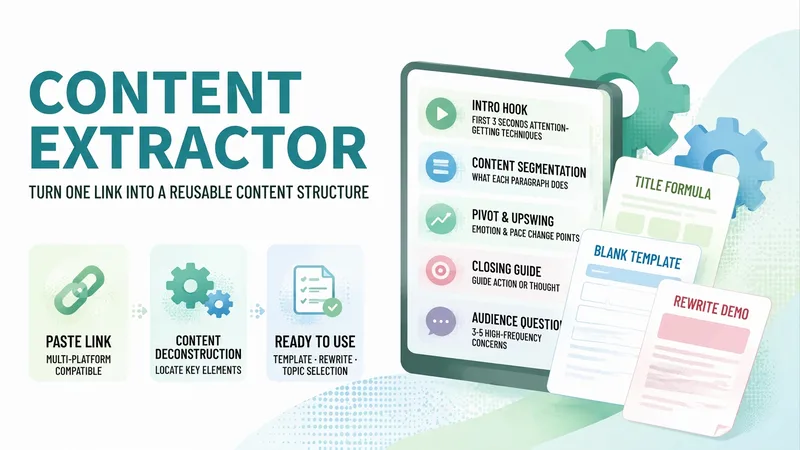
เจอคอนเทนต์ที่เล่าได้ดีมากและอยากเรียนรู้โครงสร้าง แต่ไม่รู้จะเริ่มจากตรงไหนใช่ไหม 【แบบถอดคอนเทนต์】จะแยกลิงก์หนึ่งรายการ (抖音/小红书/公众号/B站/微博/知乎) ออกมาเป็นโครงสร้างที่นำไปใช้ได้ทันที: เทคนิคที่ใช้สร้างฮุกใน 3 วินาทีแรก เนื้อหาแบ่งเป็นกี่ช่วงและแต่ละช่วงทำหน้าที่อะไร จุดเปลี่ยนและช่วงเร่งอารมณ์อยู่ตรงไหน รวมถึงตอนจบชวนให้ผู้ชมทำอะไร จากนั้นจะมอบสิ่งที่ใช้ได้จริงอีก 3 อย่าง ได้แก่ สูตรหัวข้อที่สรุปเป็นแบบแผน (พร้อมตัวอย่าง 3 แบบในสายงานของคุณ) เทมเพลตโครงสร้างเปล่าที่มีช่องให้กรอก และตัวอย่างการเขียนใหม่จากหัวข้อที่คุณเลือกเอง นอกจากนี้ยังดึงคำถาม 3–5 ข้อที่ผู้ชมสนใจจริงจากความคิดเห็นสาธารณะ เพื่อเปลี่ยนเป็นหัวข้อสำหรับตอนถัดไปของคุณได้ทันที ขอบเขตที่บอกไว้อย่างตรงไปตรงมา: หากอ่านเนื้อหาจากลิงก์ได้ จะแจ้งว่า “อ้างอิงจากต้นฉบับ” หากอ่านไม่ได้ จะบอกตามจริงว่าอ่านไม่ได้ พร้อมแนะนำวิธีรวบรวมเนื้อหา 3 ขั้นตอน และจะไม่แต่งเนื้อหาขึ้นมาเองจากลิงก์โดยเด็ดขาด กฎสำคัญ: ไม่ดาวน์โหลดวิดีโอ ไม่ลบลายน้ำ ไม่หลีกเลี่ยงกำแพงการเข้าสู่ระบบหรือเพย์วอลล์ ไม่คัดลอกต้นฉบับ ไม่ทำเนื้อหาเลียนแบบต้นฉบับ และไม่ดึงข้อมูลส่วนบุคคลของผู้อื่น
ข้อมูล
- เวอร์ชัน
- v11
- อัปเดตล่าสุด
- เครดิตในการใช้งาน
- ตามการใช้งานจริง
- โมเดล
- อัตโนมัติ
