การถอดเสียงวิดีโอ
การถอดเสียงวิดีโอ
พรีวิวเนื้อหา
คำอธิบาย
ถอดเสียงวิดีโอหรือไฟล์เสียงในเครื่องให้เป็นคำบรรยาย SRT พร้อมประทับเวลาและข้อความทั่วไป โดยเน้นการประมวลผลภายในเครื่องและรองรับบริการ ASR ระยะไกลที่กำหนดค่าไว้เมื่อได้รับความยินยอม
ทักษะที่เกี่ยวข้อง
ดูทั้งหมด เขียน
เสียงเป็นร่างเอกสาร
เปลี่ยนไฟล์เสียง วอยซ์โน้ต วิดีโอที่มีเสียงพูด หรือทรานสคริปต์ ให้เป็นร่างเอกสารที่แก้ไขได้และมีเนื้อหาสอดคล้องกัน ระบบจะถอดเสียงส่วนที่ยังไม่มีข้อความโดยอัตโนมัติ และทำงานต่อเบื้องหลังเมื่อจำเป็น ผู้ใช้จึงไม่ต้องกลับมาเริ่มขั้นตอนต่อเอง
 วิจัย
เสียงเป็นงานและมติ
เปลี่ยนไฟล์เสียงหรือบทถอดเสียงให้เป็นบันทึกสั้น ๆ ที่แก้ไขได้ ซึ่งประกอบด้วยมติ งาน ผู้รับผิดชอบ วันที่ อุปสรรค และคำถามที่ยังเปิดอยู่ หากไม่มีข้อความจากเสียง ระบบจะถอดเสียงให้อัตโนมัติ และทำงานต่อเบื้องหลังเมื่อจำเป็น ก่อนเสนอการดำเนินการของ Agent ที่เป็นตัวเลือก
 วิจัย
ถอดเสียงสัมภาษณ์และจัดเรียงผู้พูด
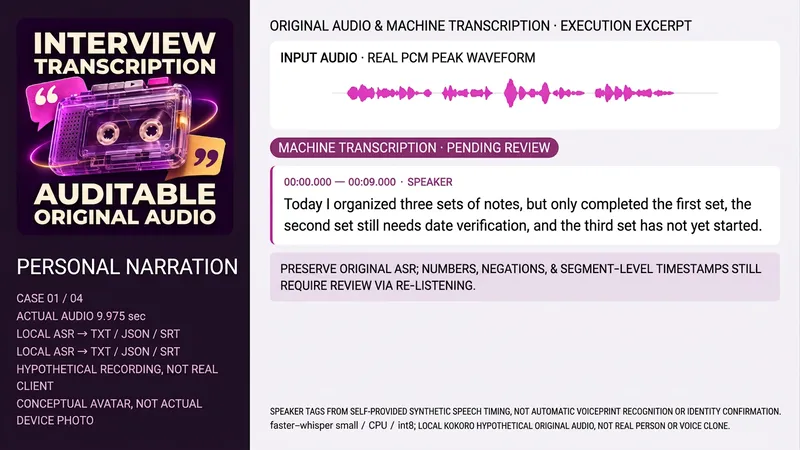
เหมาะสำหรับผู้ที่ต้องการจัดการบันทึกเสียงการสัมภาษณ์ การประชุม หรือหลักสูตรที่ได้รับอนุญาต ระบุไฟล์ต้นฉบับ ภาษา วัตถุประสงค์ บันทึกย่อที่มีอยู่ หรือการแมปเวลาผู้พูดที่เชื่อถือได้ โดยไม่สามารถยืนยันตัวตนจากเสียงได้เพียงอย่างเดียว และจะไม่ถือว่าสคริปต์เป็นเนื้อหาที่ได้ยินจริง เก็บรักษาเสียงต้นฉบับและแฮช อ่านระยะเวลา/แทร็กเสียง การถอดเสียงจริง จัดเรียงตามไทม์ไลน์จริง ติดป้ายกำกับผู้พูดนิรนามเมื่อมีหลักฐาน ตรวจสอบตัวเลข/คำปฏิเสธ/ชื่อและจุดสงสัยย้อนหลังจากเสียงเดิม ส่งมอบ TXT, JSON, SRT และคำอธิบายการครอบคลุม แยกฉบับร่างของเครื่อง การตรวจสอบการฟัง และสรุปออกจากกัน ส่วนที่ฟังไม่ชัดจะยังคงรอการตรวจสอบและจะไม่ถูกเติมคำเพื่อให้ลื่นไหล หากไม่มีเครื่องมือเสียง/ASR จะระบุว่ายังไม่ได้ถอดเสียงอย่างชัดเจน คำสั่งและแพ็กเกจมีตัวช่วยท้องถิ่นดั้งเดิมที่สมบูรณ์ ได้แก่ Python3, FFmpeg/FFprobe, faster-whisper และแคช small ที่กำหนดค่าไว้ล่วงหน้า, CPU/int8, local_files_only และไม่ดาวน์โหลดน้ำหนักโดยอัตโนมัติ เมื่อมีการระบุตัวแมปผู้พูดที่น่าเชื่อถือพร้อมเวลาเริ่มต้น-สิ้นสุดและป้ายกำกับนิรนาม ระบบจะทำการถอดเสียงและแมปเวลาตามหน้าต่างจริง หากไม่มีการแมป เวลาจะถูกระบุว่าไม่ทราบ ผู้ช่วยไม่มีการแยกเสียงหรือระบุตัวตนอัตโนมัติ และในแพ็กเกจไม่มีน้ำหนัก/บัญชี/คีย์ ตัวอย่างสี่รายการ ได้แก่ การบอกเล่าส่วนตัวภาษาจีน การสัมภาษณ์สองคนภาษาจีน คำอธิบายหลักสูตรภาษาอังกฤษ และการประชุมสองคนภาษาจีน รวมเสียงต้นฉบับประมาณ 40.875 วินาที เสียงต้นฉบับสุดท้ายใช้รุ่น Kokoro-82M ที่ระบุในโมเดลการ์ด Apache-2.0 สังเคราะห์ในเครื่อง ได้แก่ zf_xiaobei, zm_yunjian, af_heart ซึ่งไม่ใช่คนจริงหรือการโคลนเสียง และไม่มีการแจกจ่ายโมเดล เสียง หรือเสียงตัวอย่างพร้อมแพ็กเกจการติดตั้ง การถอดเสียงจริงทั้ง 4 รายการสร้าง TXT/JSON/SRT โดยผู้พูดมาจากไทม์ไลน์การพูดสังเคราะห์ที่ให้ไว้ ไม่ใช่การแยกผู้พูดอัตโนมัติ ปัจจุบันยังคงเป็นฉบับร่างของเครื่อง โดยความแตกต่างระหว่างการถอดเสียง "ร่างออก" และ "ร่าง" ของสคริปต์ในตัวอย่างที่สองรอการฟังซ้ำเพื่อยืนยัน และไม่มีการเปลี่ยนแปลงเป็นคำพูดจริงโดยพลการ รูปคลื่นมาจากพีค PCM ที่ป้อนจริง ไม่ใช่คลื่นเสียงประดับ แนะนำให้ใช้ GPT สำหรับการจัดระเบียบข้อความ และให้เครื่องมือ ASR เป็นหลัก ไม่มีการเรียกใช้ API ถอดเสียงของ OpenAI หรือรัน CLI ต้นน้ำในท้องถิ่น รูปโปรไฟล์อิสระเป็นภาพแนวคิด ImageGen เครื่องมือไม่ส่งคืนรุ่นและไม่ประกาศ Image2 เครื่องมือใน YouMind แคช การดาวน์โหลดไฟล์ และการผูกโมเดลไม่มีการใช้คะแนนในการทดสอบ ซึ่งจำเป็นต้องยืนยันตามสภาพแวดล้อมจริง การถอดเสียงและการจัดเรียงผู้พูดไม่ได้รับประกันว่าจะทำงานได้โดยไม่มีการพึ่งพาหลังการติดตั้ง 299 คะแนนคือราคาติดตั้ง ไม่รวมโมเดล/API หรือบริการของบุคคลที่สาม ไม่มีการซื้ออัตโนมัติ และไม่มีการอัปโหลดแทร็กเสียงที่ไม่รู้จักไปยังบริการอื่นโดยแอบแฝง ไม่รับประกันข้อผิดพลาดเป็นศูนย์ การระบุสำเนียง/เสียงรบกวน/การทับซ้อนของหลายคนอย่างสมบูรณ์ การระบุทางกฎหมาย/ตัวตน ประสิทธิภาพเวลา หรือผลลัพธ์ทางธุรกิจ การตรวจสอบการฟังอิสระรอการเติมเต็ม และไม่มีการโฆษณาว่ามีการตรวจสอบข้อความทีละคำ
ข้อมูล
- เวอร์ชัน
- v2
- อัปเดตล่าสุด
- เครดิตในการใช้งาน
- ตามการใช้งานจริง
- โมเดล
- อัตโนมัติ
