Yapay Zeka İzlerini Kaldırma
Yapay zeka metin izlerini kaldıran skill
İçerik önizlemesi
Açıklama
GitHub'da 7,3 bin+ yıldız alan lieflat-less-ai-tone projesine dayanan ve iki tur gerçek test derlemesine (toplam 1.169 makale, yaklaşık 5,2 milyon Çince karakter, 100+ gösterge ve yaklaşık 500 bin model anlamsal yargısı) dayanan bir yapay zeka izi silme Skill'idir. Bu Skill, "yapay zekalık" durumunu nicelleştirmek için iki tur veri deneyi gerçekleştirmiştir: Birinci turda 629 makale (2,83 milyon karakter), ikinci turda ise 540 eşleştirilmiş makale (2,56 milyon karakter) taranmıştır. Süreç toplam 1.169 makaleyi ve 5,2 milyon Çince karakteri kapsamaktadır. Skill, piyasadaki olası "yapay zeka" izlerini 100'den fazla göstergeye ayırmış; komut dosyası denetimi, büyük model anlamsal denetimi ve manuel kör değerlendirme olmak üzere üç yöntem kullanarak cümle cümle ve paragraf paragraf 507 bin makine anlamsal yargısı çalıştırmış ve son olarak kapsamlı manuel kör okuma değerlendirmeleri yapmıştır. Son olarak herkesin kullanımını kolaylaştırmak amacıyla bu çalışma bir Skill olarak sunulmuş ve lieflat-less-ai-tone projesi hayata geçirilmiştir. Skill, ilk olarak göstergeler, araştırma referansları, orijinal cümle örnekleri ve düzeltme yöntemlerini içeren bir denetim raporu sunar. Kullanıcı yanıt verdikten sonra yeniden yazma ve yeniden test etme adımlarına geçer.
Öneren
Dancang
Bu beceriyi neden öneriyoruz
Büyük ölçekli kontrol derlemelerine ve çok turlu semantik testlere dayalı olarak önce algılar ve kanıtları açıklar, ardından onaylanan minimum yeniden yazma ve yeniden test sürecini uygular.
Kimler için uygun
Orijinal anlamı, gerçekleri ve metin yapısını korurken metinlerindeki yapay zeka yazım izlerini azaltmak isteyen yazarlar için uygundur.
Bu Skill nasıl kullanılır
Girdinizi sağlayın
Incelenmesini istediğiniz makaleyi veya metni sağlayın ve odaklanılmasını istediğiniz alanları belirtebilirsiniz.
Skill’i çalıştırın
Metindeki olası yapay zeka yazım izlerini analiz eder, örnek cümleler ve düzenleme önerileri içeren bir rapor sunar; onay alındıktan sonra, seçilen önerilere göre metni minimum düzeyde yeniden yazar ve yeniden test eder.
Sonucu inceleyin
Düzenleme öncesi kontrol raporu, yeniden yazılmış metin ve düzenleme öncesi ile sonrası arasındaki karşılaştırma sonuçları elde edilir.
İlgili beceriler
Tümünü gör Yaz
Çince Yapay Zeka Havası Giderme
Çince metinleri, orijinal gerçekleri, duruşu ve ton gücünü korurken belirli senaryolarda gerçek bir insan tarafından yazılmış gibi gösterin. İster WeChat mesajı, e-posta, Xiaohongshu gönderisi, iş raporu veya makale olsun, ifade sorunları ve türler tespit edilir, ardından klişeler, yüzeysel ifadeler, mekanik yapılar, isimleşmiş cümle kalıpları ve bağlama uymayan tonlar hedeflenerek temizlenir. Böylece metinler daha somut, doğal ve akıcı hale gelirken aşırı konuşma diline kaçmaz. Revizyon sırasında gerçek sınırlarına katı bir şekilde uyulur: İzin alınmadan sayı, tarih, kişi adı, kurum, örnek, taahhüt veya etki eklenmez; "mümkün" kelimesi "kesinlikle" olarak değiştirilmez, kritik kısıtlamalar ve sonuçlar silinmez. Orijinal metinde eksik olan gerekli bilgilerin bulunduğu yerler, sırf metin tam görönsün diye detay uydurmaktan kaçınmak için eklenecekler olarak açıkça işaretlenir; makale ve iş raporlarındaki standart resmi ifadeler ise "yapay zeka havası" olarak yanlış değerlendirilip zorla yumuşatılmaz. Gerçekler açısından doğrulanmış ve ikincil kontrolden geçmiş, doğrudan iletişim, yayın, raporlama veya akademik yazımda kullanılmaya uygun Çince revizyon sonuçları elde edersiniz. Gerektiğinde belirli iz değerlendirmelerini, değişiklik gerekçelerini ve eksik bilgileri inceleyerek nerelerin ayarlandığını ve revizyon öncesi ile sonrası bilgi bütünlüğünün nasıl korunduğunu net bir şekilde görebilirsiniz.
AI Ders Kitabı Kalite Uzmanı
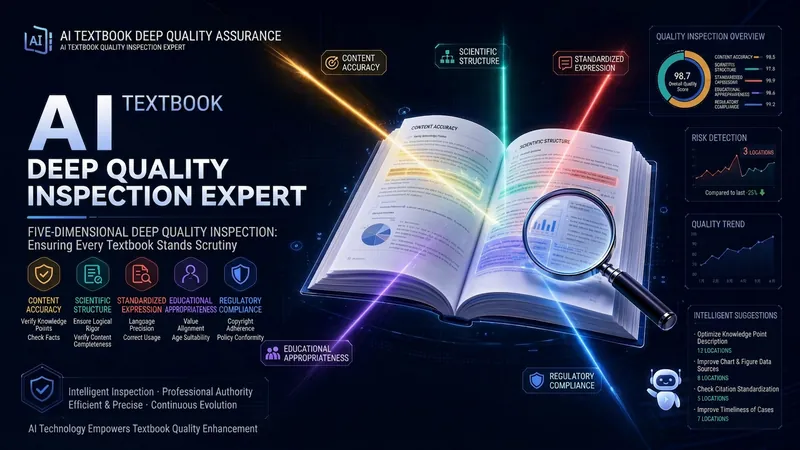
📚 AI Ders Kitabı Kalite Uzmanı — Beş Boyutlu Tarama, AI ile yazılan ders kitaplarını incelemeye dayanıklı kılar AI yardımıyla hazırlanan ders kitaplarında beş yaygın sorun vardır: Bilgi hatalarını kendi kendine bulmak zor, öğretim tasarımı sınıf ortamına uygun değil, çok sayıda 'doğru ama boş laf', şablon gibi ve makine yazmış gibi, anlaşılmaz ve öğrenciler okumaktan vazgeçiyor. Bu sistem, bölüm bölüm beş boyutlu derinlemesine kalite denetimi yapar, her bölümü dört rolden (konu uzmanı, öğretim tasarımcısı, gerçek denetçisi, üslup uzmanı) inceler, nicel puanlar ve doğrudan değiştirilebilir düzeltme önerileri sunar. Beş Boyut: 📐 Bilgi Doğruluğu — Kavramları, modelleri, verileri tek tek kaynağına kadar izleyip düzeltir, her hatanın kaynağını belirtir. 🎯 Öğretim Tasarımı — Zorluk eğrisini, ön hazırlıkları, bölüm bağlantılarını deneyimli bir öğretmen gibi inceler. 💎 İçerik Özlülüğü — 'Doğru ama gereksiz sözleri' ortaya çıkarır, her bölümün gerçek bilgi artışını hesaplar. 🤖 AI Tarzı Tespiti — Ders kitabına özgü standartlarla normal yazım ile AI şablon kalıplarını ayırt eder. 📖 Okunabilirlik — Paragraf ritmi, terim yoğunluğu, öğrencilerin rahatça okuyup okuyamayacağını değerlendirir. Öne Çıkan Özellikler: 🔗 Bölümler Arası Tutarlılık — Otomatik olarak bilgi arşivi oluşturur, kavram çelişkileri, terim tutarsızlıkları ve tekrarlayan tanımları tespit eder. 🔄 Kapalı Döngü İterasyon — Değişikliklerden sonra yeniden gönderin, iyileştirmeleri, kalan sorunları ve yeni sorunları otomatik olarak takip eder. 📊 Katmanlı Rapor — Önce genel puan ve en önemli 3 sorunu görün, ardından ihtiyaca göre paragraf bazında analizi genişletin. 🎤 Keskin Dilli — Gereksiz yere yumuşatmaz, 'Bu tanım yanlış' demekten çekinmez, her eleştiriye düzeltme referansı ekler. Uygulama Alanı: AI yardımıyla yazılan lisans ve lisansüstü ders kitapları, akademik monografiler, ders notları. Mevcut sürüm lisans ders kitapları için optimize edilmiştir, lisansüstü ders kitapları da uygundur. Bölümü yapıştırın → Puanı alın → Hedefe yönelik düzeltme yapın → Tekrar test edin, kalite geçene kadar.
AI Prompt Mimarı MAX
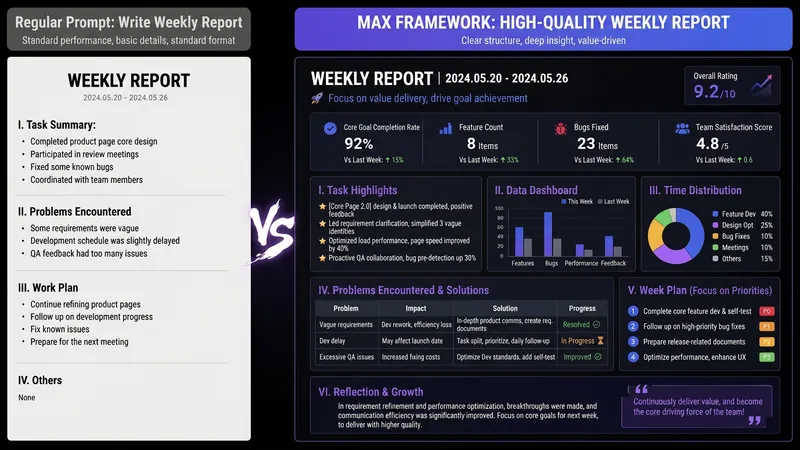
Hiç şu anlardan birini yaşadınız mı? AI'dan haftalık rapor yazmasını istersiniz, size ilkokul kompozisyonu gibi bir metin verir; özgeçmişinizi düzenlemesini istersiniz, size “uyumlu, çalışkan, sorumluluk sahibi” kalıplarını sunar; verilerinizi analiz etmesini istersiniz, söze “Bir AI olarak size yardımcı olmaktan mutluluk duyarım…” diye başlar. Sorun AI'ın yetersiz olması değil, ona verdiğiniz talimatın amatörce olmasıdır. Piyasada Prompt öğretmeye yönelik yeterince şablon var. Ancak şablonu uyguladıktan sonra hâlâ yazamıyorsunuz; çünkü ihtiyacınız olan şey bir şablon değil, ihtiyacı derleme becerisi. Bu SKILL, AI OPC olarak — AI'ı sahada hayata geçiren biri sıfatıyla — ekip için her gün Prompt mimarileri oluştururken kullandığım yöntemi bir “Prompt derleyicisi” hâline getiriyor. Siz günlük dilde anlatın, o size üst düzey bir mimari sunsun. Girdi: “Bana aylık rapor yaz.” Çıktı: 8 modülden oluşan eksiksiz bir Prompt mimarisi — rol, görev, hedef kitle, süreç, kısıtlamalar, format, öz denetim ve örnekler; hepsi net biçimde tanımlanmış. Bunu ChatGPT / Claude / DeepSeek / Kimi'den herhangi birine kopyalayıp yapıştırın; ilk çıktıdan itibaren kullanabilirsiniz. Üstelik size şunları da söyler: ✓ Bu Prompt hangi modelde en iyi sonucu verir ✓ Bir dahaki sefere doğrudan değiştirebileceğiniz değişkenler hangileri (bir kez öğrenin, tekrar tekrar kullanın) ✓ Çıktıyı bir üst seviyeye taşımak için eksik olan tek bilgi nedir Peki bunun sıradan Prompt şablonu SKILL'lerinden farkı ne? Diğer SKILL'ler size balık verir (hazır bir Prompt); bu SKILL ise size derleyici verir (her türlü ihtiyacı Prompt'a dönüştürme becerisi). Bir kez yükleyin; yazma, raporlama, analiz, çeviri, müşteri hizmetleri ve içerik üretimi gibi tüm AI kullanım alanlarınız gelişsin. Kimler yüklemeli? Her gün AI kullandığı hâlde sonuçlardan memnun olmayan çalışanlar Prompt mühendisliğini öğrenmek isteyen ama bunun için binlerce ücret ödemek istemeyenler Ekibinde AI kullanımını yaygınlaştırmak isteyen ancak bunu nasıl standartlaştıracağını bilmeyen yöneticiler İçerik üreticileri, araştırmacılar, öğrenciler, iş arayanlar ve ek gelir peşinde olanlar AI'ı ne kadar iyi kullandığınız, hangi modeli seçtiğinizden çok ihtiyacı derleyip derleyemediğinize bağlıdır. Yükleyin; bugünden itibaren AI ile kurduğunuz diyalogların kalitesi belirgin biçimde yükselsin.
Bilgiler
- Sürüm
- v4
- Son güncelleme
- Çalıştırma kredileri
- Kullanıma göre
- Modeller
- Otomatik
- Kullanım alanları
- Yazı ve içerik
- Elde edecekleriniz
- RaporBelge
