Анти-ШІ редактор
Зменшення ознак AI на основі досліджень
Попередній перегляд
Опис
Спеціалізований Skill lieflat-less-ai-tone ізрахованого на базі двох раундів реальних випробувань корпусу (понад 1169 матеріалів, близько 5,2 млн символів, понад 100 показників та близько 500 тисяч семантичних оцінок моделі), що має понад 7,3 тисячі зірок на GitHub. Цей Skill базується на експериментах із даними задля кількісної оцінки «штучності» тексту: перший раунд охоплював 629 статей, другий — 540 парних статей. Усі разом це 1169 матеріалів і 5,2 мільйона символів. Skill розбиває поняття «штучного стилю» на понад 100 критеріїв, перевіряючи текст скриптами, семантичним аналізом великої моделі та сліпим експертним тестуванням (виконано 507 тисяч пореченневих та поабзацних перевірок) із подальшою масовою ручною перевіркою. Усе це реалізовано у форматі зручного для використання Skill в рамках проєкту lieflat-less-ai-tone. Skill спершу надає звіт про перевірку з показниками, орієнтирами дослідження, оригінальними прикладами та порадами щодо правок, а після вашої відповіді виконує переписування та повторний аналіз.
Рекомендовано
Dancang
Чому нам подобається ця навичка
Створено на основі масштабного корпусу порівняльних даних і багаторазових семантичних тестів: спочатку виявляє та пояснює маркери, після підтвердження мінімально переписує текст і проводить повторний тест, захищаючи факти, стиль і структуру оригінального тексту без випадкового видалення слів за словником.
Кому підійде
Підходить для авторів, які хочуть зменшити ознаки штучного інтелекту в тексті, зберігаючи початковий зміст, факти та структуру.
Як використовувати цей Skill
Надайте вхідні дані
Надайте статтю або текст для перевірки, за бажанням зазначивши фокус уваги.
Запустіть Skill
Спочатку аналізує текст на ознаки штучного інтелекту та надає звіт із прикладами і методами виправлення; після підтвердження текст мінімально переписується та перевіряється знову.
Перевірте результат
Отримайте звіт про перевірку до редагування, змінений текст і результати порівняння.
Схожі навички
Переглянути всі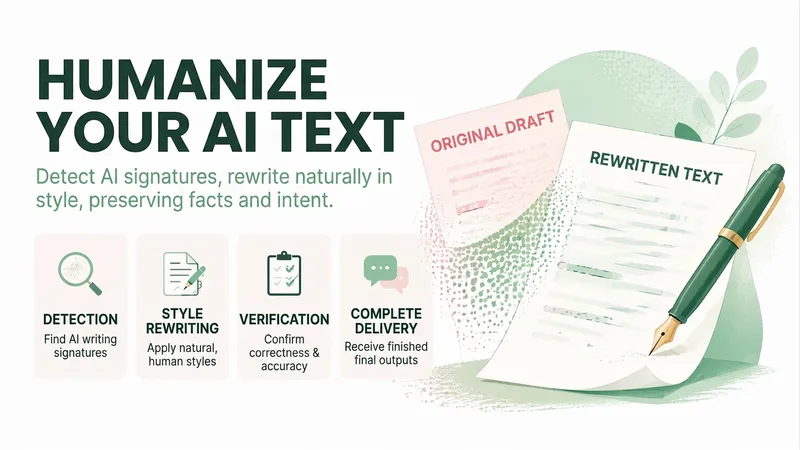 Письмо
Редакція проти AI-стилю
Зробіть китайські тексти схожими на написані реалю людиною для певного контексту, зберігаючи оригінальні факти, позицію та силу тону. Для повідомлень у WeChat, листів, Xiaohongshu, звітів чи наукових робіт — спочатку визначає стиль і проблеми вираження, а потім цілеспрямовано очищує від штампів, порожніх фраз, механічних структур, номінативних конструкцій та невідповідного тону, роблячи текст конкретнішим, природнішим та плавним без зайвої розмовності. Під час редагування суворо дотримуються межі фактів: без самовільного додавання чисел, дат, імен, установ, прикладів, обіцянок чи результатів, «можливо» не замінюється на «обов'язково», а ключові обмеження та висновки не видаляються. У разі нестачі важливої інформації в оригіналі ставляться чіткі позначки для доповнення, щоб уникнути вигадування деталей заради повноти; офіційні наукові та звітні висловлювання не сприймаються помилково за «AI-сліди» для навмисного спрощення. Ви отримаєте перевірений на факти та двокроково перевірений результат китайською мовою, готовий до спілкування, публікації, звітів чи академічного письма. За потреби можна також переглянути детальний аналіз слідів, обґрунтування змін і відсутню інформацію, щоб чітко розуміти, що саме було змінено і як забезпечено збереження початкової інформації.
Глибокий аналіз AI-підручників
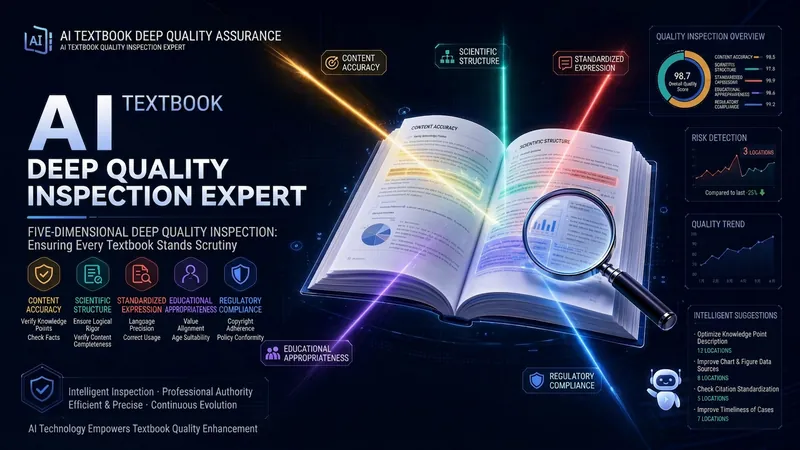
📚 Глибокий аналіз AI-підручників — п'ятивимірна перевірка, щоб AI-підручники витримували рецензію AI-підручники мають п'ять типових проблем: важко самостійно виявити помилки, брак відчуття уроку в педагогічному дизайні, багато «правильних але порожніх слів», шаблонність, ніби написано машиною, складно і незрозуміло, студенти кидають читати. Система проводить п'ятивимірну глибоку перевірку кожного розділу, розглядаючи його з чотирьох ролей: експерт з дисципліни, педагогічний дизайнер, фактчекер, стилістичний аналітик. Видає кількісні оцінки та рекомендації з виправленнями, які можна безпосередньо замінити. П'ять вимірів: 📐 Точність знань — виправлення концепцій, моделей, даних з посиланням на джерела кожної помилки 🎯 Педагогічний дизайн — крива складності, попереднє підґрунтя, зв'язки між розділами, оцінка як досвідченим викладачем 💎 Змістовність — виявлення «правильних порожніх слів», обчислення реального приросту інформації в кожному розділі 🤖 Виявлення AI-стилю — стандарти для підручників, розрізнення нормального написання та шаблонів AI 📖 Читабельність — ритм абзаців, щільність термінів, оцінка чи зможе студент прочитати без труднощів Ключові функції: 🔗 Міжроздільна узгодженість — автоматичне створення бази знань, виявлення суперечностей, невідповідності термінів, повторюваних визначень 🔄 Замкнутий цикл — після виправлень повторне подання, автоматичне відстеження покращень, залишкових проблем, нових питань 📊 Багаторівневий звіт — спочатку загальна оцінка + ТОП-3 проблеми, потім детальний аналіз за потребою 🎤 Гострота висловлювань — не прикрашає, чітко каже «це визначення неправильне», кожна критика супроводжується варіантом виправлення Застосування: підручники для бакалаврату та магістратури, написані за допомогою AI, академічні монографії, конспекти лекцій. Поточна версія оптимізована для підручників бакалаврату, але підходить і для магістратури. Вставте розділ → отримайте оцінку → цілеспрямовано виправте → повторно перевірте, доки якість не стане задовільною.
AI-архітектор промптів MAX
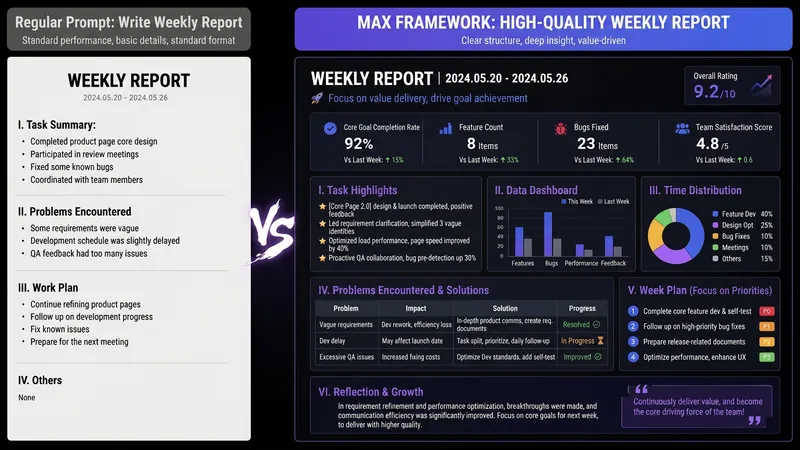
Чи траплялося вам таке? Просите AI написати щотижневий звіт — і отримуєте шкільний переказ. Просите відредагувати резюме — і бачите набір кліше на кшталт «командний, працьовитий, відповідальний». Просите допомогти проаналізувати дані — а відповідь починається зі слів: «Як AI, я радий вам допомогти…» Річ не в тому, що AI не впорається, а в тому, що ви даєте йому надто непрофесійні інструкції. Шаблонів для вивчення Prompt уже достатньо, але навіть після їх використання ви все одно не вмієте писати промпти — бо вам бракує не шаблону, а вміння компілювати потреби. Цей SKILL — результат моєї роботи як AI OPC (фахівця, який безпосередньо впроваджує AI). Він стискає методологію побудови Prompt для команд у повсякденній роботі до одного «компілятора Prompt». Ви формулюєте запит звичайними словами — він створює професійну архітектуру. Введіть: «Допоможи написати місячний звіт». На виході отримаєте повну архітектуру Prompt із 8 модулів — роль, завдання, аудиторія, процес, обмеження, формат, самоперевірка та приклади: усе чітко зафіксовано. Скопіюйте її в ChatGPT / Claude / DeepSeek / Kimi — і вже перший результат можна буде використовувати. Ба більше, він також підкаже: ✓ яка модель найкраще підійде для цього Prompt; ✓ які змінні можна буде безпосередньо змінювати наступного разу (вивчили один раз — використовуйте знову й знову); ✓ якої ще однієї деталі бракує, щоб підняти результат на новий рівень. Чим цей SKILL відрізняється від звичайного SKILL із шаблонами Prompt? Інші SKILL дають вам рибу — готовий Prompt. Цей SKILL дає вам компілятор — здатність перетворювати будь-яку потребу на Prompt. Встановіть його один раз — і всі ваші сценарії використання AI покращаться: написання текстів, звіти, аналіз, переклад, робота з клієнтами, творчі завдання — усе в одному інструменті. Кому варто його встановити: Людям, які щодня користуються AI, але щоразу незадоволені результатом Тим, хто хоче вивчити Prompt engineering, але не хоче витрачати тисячі на курси Керівникам, які прагнуть впровадити AI в команді, але не знають, як стандартизувати процес Творцям контенту, дослідникам, студентам, шукачам роботи та тим, хто розвиває власні проєкти Якість роботи з AI залежить не від того, яку модель ви використовуєте, а від того, чи вмієте ви компілювати потреби. Встановіть його — і вже сьогодні якість ваших діалогів з AI помітно вийде на новий рівень.
Інформація
- Версія
- v4
- Останнє оновлення
- Кредити за запуск
- За фактичним використанням
- Моделі
- Автоматично
- Сценарії використання
- Тексти та контент
- Що ви отримаєте
- ЗвітДокумент
