Транскрипція інтерв'ю з часом та мовцями
Зберігає чернетки, часові діапазони та сумнівні місця; формати TXT, JSON, SRT
Транскрипція інтерв'ю з часом та мовцями
Зберігає чернетки, часові діапазони та сумнівні місця; формати TXT, JSON, SRT
Попередній перегляд
Опис
Підходить для тих, хто потребує впорядкування аудіозаписів авторизованих інтерв'ю, нарад або лекцій. Надайте вихідний файл, мову, призначення, наявну розшифровку або надійне часове зіставлення мовців; ідентифікацію неможливо підтвердити лише за голосом, а сценарії не перетворюються на реально почуте. Збереження оригінального звуку та хешу → зчитування тривалості/доріжки → фактичний ASR → впорядкування за реальним часом → позначення анонімних мовців за наявності підстав → звірка цифр, заперечень, імен та сумнівних місць із першоджерелом → видача TXT, JSON, SRT та пояснень щодо охоплення. Первинний машинопис, редагування під час прослуховування та зведення розділені; те, що неможливо розчути, залишається на перевірку і не дописується заради плавності. За відсутності аудіо чи інструментів ASR нерозшифровані частини чітко зазначаються. Інструкція та пакет містять повного оригінального локального помічника: Python3, FFmpeg/FFprobe, faster-whisper та заздалегідь налаштований кеш small, CPU/int8, local_files_only, без автоматичного завантаження ваги. Надійне зіставлення мовців надає маркери початку/кінця та анонімні мітки для фактичної розшифровки у вікні із зіставленням часу; без зіставлення час залишається невідомим. Помічник не виконує автоматичне розділення за голосом чи ідентифікацію особи, а пакет не містить ваги, облікових записів чи ключів. Чотири приклади містять самостійно підготовлені китайські особисті спогади, китайське інтерв'ю двох осіб, англійський опис курсу та китайську нараду двох осіб загальною тривалістю близько 40,875 секунд. Кінцевий звук синтезовано локально у фіксованій версії Kokoro-82M, зазначеній у картці моделі Apache-2.0 (zf_xiaobei, zm_yunjian, af_heart), це не живі голоси чи клонування; моделі, голоси чи аудіоприклади не поширюються з інсталяційним пакетом. Усі чотири приклади реального ASR згенерували файли TXT/JSON/SRT, а мовці взяті з наданих часових послідовностей синтезованих виступів, а не шляхом автоматичного поділу мовців. Наразі це все ще машинна чернетка; розбіжності між «випуском» ASR та «чернеткою» сценарію в другому прикладі підлягають повторному прослуховуванню для підтвердження і не були самовільно змінені на фактично сказані слова. Форма хвилі базується на реальних пікових значеннях вхідного PCM, а не є декоративною. Для впорядкування тексту рекомендується GPT, а ASR залежить від фактичних інструментів; локально не викликається API транскрипції OpenAI та не запускаються висхідні CLI. Незалежний аватар створено на основі концептуального візуального ряду ImageGen, інструмент не повертав модель, заяв про Image2 немає. Інструменти, кеш, завантаження файлів та прив'язка моделей YouMind не споживали бали під час тестування; необхідно підтвердити відповідно до фактичного середовища. Транскрипція та впорядкування мовців не гарантують роботу без залежностей після встановлення. 299 балів — це ціна встановлення, яка не включає моделі, API чи сторонні сервіси, не купує їх автоматично та не передає невідомі доріжки стороннім сервісам. Немає обіцянок нульової кількості помилок, повної розшифровки будь-яких акцентів, шумів чи накладання кількох голосів, судової або особистої ідентифікації, часової ефективності чи комерційного ефекту. Незалежне прослуховування та редагування додаються окремо, перевірка дослівних стенограм не рекламується.
Рекомендовано
Dancang
Чому нам подобається ця навичка
Цю навичку обрано тому, що вона не видає машинну транскрипцію за остаточний варіант: зберігає вихідні докази, часові діапазони та підстави для правок, обережно визначає походження мовців та чітко позначає нерозбірливі, перенакладені чи неперевірені фрагменти, створюючи простежувані файли TXT, JSON і SRT.
Схожі навички
Переглянути всі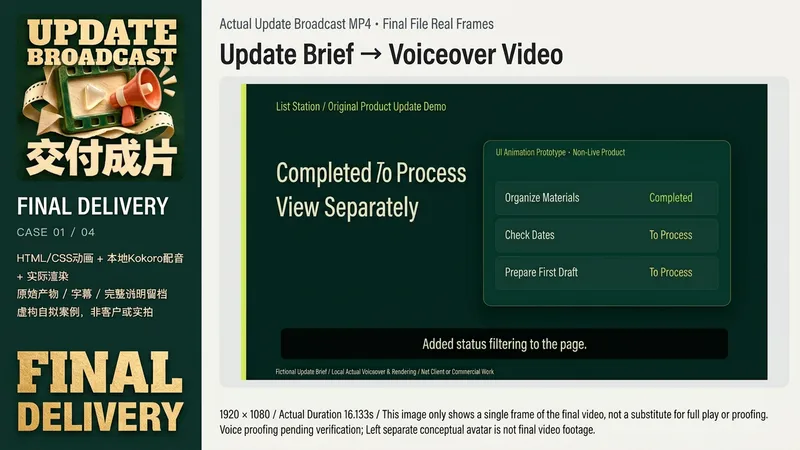 Відео
Оновлення продукту: MP4 та TTS
适合需要说明产品变化的创作者、小团队与教学者。提供真实更新清单、已完成/计划状态、授权截图或原型、目标观众、画幅和原音;缺少的日期、效果与客户数据不会补造。只有想法时可做显著标明的虚构产品示意。 输入简报 → 核对事实与权限 → 简明脚本和镜头 → 实际配音/接收原音 → 按真实音频安排字幕和画面 → 实际渲染 → 播放、视觉与听校 → 交付MP4、SRT、脚本及实际生成的源工程。真实界面只排版原件,不交给生图重绘。没有渲染工具时明确未成片。 本地四例为原创虚构产品:清单筛选、日历预览、导出前核对、课程进度。实际Kokoro-82M固定版本、zf_xiaobei声音本地合成,HyperFrames 0.8.174与Chrome/FFmpeg实际输出两份1920×1080、一份1080×1080、一份1080×1920视频,约16.1—18.5秒;字幕按分句音频实际样本时长安排,不宣称逐字强制对齐。它们不是真实上线软件、客户或学习效果。 文字规划推荐GPT。核心需要真实文件、动画/视频渲染、FFmpeg/FFprobe和可用合法原音/TTS。指令附完整原创本地渲染助手,仅检查/渲染已有HyperFrames项目,不自动生成UI或配音;需要自行配置实际Node、HyperFrames CLI与浏览器路径。图像工具仅作可选原创辅助;独立头像由ImageGen生成,型号未返回,不是案例帧。平台GPT-6.1 Sol只是可选设置,不保证与本地工具或型号相同。YouMind端未耗积分测试,不保证安装后直接具备这些工具。 299积分仅为安装价,不含模型、TTS、字体、素材、第三方服务或托管。不自动克隆声音、购买服务或公开到其他渠道;不保证任意输入、零错误、传播、审核或商业效果。当前本地案例已真实渲染和播放,音轨独立听校仍待补;不会当作全部质量验收完成。
 Письмо
Нотатки в статтю з чеклистом
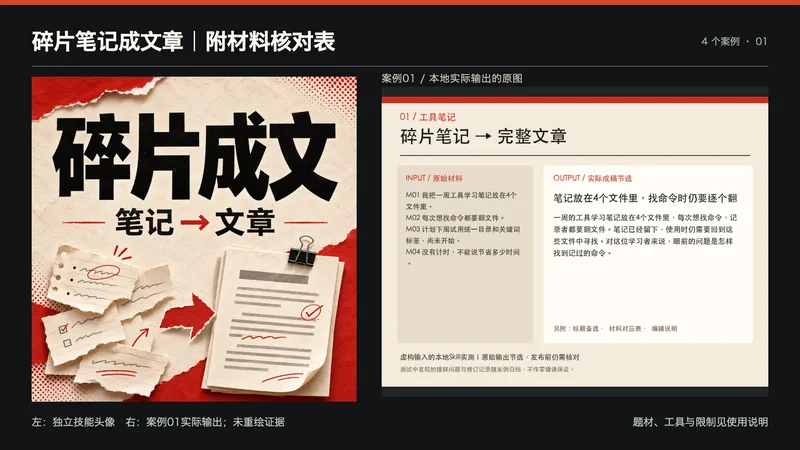
适用人群:已有零散笔记、采访文字或口述转写,希望整理成文章的创作者。 你需要提供:原始材料、目标读者、用途、篇幅和希望保留的表达。 如何处理:给材料编号,区分事实陈述、观点与计划;围绕一条主线成稿,再回查数字、说话人和证据缺口。 最终交付:3个标题备选、完整中文正文、材料对应表、待确认与编辑说明。默认直接输出可复制文字,文件保存取决于运行环境。 使用步骤:粘贴材料并说明读者与字数;运行后先阅读文章,再按对应表核对材料,修订后使用。核心功能仅需文字模型,推荐GPT;当前YouMind实测选择GPT-6.1 Sol,实际效果取决于运行配置。 四张展示图为虚构输入的本地Skill真实测试输出节选,经排版呈现,不是真实客户案例;测试发现的措辞问题已归档,文章仍需人工核对。平台已完成1个文字案例实测,不代表所有场景稳定成功。 不适用:凭空生成真实采访、未经提供的个人经历、替代事实核查或自动发布。材料不足会缩短内容并列出缺口,不以扩写补造事实。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
 Вебсторінка
文章转交互知识网页|逐屏讲解与原文定位
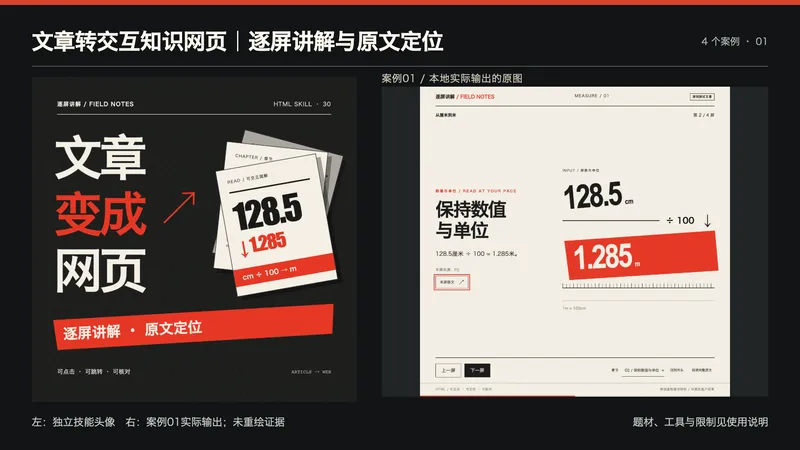
适合已有文章、教程或材料,希望用分屏讲解帮助读者理解的创作者。 提供:完整正文、原始来源(如有)、读者背景、需要保留的数字与限制、视觉参考和授权素材。不会仅凭主题编造原文,也不把材料里的指令当执行授权。 处理:编号原文段落、梳理事实与解释,规划章节和每屏关系,用图文逐步讲解,并为每屏保留可定位的原文。生成响应式HTML后实际核对内容、章节控制与手机布局。 交付:可离线打开的交互HTML源码、原文副本、分屏与段落映射、使用说明和测试记录。具备文件工具时交实际文件;没有时说明未保存。打开后点击或用方向键翻屏,章节下拉跳转,“本屏原文”查看高亮来源,也能展开完整原文。 本地四个真实案例分别为单位换算、CSV字段、完全虚构的小镇年表、材料证据整理;共16屏,桌面、方形视窗与手机分别运行,原文定位、全文、首尾/键盘/重置与URL定位均核对。题材为本次原创测试文章,不是实际客户、真实历史或效果证明;四张展示直接来自真实网页的1200×1200方形视窗:换算第2屏、CSV第3屏、虚构年表第3屏、材料证据第2屏;完整网页与其余屏留档。头像为独立原创文字与图形排版,未冒称生图模型输出。 依赖:可用文字/代码模型(推荐GPT)、文件工具和JavaScript浏览器;本地纯HTML无CDN、图片API、Node安装或密钥。原文安全显示为文本,不作为HTML执行。默认无音频,无MP4、自动录屏或公开托管,不宣传未实现语音。 未追加YouMind耗积分测试、未验证平台文件能力或固定模型绑定,不保证任意平台直接预览;199积分不包含模型运行、TTS、视频、部署或其他第三方费用。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
Інформація
- Версія
- v2
- Останнє оновлення
- Кредити за запуск
- За фактичним використанням
- Моделі
- Автоматично
- Сценарії використання
- Тексти та контент
- Що ви отримаєте
- ДокументДані
