Міська комедія Чжоу Сіньчі
Підказки для комедії на двох платформах
Міська комедія Чжоу Сіньчі
Підказки для комедії на двох платформах
Попередній перегляд
Опис
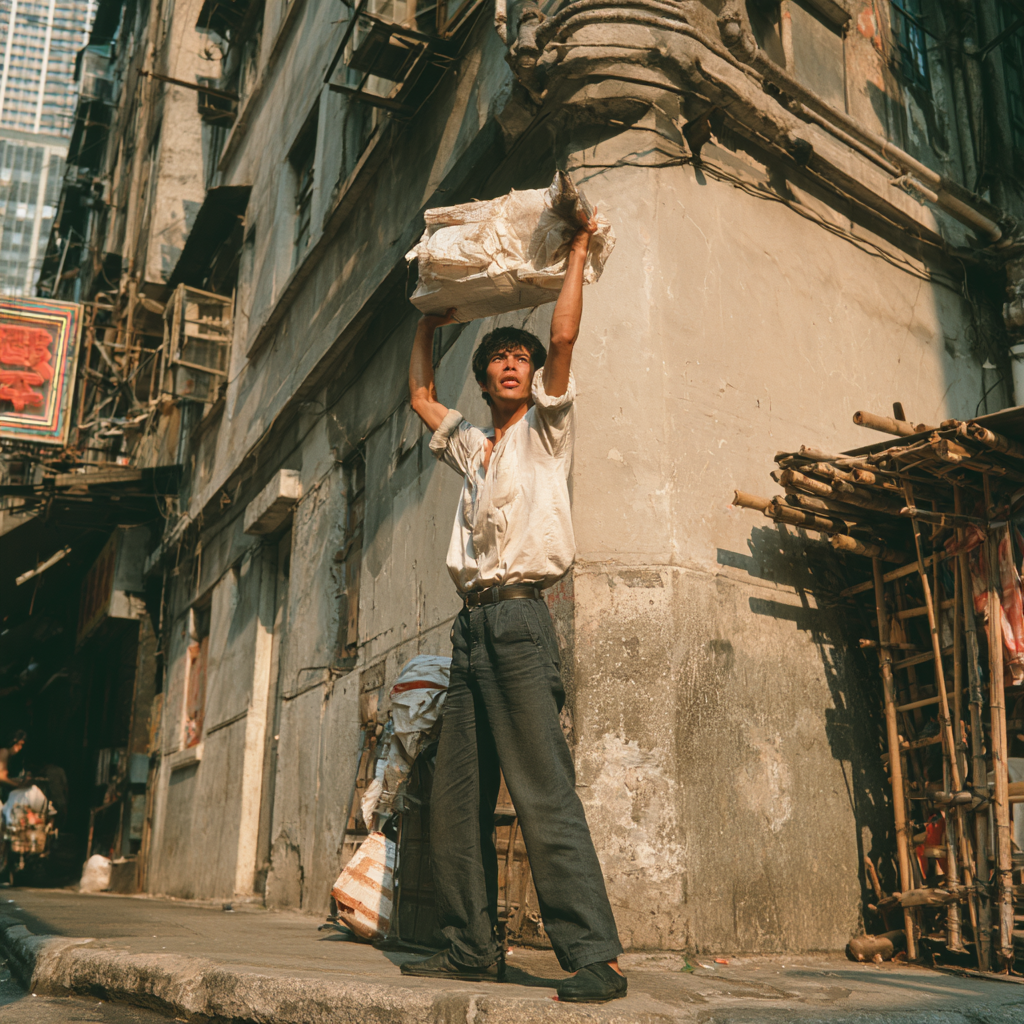
Перетворює коротку ідею кадру або референсне зображення з чітко визначеними ролями на підказки для статичних комедійних сцен у реалістичній манері — для китайського ImageGen та англомовного Midjourney. Навичка зосереджена на яскравих, реалістичних міських просторах із чіткою композицією середнього або загального плану, щоб легко читалися рухи персонажів, поверхні, на які вони спираються, взаємодія з реквізитом і реакції групи. Вона добре підходить для побутового контрасту та перебільшеної, але правдоподібної фізичної гри. Особливо добре передає атмосферу міської комедії в дусі «Кунг-фу», а не двовимірної анімації, наслідування акторами чи химерних деформацій людського тіла. Підказки враховують головний об’єкт, кількість людей, дії, референсних персонажів і вимоги до формату кадру. Вони зберігають звичайну архітектуру, старі стіни, дерев’яні предмети та стримані, але живі побутові кольори, а завдяки повторюваним позам, інтервалам між людьми й легким змінам перспективного масштабу посилюють комедійний ритм. Взаємодії на кшталт обіймів, опори та спостереження з боку мають чіткі зв’язки сил і зрозумілу фізичну структуру, що допомагає уникати злиття персонажів, перетинання реквізиту та спотвореної перспективи. Для одного концептуального зображення, послідовної сцени або перенесення персонажів і композиції з референсу ви отримаєте готові до копіювання підказки для потрібної платформи. Просто вкажіть цільову платформу, щоб отримати відповідну версію.
Рекомендовано
淡苍
Чому нам подобається ця навичка
Перетворює звичайний міський простір на правдоподібну, перебільшену комедію з живими акторами, точно вибудовуючи опору, контакт, групові позиції та перспективу для ImageGen і Midjourney.
Кому підійде
Для творців, які хочуть перетворити ідеї міської комедії з живими акторами на підказки для генерації зображень.
Як використовувати цей Skill
Надайте вхідні дані
Надайте ідею кадру або референсне зображення з чітко визначеними ролями, а також укажіть цільову платформу, кількість людей, дії та формат кадру.
Запустіть Skill
На основі персонажів, дій, просторових зв’язків і композиції референсу сформуємо яскраві, реалістичні та зрозумілі підказки для міської комедії.
Перевірте результат
Отримаєте підказки для статичних зображень, які можна одразу скопіювати й використати на відповідній платформі.
Схожі навички
Переглянути всі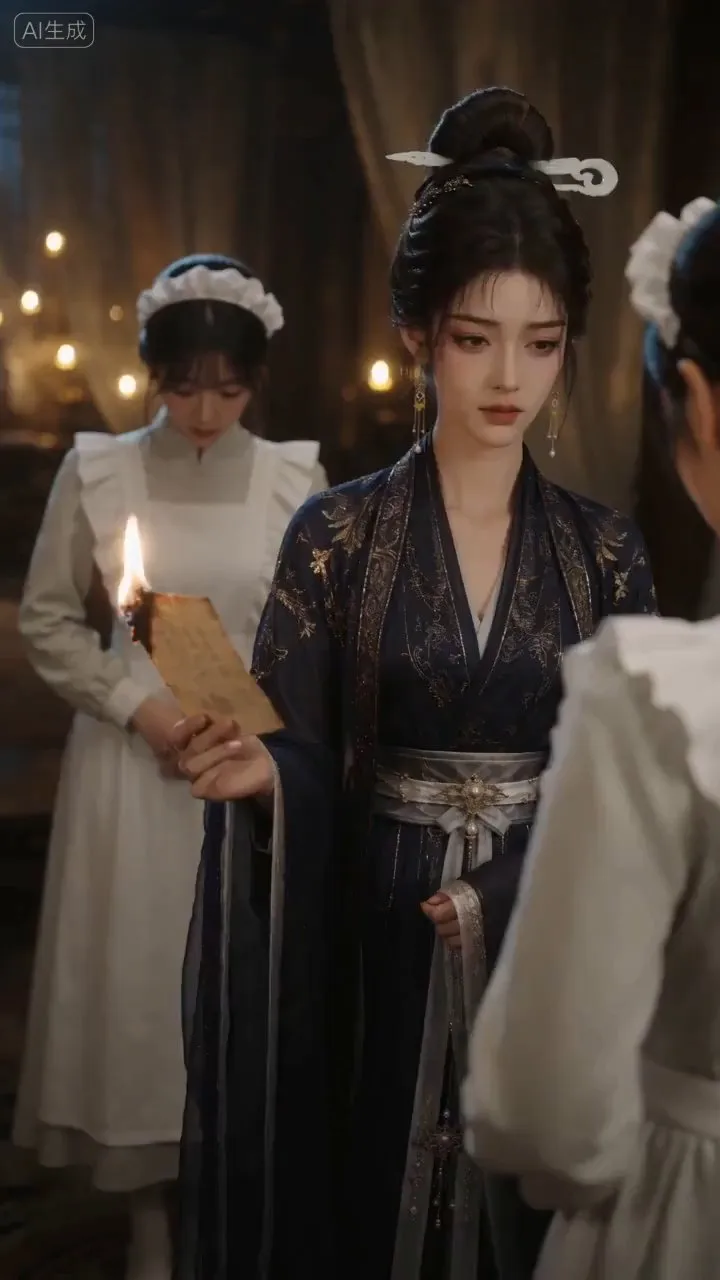
AI-відео та розкадровки
Перетворює сюжет, опис персонажів або наявні промпти для відео на професійну розкадровку короткої драми та готові до використання промпти для окремих кадрів, придатні для генерації AI-відео. Незалежно від того, чи це сучасна історія, костюмована драма, трилер, романтична або драматична сцена, навичка враховує стосунки між персонажами, темп сюжету та емоційні гачки, чітко визначаючи план, положення камери, ракурс, рух камери, композицію, світло й тіні, звуки середовища та репліки. Завдяки цьому кожен кадр має чіткий візуальний акцент і дії, які можна безпосередньо виконати. Навичка особливо зосереджена на послідовності персонажів і безперервності сцен: вона допомагає зафіксувати зовнішність, логіку одягу, статус персонажа та характерні деталі, зменшуючи ризик підміни обличчя, візуального дрейфу, просторової плутанини й нечітких дій під час генерації. Погляд, міміка, дихання, рухи рук і реакції тіла персонажів також перетворюються на видимі зміни у виконанні, посилюючи конфлікт, напруження, несподівані повороти та емоційну динаміку короткої драми. Ви можете почати з повного сюжету або надати наявні матеріали про персонажів, розкадровку чи промпти для цілеспрямованої оптимізації. Якщо образ персонажа вже опрацьований, його можна безпосередньо використати, не створюючи повторно. Зрештою, повний набір кадрів можна впорядкувати у фрагменти тривалістю до 15 секунд, придатні для поетапної генерації в популярних моделях AI-відео, зі збереженням інформації про зображення, звук і тривалість для зручного копіювання та подальшого монтажу.
 Зображення
Вулична мода з прямим спалахом
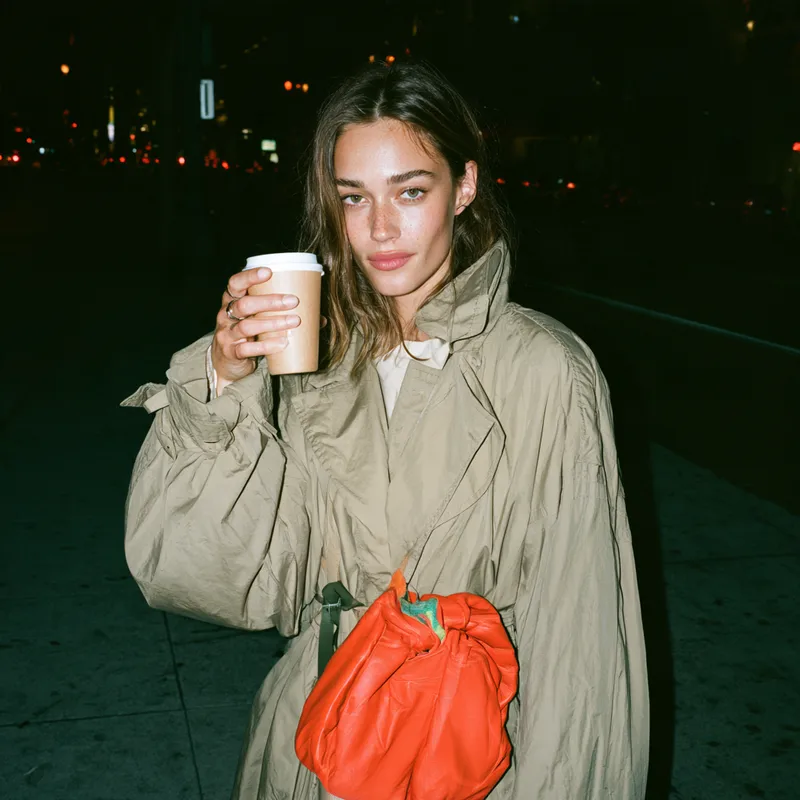
Генерує промпти для зображень вуличної моди, сумок, взуття та інших аксесуарів із відчуттям близького прямого спалаху й живої зйомки. Товари залишаються чіткими та помітними, водночас зберігаються невимушені пози й атмосфера миттєвого кадру в реальному вуличному середовищі. Підходить для фірмового візуального стилю, контенту для соціальних мереж і попередньої генерації концептів моди та аксесуарів — без перетворення зображення на статичну студійну зйомку чи надмірно відретушовану рекламну кампанію. Ви можете надати окремий товар, образ людини або конкретний сценарій використання, а також зазначити колір, матеріал, кількість, спосіб носіння й потрібний формат кадру. Навичка вибудовує композицію навколо фронтального спалаху з близької відстані, коротких жорстких тіней, дещо темнішої, але читабельної експозиції оточення та вуличного тла природного сірого, білого або темно-синього кольору. Композиція адаптується до різних способів взаємодії — у руці, через плече чи на столі, — щоб форму сумки, ручки, підошву взуття та конструкцію одягу було легше розгледіти. За замовчуванням ви отримуєте окремі концепції зображень у форматі 16:9, а також промпти, готові для використання в Midjourney і китайському ImageGen. Якщо потрібен лише один із форматів, його можна згенерувати окремо. Для серій із кількох зображень навичка також може зберігати однакові характеристики товару й візуальний стиль, змінюючи сцени та пози, що підходить для створення цілісної серії зображень вуличної моди.
 Зображення
Промпти азійських портретів
Ця навичка призначена для користувачів, яким потрібно створювати якісні промпти для портретів на платформах генерації зображень за допомогою ШІ. Вона особливо підходить творцям і дизайнерам, які прагнуть передати азійську естетику та створювати зрілі, природні жіночі образи. Навичка перетворює ваші творчі задуми на конкретні, практичні промпти, забезпечуючи привабливий вигляд зображень і сумісність із платформами. Основні функції навички включають створення за вашим описом промптів для різноманітних популярних моделей генерації зображень за допомогою ШІ, зокрема Midjourney, SDXL, Flux, GPT Image, 豆包, 即梦 і ComfyUI. Вона інтелектуально розпізнає та переформульовує потенційно ризиковані слова, щоб вміст промптів відповідав правилам безпеки платформ і не містив виражень, що надають образу дитячих рис, є вульгарними або надмірно акцентують увагу на окремих частинах тіла. Ви також можете за допомогою швидких команд перемикатися між різними стилями зображень: реалістичним селфі, комерційною журнальною зйомкою, преміальним косплеєм, кіберпанком або класичним китайським стилем. Також підтримується виправлення промптів на основі відгуків про невдалу генерацію. Незалежно від того, чи хочете ви створити обкладинку модного журналу, кінематографічний портрет або дизайн 3D CG-персонажа, цей інструмент надасть точні мовні описи та рекомендації щодо параметрів. Готові промпти оптимізуються відповідно до вибраної платформи: для Midjourney генеруються природні плавні довгі речення англійською, для SDXL/Flux — зрозумілі набори позитивних і негативних ключових слів, а для ComfyUI — докладні модульні поля параметрів. Це допоможе ефективно створювати портрети за допомогою ШІ відповідно до ваших очікувань.
Інформація
- Версія
- v2
- Останнє оновлення
- Кредити за запуск
- За фактичним використанням
- Моделі
- Автоматично
- Сценарії використання
- Зображення та дизайн
- Що ви отримаєте
- Промпт