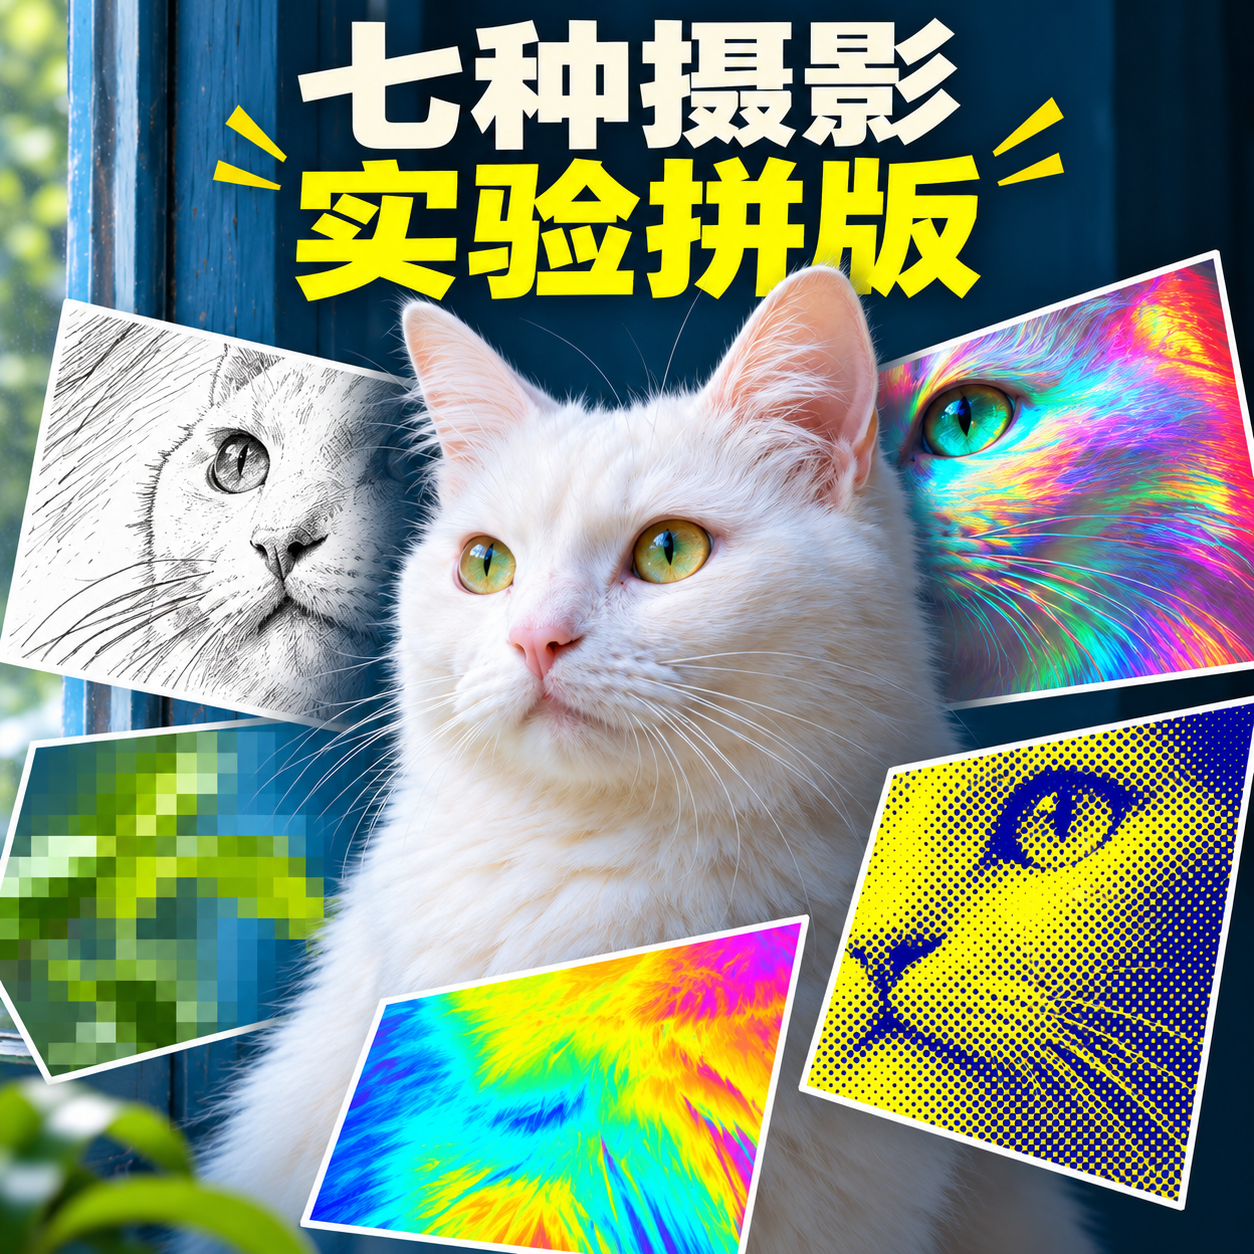
Експериментальний колаж фото
Одна тема й сім карток деталей для порівняння стилів
Експериментальний колаж фото
Одна тема й сім карток деталей для порівняння стилів
Попередній перегляд
Опис
Підходить для творців, які досліджують напрямки фотостилю, створюють візуальні вправи та ілюстрації для контенту. Надайте текстову тему або фотографії, на які маєте права та які можна зчитати, об'єкт, який потрібно зберегти, кольорову гаму та формат; за замовчуванням використовується формат 3:4 з вертикальним диптихом. Верхня частина — природна фотографія, нижня — той самий об'єкт як основа, організований у сім пронумерованих карток деталей-експериментів: 01 тонкі смуги, 02 текстура сірого паперу, 03 чорнильний скетч, 04 блакитно-червоний зсув, 05 піксельні блоки, 06 райдужність, 07 двоколірні растрові точки. Картки збільшують видимі деталі об'єкта для зручного порівняння різних візуальних напрямків; це не фільтри з однаковими координатами для базового зображення і не сім окремих зображень. Навичка перелічує деталі та ефекти для кожної картки, фактично викликає інструменти зображень для генерації, звіряє сім номерів, візуальні відмінності, об'єкт і макет, а потім доопрацьовує відповідно до конкретних питань. Надається фактичний колаж, список ефектів та інструкції з перевірки, за потреби додаються промпти. Якщо інструментів зображень немає, генерація вважається незавершеною. Чотири останні демонстрації — це вигадані приклади штучного інтелекту, повторно згенеровані на основі оновленої навички 12 листопада 2026 року: жінка в навушниках, білий кіт, ваза, аркада; це не реальні знімки, результати обробки клієнтів або алгоритмів. Початкову вимогу щодо вирівнювання за однаковими координатами не було виконано, збережено записи про невдачу та переведено на чіткі картки локальних деталей для повторного запуску чотирьох прикладів. На кожному остаточному зображенні видно сім карток від 01 до 07 з різними ефектами, проте деталі карток, форми квітів, композиція та розмір об'єктів зверху й знизу відрізняються, точна ідентичність або узгодженість структури не гарантується. Довідковий аватар згенеровано незалежно на основі початкового прикладу з білим котом для концептуальної демонстрації, а не як п'ятий окремий приклад чи точна перевірка у семи вікнах. Ефекти візуально симулюються за допомогою моделі зображень, не стверджується застосування семи реальних алгоритмів фільтрації, кількісно вимірюваних параметрів, обробки без втрат або шаруватих редагованих файлів. Для планування тексту рекомендується GPT, а генерація залежить від доступних інструментів створення та редагування зображень. Локально використовується вбудований image_gen, інструмент не повертає конкретний ідентифікатор моделі та не заявляє про прив'язку до Image2. Редагування фото та робота в YouMind практично не тестувалися, тому не гарантується ідентичність, структура товарів, текст чи повна узгодженість між зображеннями. У разі відсутності інструментів зображень чітко зазначається, що генерація не завершена. 299 балів — це вартість встановлення навички, яка не включає плату за моделі платформи чи сторонні сервіси; файли PSD або векторні вихідні файли не надаються, автоматична публікація чи покупка не здійснюються.
Рекомендовано
Dancang
Чому нам подобається ця навичка
Поєднує головний об'єкт із сімома експериментальними ефектами у форматі подвійного диптиха для зручного візуального порівняння.
Кому підійде
Підходить для тих, хто порівнює візуальні напрямки фото, робить візуальні вправи або готує ілюстрації для контенту.
Як використовувати цей Skill
Надайте вхідні дані
Надайте фотографії, до яких маєте права, або текстову тему, а також зазначте головний об'єкт, заголовок, кольорову гаму, формат та призначення.
Запустіть Skill
Система розміщує той самий об'єкт у вигляді верхнього та нижнього диптиха та створює сім пронумерованих карток локальних візуальних експериментів для порівняння.
Перевірте результат
Отримайте одне фактичне зображення-колаж, список із семи ефектів та пояснення до перевірки; генерація завершується лише за наявності інструментів зображень.
Схожі навички
Переглянути всі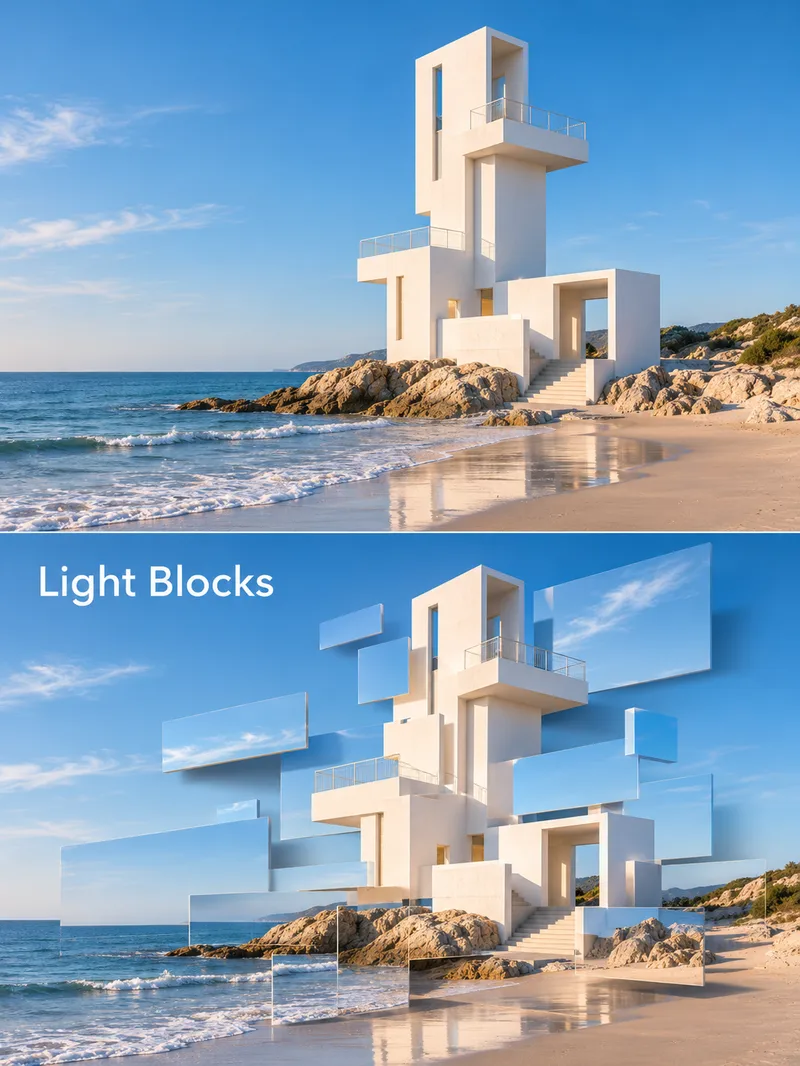 Зображення
Постер у прямокутних фрагментах
Підходить для творців, які створюють візуальні постери з архітектурою, натюрмортами чи портретами. Надайте текстову тему або фото, а також короткий заголовок, палітру, призначення та формат. Навичка спочатку аналізує контур об'єкта та планує двопанельний макет: верхня панель — природне фото, нижня — перетворення частини фото на зсунуті плаваючі прямокутники з акцентом на глибину за допомогою країв, м'яких тіней та перспективи. Для облич обмежується кількість фрагментів. Після виклику інструментів зображення перевіряється компонування. Результат містить готовий постер, заголовок та примітки, за потреби — повний промпт. Використання: опишіть тему й заголовок, перевірте згенероване та внесіть правки. Приклади згенеровані як демонстрація у листопаді 2026 року: біла вежа, жовтий павільйон, червона ваза та портрет. Це не реальні фото чи комерційні проєкти. Працює з інструментами генерації зображень; без них створення не завершиться. Вартість встановлення становить 299 кредитів, без плашок PSD чи векторних файлів.
 Зображення
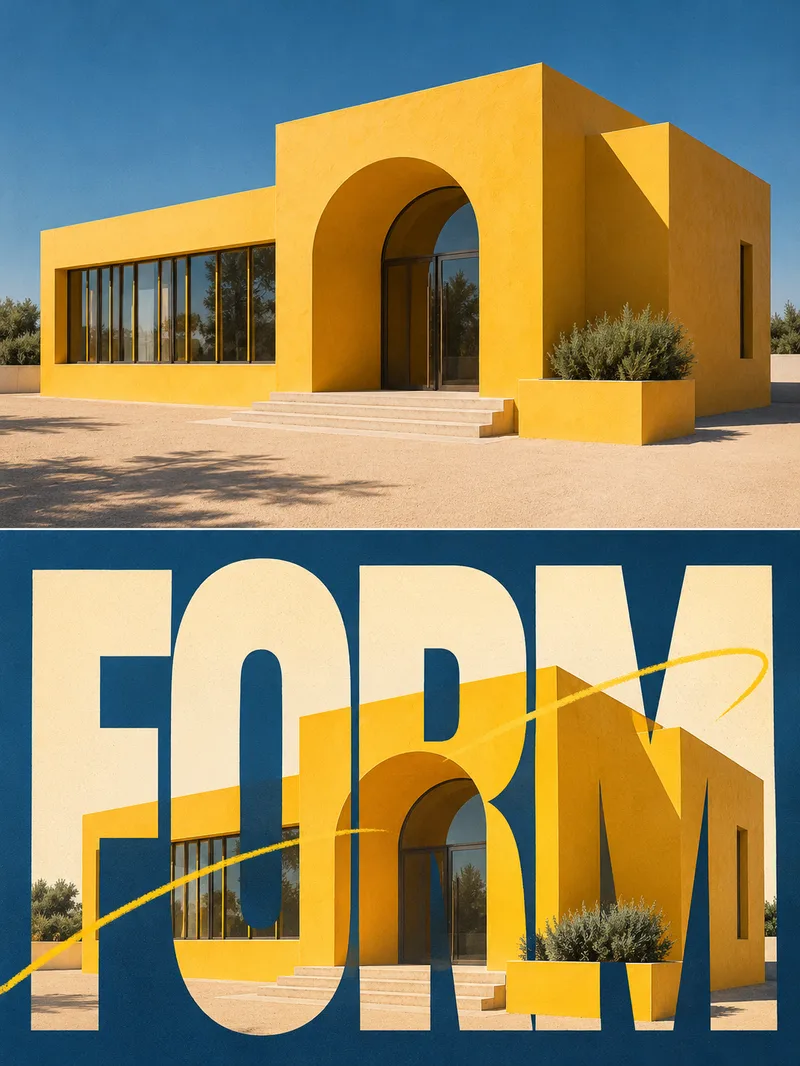
Ретро-плакат з текстом
Підходить для створення соціальних медіа, спортивних тем та редагування плакатів для творців. Надайте текстову тему або фотографію з авторськими правами та можливістю читання, одне коротке англійське слово, кольорову гаму та призначення; люди, домашні тварини та будівлі можуть бути спробними. Навичка спочатку перевіряє об'єкт і реквізит, планує подвійне з'єднання 3:4 зверху вниз: верхня сітка - природна фотографія, нижня сітка використовує величезний ущільнений жирний шрифт для організації зображення, дозволяючи фотографічній текстурі входити в літери, і локальний об'єкт виходить за межі передньої частини слова; з теплою білою паперовою текстурою, фоном основного кольору та невеликою кількістю рухомих ліній, потім викликає фактичні інструменти зображення для генерації та перевірки по черзі. Доставте реальний плакат, копійований заголовок та інструкції з перевірки, а за потреби додайте повну підказку. Використання: поясніть тему, коротке слово та співвідношення сторін; перевірте об'єкт, реквізит, правопис та оклюзію, а потім вкажіть конкретні частини для модифікації. Коли немає інструменту зображення, малюнок не завершено, а підказка не видається за зображення. Чотири дисплеї - це вигадані випадки штучного інтелекту, фактично згенеровані на місці відповідно до остаточного робочого процесу навичок 12 листопада 2026 року: теніс PLAY, золотистий GO, архітектура FORM, танцюрист MOVE, не реальна зйомка, реальний архітектурний запис або ефект клієнта. У чотирьох прикладах є фото-пропуск слів та передній і задній шар об'єкта, маска букви закриє частину тіла або будівлі, місцева постать і текстура змінюються, і дві сітки тенісу різняться по-різному; це не руйнівна обробка фотографій. Довідковий матеріал про аватари генерується окремо від випадків золотистого, квадратний ефектний малюнок з китайським заголовком, не п'ятий незалежний випадок. Планування тексту рекомендує GPT, а для малювання потрібні інструменти генерації/редагування зображень, які фактично доступні в поточному середовищі. Локально використовується вбудований image_gen, конкретний ідентифікатор моделі не повертається, і він не заявляє, що прив'язаний до Image2. Редагування завантажених фотографій та запуск YouMind не тестувалися фактично; ідентичність, структура продукту, текст або міжсіткова повністю не гарантуються; файли PSD або векторні джерела не доставляються. 299 балів - це ціна встановлення навички, яка не включає модель платформи та комісії сторонніх сервісів.
 Зображення
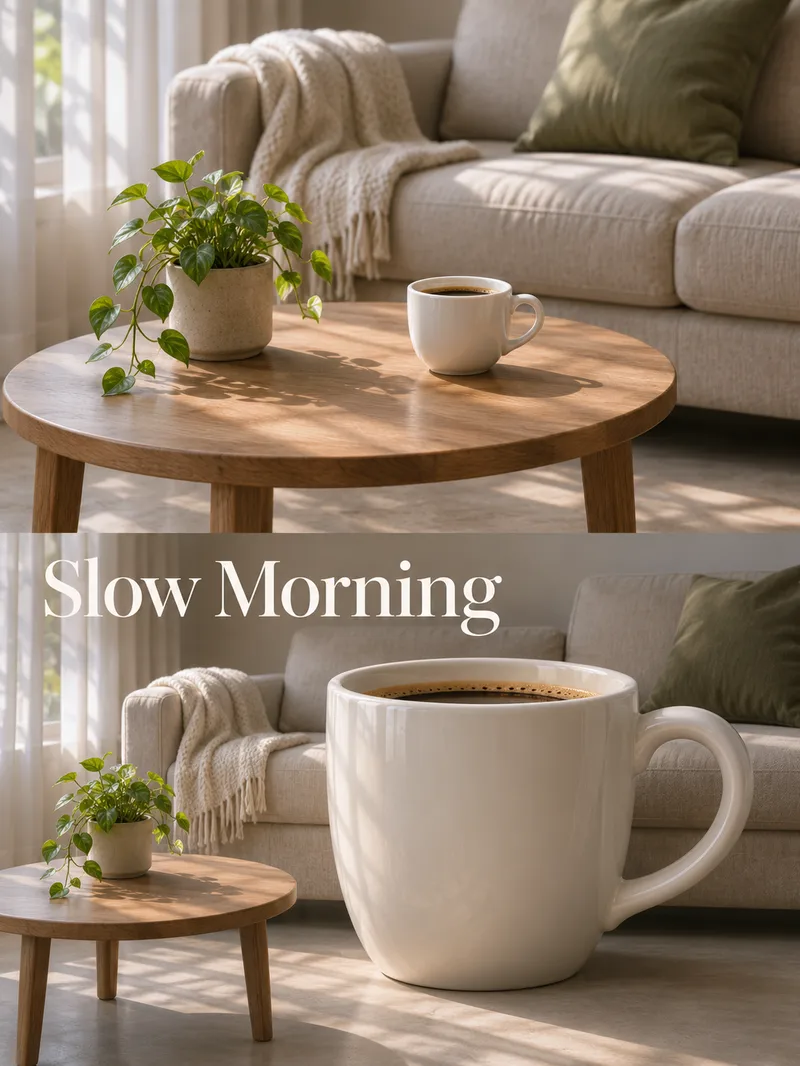
Постери з макрооб'єктами
Підходить для авторів, які хочуть створювати сюрреалістичні зображення для соцмереж, візуальні постери чи креативні вправи. Надайте текстову тему або доступне для читання фото, чітко визначте один об'єкт для збільшення, короткий заголовок, сцену та формат. Якщо не вказано, спершу уточніть головний реквізит, щоб уникнути помилок. На початку налаштовуються оригінальний об'єкт, орієнтир масштабу та напрямок світла, після чого планується вертикальний диптих: у верхній частині — природне фото, у нижній — гіпертрофовано збільшений реквізит із виправленим положенням рук, опорою та тінями, після чого викликається інструмент генерації зображень і проводиться поетапна перевірка. Надається готовий постер, заголовок і пояснення, за потреби — повний промпт. Використання: введіть тему та єдиний об'єкт для збільшення; після генерації перевірте деталі на кшталт рук, ручок чашок чи парасольок, опору та заголовок, а потім внесіть корективи за потреби. Це сюрреалістична творчість, а не реальні розміри чи фотозвіт. Чотири демонстраційні зображення є вигаданими прикладами ШІ, згенерованими локально 12 листопада 2026 року: гігантський апельсин, камера, чашка кави та синя парасолька (це не клієнтські реальні товари чи архітектура). Усі чотири мають помітну різницю в масштабі, хоча пози, деталі камери, меблі та співвідношення сцени можуть відрізнятися; гарантії незмінності кожного пікселя немає. Аватар згенеровано окремо на основі апельсина, текст і картинка розташовані незалежно, це не п'ятий кейс. Для планування тексту рекомендується GPT, а створення зображень залежить від доступних інструментів редагування. Під час локального використання вбудованого image_gen конкретний ID моделі не повертається, зв'язок з Image2 не декларується. Редагування фото та робота в YouMind не тестувалися, тому ідентичність, структура товару чи точність тексту не гарантуються. За відсутності інструментів графіки чітко зазначається, що роботу не завершено. 299 кредитів — це плата за встановлення, без урахування плати за платні моделі чи сторонні сервіси; файли PSD/вектор не надаються, автоматична публікація чи покупка не виконуються.
Інформація
- Версія
- v2
- Останнє оновлення
- Кредити за запуск
- За фактичним використанням
- Моделі
- Автоматично
- Сценарії використання
- Зображення та дизайнНавчання та освіта
- Що ви отримаєте
- ЗвітЗображенняПромпт
- Візуальні стилі
- Колаж
