Chuyển Đổi & Sắp Xếp Bản Ghi Âm
Giữ bản nháp máy, thời gian và điểm nghi vấn; xuất TXT, JSON, SRT
Chuyển Đổi & Sắp Xếp Bản Ghi Âm
Giữ bản nháp máy, thời gian và điểm nghi vấn; xuất TXT, JSON, SRT
Xem trước nội dung
Mô tả
Phù hợp cho những ai cần sắp xếp các bản ghi âm phỏng vấn, cuộc họp hoặc bài giảng được ủy quyền. Cung cấp tệp gốc, ngôn ngữ, mục đích, bản chép lời hiện có hoặc bản đồ thời gian người nói đáng tin cậy; không thể chỉ dựa vào giọng nói để xác nhận danh tính, cũng không coi kịch bản như nội dung thực tế nghe được. Giữ nguyên âm thanh gốc và mã băm -> Đọc thời lượng/bản nhạc -> ASR thực tế -> Sắp xếp theo thời gian thực -> Gắn nhãn người nói ẩn danh khi có căn cứ -> Nghe lại âm thanh gốc để đối chiếu số/từ phủ định/tên người và điểm nghi vấn -> Xuất TXT, JSON, SRT và giải thích phạm vi. Bản nháp máy, bản kiểm tra nghe và bản tóm tắt được tách riêng; giữ nguyên trạng thái chưa rõ nếu không nghe rõ, không tự ý thêm từ cho suôn sẻ. Không có công cụ âm thanh/ASR sẽ ghi rõ là chưa chuyển đổi. Lệnh và gói đi kèm trợ lý cục bộ hoàn chỉnh: Python3, FFmpeg/FFprobe, faster-whisper và bộ nhớ đệm small cấu hình sẵn, CPU/int8, local_files_only, không tự động tải xuống trọng số. Bản đồ người nói đáng tin cậy cung cấp thời gian bắt đầu/kết thúc và nhãn ẩn danh sẽ chuyển đổi theo cửa sổ thực tế và ánh xạ thời gian; khi không có ánh xạ, mốc thời gian sẽ là chưa biết. Trợ lý không tự động tách rời đặc trưng giọng nói hoặc nhận dạng danh tính, gói không bao gồm trọng số/tài khoản/khóa. Bốn ví dụ gồm: lời kể cá nhân tiếng Trung tự biên, phỏng vấn đôi tiếng Trung, mô tả khóa học tiếng Anh, cuộc họp đôi tiếng Trung, tổng âm thanh gốc khoảng 40,875 giây. Âm thanh gốc cuối cùng sử dụng phiên bản cố định Kokoro-82M được đánh dấu trong thẻ mô hình Apache-2.0 để tổng hợp cục bộ, zf_xiaobei, zm_yunjian, af_heart, không phải người thật hoặc nhân bản giọng nói; không phân phối mô hình, giọng nói hoặc âm thanh mẫu cùng gói cài đặt. Cả bốn ví dụ ASR thực tế đều tạo TXT/JSON/SRT, người nói đến từ thời gian phát biểu tổng hợp đã cung cấp, không phải tách người nói tự động. Hiện tại vẫn là bản nháp máy; sự khác biệt giữa "xuất bản thảo" ASR thứ hai và "bản nháp" kịch bản cần được nghe lại để xác nhận, không tự ý đổi thành lời nói thực tế. Dạng sóng đến từ đỉnh PCM đầu vào thực tế, không phải sóng âm trang trí. Nên dùng GPT để sắp xếp văn bản, ASR tuân theo công cụ thực tế; cục bộ không gọi API chuyển đổi OpenAI hoặc chạy CLI thượng nguồn. Hình ảnh đại diện độc lập là hình ảnh trực quan khái niệm ImageGen, công cụ không trả về kiểu máy, không tuyên bố là Image2. Các công cụ, bộ nhớ đệm, tải xuống tệp và liên kết mô hình ở phía YouMind chưa tiêu tốn điểm kiểm tra; cần xác nhận theo môi trường thực tế. Việc chuyển đổi và sắp xếp người nói không đảm bảo chạy không có phụ thuộc sau khi cài đặt. 299 điểm là giá cài đặt, không bao gồm mô hình/API hoặc dịch vụ bên thứ ba, không tự động mua, không tải ngầm các bản nhạc chưa biết lên dịch vụ bổ sung. Không cam kết không có lỗi chính tả, nhận dạng hoàn toàn mọi giọng điệu/tiếng ồn/nhiều người chồng chéo, giám định tư pháp/danh tính, hiệu quả thời gian hoặc hiệu quả thương mại. Việc kiểm tra nghe độc lập sẽ được bổ sung sau, không quảng cáo việc xác minh bản chép lời.
Được đề xuất bởi
Dancang
Vì sao chúng tôi đề xuất kỹ năng này
Tính năng này được chọn vì không mạo nhận bản chuyển đổi của máy là bản hoàn thiện: bảo lưu đầy đủ bằng chứng gốc, khoảng thời gian và căn cứ sửa đổi, phân biệt cẩn thận nguồn gốc người nói, đánh dấu rõ ràng nội dung nghe không rõ, chồng chéo và chưa xác thực để cuối cùng bàn giao TXT, JSON và SRT có thể truy xuất.
Kỹ năng liên quan
Xem tất cả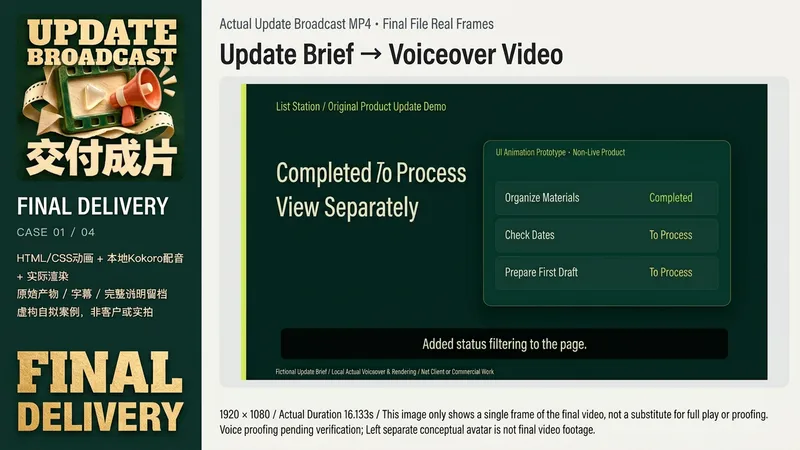 Video
Bản tin cập nhật sản phẩm
Phù hợp cho người sáng tạo, đội ngũ nhỏ và giảng viên cần giải thích các thay đổi của sản phẩm. Cung cấp danh sách cập nhật thực tế, trạng thái hoàn thành hoặc dự kiến, ảnh chụp màn hình hoặc bản mẫu được cấp phép, đối tượng mục tiêu, tỉ lệ khung hình và âm thanh gốc; ngày tháng, hiệu ứng và dữ liệu khách hàng còn thiếu sẽ không bị bịa đặt. Có thể tạo bản minh họa sản phẩm hư cấu được đánh dấu rõ ràng khi chỉ có ý tưởng. Nhập tóm tắt → Đối chiếu sự thật và quyền hạn → Kịch bản và cảnh quay ngắn gọn → Lồng tiếng thực tế hoặc nhận âm thanh gốc → Sắp xếp phụ đề và hình ảnh theo âm thanh thực tế → Kết xuất thực tế → Kiểm tra phát lại, hình ảnh và âm thanh → Giao MP4, SRT, kịch bản và mã nguồn thực tế được tạo. Giao diện thực chỉ sắp xếp bản gốc, không giao cho công cụ tạo ảnh vẽ lại. Nêu rõ chưa hoàn thành video khi thiếu công cụ kết xuất. Bốn ví dụ cục bộ là sản phẩm hư cấu nguyên bản: lọc danh sách, xem trước lịch, đối chiếu trước khi xuất, tiến độ khóa học. Phiên bản cố định thực tế Kokoro-82M, tổng hợp giọng nói zf_xiaobei cục bộ, HyperFrames 0.8.174 và Chrome/FFmpeg xuất thực tế hai video 1920×1080, một video 1080×1080, một video 1080×1920, khoảng 16,1–18,5 giây; phụ đề sắp xếp theo thời lượng mẫu thực tế của âm thanh từng câu, không tuyên bố ép buộc căn chỉnh từng chữ. Chúng không phải là phần mềm, khách hàng hoặc hiệu quả học tập được phát hành thực tế. Khuyên dùng GPT cho việc lập kế hoạch văn bản. Cốt lõi cần tệp thực, kết xuất hoạt họa/video, FFmpeg/FFprobe và âm thanh gốc/TTS hợp pháp có sẵn. Lệnh đi kèm trợ lý kết xuất cục bộ nguyên bản đầy đủ, chỉ kiểm tra/kết xuất dự án HyperFrames hiện có, không tự động tạo giao diện người dùng hoặc lồng tiếng; cần tự cấu hình Node thực tế, HyperFrames CLI và đường dẫn trình duyệt. Công cụ hình ảnh chỉ dùng làm hỗ trợ nguyên bản tùy chọn; ảnh đại diện độc lập do ImageGen tạo, kiểu máy không được trả về, không phải khung hình mẫu. Platform GPT-6.1 Sol chỉ là cài đặt tùy chọn, không đảm bảo giống với công cụ hoặc kiểu máy cục bộ. Kiểm tra YouMind chưa tiêu tốn điểm, không đảm bảo có sẵn các công cụ này ngay sau khi cài đặt. 299 điểm chỉ là giá cài đặt, không bao gồm mô hình, TTS, phông chữ, nguyên liệu, dịch vụ bên thứ ba hoặc lưu trữ. Không tự động nhân bản giọng nói, mua dịch vụ hoặc công bố sang kênh khác; không đảm bảo đầu vào bất kỳ, không lỗi, mức độ lan truyền, kiểm duyệt hoặc hiệu quả thương mại. Các ví dụ cục bộ hiện tại đã được kết xuất và phát thực tế, việc kiểm tra âm thanh độc lập vẫn chờ bổ sung; sẽ không coi là hoàn tất nghiệm thu toàn bộ chất lượng.
 Viết
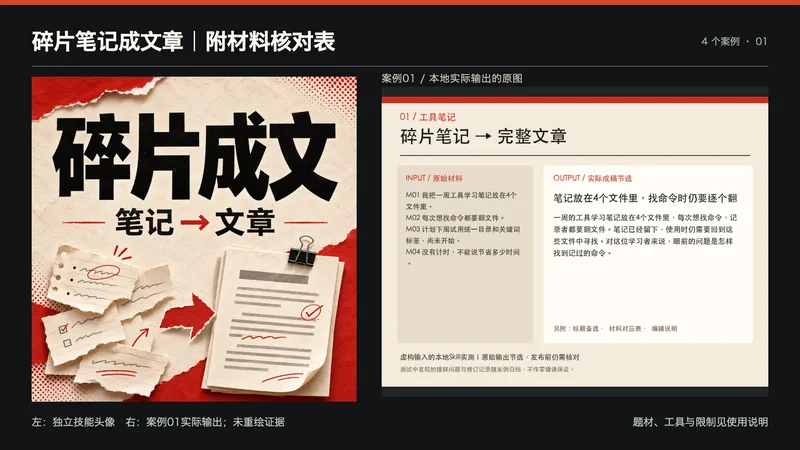
Biên soạn bài viết từ ghi chú
适用人群:已有零散笔记、采访文字或口述转写,希望整理成文章的创作者。 你需要提供:原始材料、目标读者、用途、篇幅和希望保留的表达。 如何处理:给材料编号,区分事实陈述、观点与计划;围绕一条主线成稿,再回查数字、说话人和证据缺口。 最终交付:3个标题备选、完整中文正文、材料对应表、待确认与编辑说明。默认直接输出可复制文字,文件保存取决于运行环境。 使用步骤:粘贴材料并说明读者与字数;运行后先阅读文章,再按对应表核对材料,修订后使用。核心功能仅需文字模型,推荐GPT;当前YouMind实测选择GPT-6.1 Sol,实际效果取决于运行配置。 四张展示图为虚构输入的本地Skill真实测试输出节选,经排版呈现,不是真实客户案例;测试发现的措辞问题已归档,文章仍需人工核对。平台已完成1个文字案例实测,不代表所有场景稳定成功。 不适用:凭空生成真实采访、未经提供的个人经历、替代事实核查或自动发布。材料不足会缩短内容并列出缺口,不以扩写补造事实。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
 Trang web
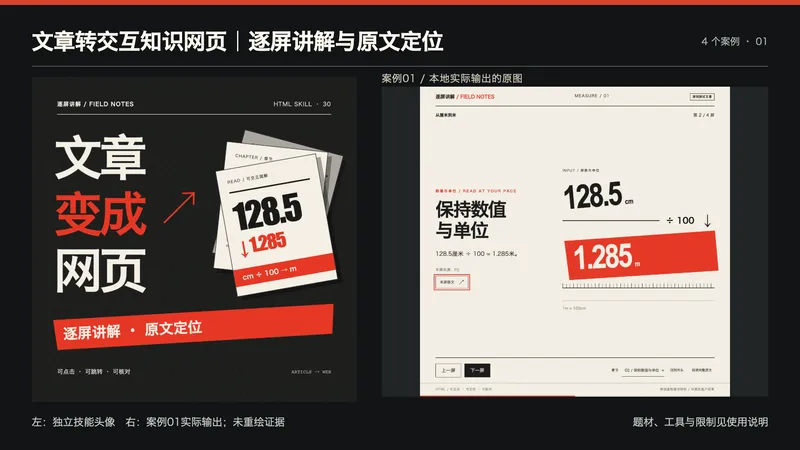
文章转交互知识网页|逐屏讲解与原文定位
适合已有文章、教程或材料,希望用分屏讲解帮助读者理解的创作者。 提供:完整正文、原始来源(如有)、读者背景、需要保留的数字与限制、视觉参考和授权素材。不会仅凭主题编造原文,也不把材料里的指令当执行授权。 处理:编号原文段落、梳理事实与解释,规划章节和每屏关系,用图文逐步讲解,并为每屏保留可定位的原文。生成响应式HTML后实际核对内容、章节控制与手机布局。 交付:可离线打开的交互HTML源码、原文副本、分屏与段落映射、使用说明和测试记录。具备文件工具时交实际文件;没有时说明未保存。打开后点击或用方向键翻屏,章节下拉跳转,“本屏原文”查看高亮来源,也能展开完整原文。 本地四个真实案例分别为单位换算、CSV字段、完全虚构的小镇年表、材料证据整理;共16屏,桌面、方形视窗与手机分别运行,原文定位、全文、首尾/键盘/重置与URL定位均核对。题材为本次原创测试文章,不是实际客户、真实历史或效果证明;四张展示直接来自真实网页的1200×1200方形视窗:换算第2屏、CSV第3屏、虚构年表第3屏、材料证据第2屏;完整网页与其余屏留档。头像为独立原创文字与图形排版,未冒称生图模型输出。 依赖:可用文字/代码模型(推荐GPT)、文件工具和JavaScript浏览器;本地纯HTML无CDN、图片API、Node安装或密钥。原文安全显示为文本,不作为HTML执行。默认无音频,无MP4、自动录屏或公开托管,不宣传未实现语音。 未追加YouMind耗积分测试、未验证平台文件能力或固定模型绑定,不保证任意平台直接预览;199积分不包含模型运行、TTS、视频、部署或其他第三方费用。 展示说明:首张为独立技能头像与案例01实际输出的并排排版,用于横向缩略展示;不是新增案例,也未让生图模型重绘证据。其余三张对应案例02—04。
Thông tin
- Phiên bản
- v2
- Cập nhật lần cuối
- Điểm tín dụng khi chạy
- Theo mức sử dụng
- Mô hình
- Tự động
- Trường hợp sử dụng
- Viết và nội dung
- Kết quả nhận được
- Tài liệuDữ liệu
